
大数据与流处理 / 系统课时
Savepoint 与作业升级
Savepoint 与作业升级
本课完成一次标准的有状态作业升级流程:为算子固定 UID,停止旧作业并生成 Savepoint,从该路径提交新版本,验证状态恢复后再安全清理旧快照。
学习目标
- 能区分 Savepoint 与自动 Checkpoint 的运维职责
- 能通过稳定 UID 保持升级前后的状态映射
- 能执行创建、恢复、验证和清理 Savepoint 的完整流程
明确 Savepoint 的职责
Checkpoint 面向意外故障恢复,通常由 Flink 自动创建和管理;Savepoint 面向计划内操作,由用户触发、保存和删除。升级 JAR、调整并行度、迁移集群或修改作业拓扑时,应先生成 Savepoint,再让新作业从该路径恢复。
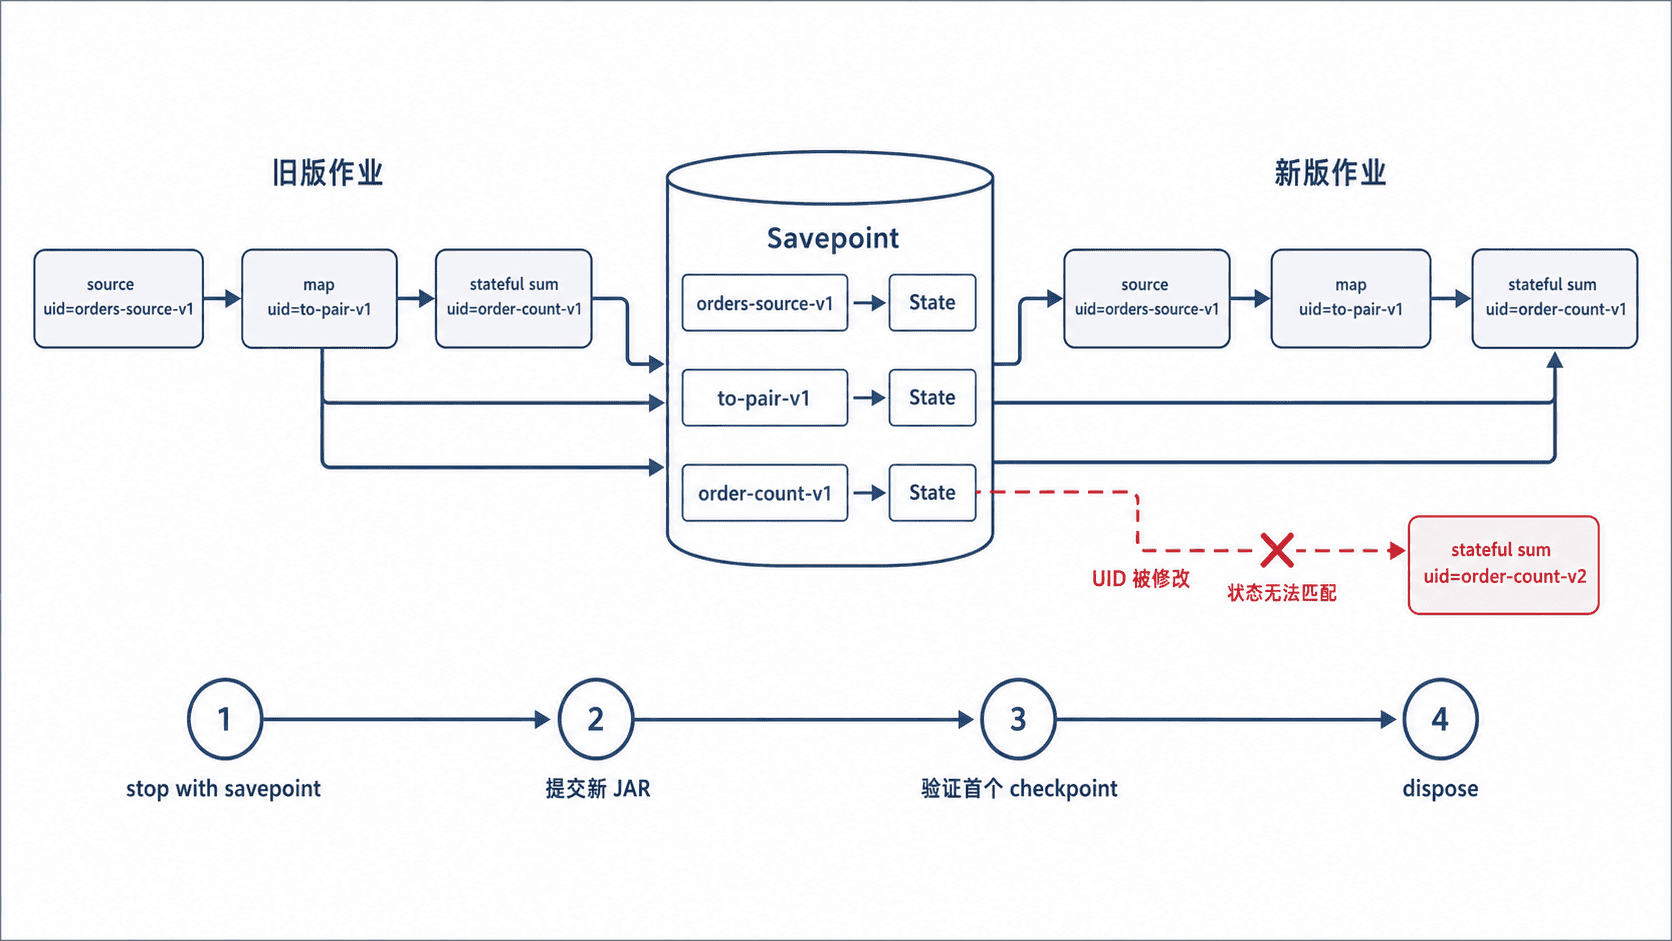
Savepoint 可以理解为一组 Operator UID -> State 映射。新作业中 UID 相同的算子才能接收旧状态;名称 name() 主要用于可读性,真正参与映射的是 uid() 产生的算子标识。
为算子固定 UID
下面的 sum(1) 是有状态算子。示例关闭自动 UID 生成,强制每个实际算子显式指定稳定 UID,从而在开发阶段就发现遗漏,而不是等升级恢复时才失败。
import org.apache.flink.api.common.functions.MapFunction;
import org.apache.flink.api.java.tuple.Tuple2;
import org.apache.flink.streaming.api.datastream.DataStream;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;

public class SavepointUidDemo {
    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env =
                StreamExecutionEnvironment.getExecutionEnvironment();
        env.setParallelism(1);

        // 未设置 uid 的实际算子会导致提交失败,避免升级时依赖脆弱的自动 ID
        env.getConfig().disableAutoGeneratedUIDs();

        DataStream<Tuple2<String, Integer>> counts = env
                .fromElements("apple", "banana", "apple")
                .name("orders-source")
                .uid("orders-source-v1")
                .map(new MapFunction<String, Tuple2<String, Integer>>() {
                    @Override
                    public Tuple2<String, Integer> map(String value) {
                        return Tuple2.of(value, 1);
                    }
                })
                .name("to-pair")
                .uid("to-pair-v1")
                .keyBy(value -> value.f0)
                .sum(1)
                .name("order-count")
                .uid("order-count-v1");

        counts.print()
                .name("console-sink")
                .uid("console-sink-v1");

        env.execute("savepoint-uid-demo");
    }
}
预期输出如下。单并行度下记录按输入顺序处理。
(apple,1)
(banana,1)
(apple,2)
升级时可以修改算子实现,但承接原状态的算子必须保留 UID,并保持状态序列化兼容。即使某个算子看起来无状态,也建议固定 UID,因为窗口、连接器和部分内置算子可能维护内部状态。
执行停止与恢复
计划升级优先使用 stop-with-savepoint:它先生成一致快照,再停止旧作业,能够避免旧作业继续推进而新作业从较早快照启动。将下列 <JOB_ID>、<SAVEPOINT_DIR>、<SAVEPOINT_PATH> 和 <JAR_PATH> 替换为实际值。
bin/flink stop --type canonical --savepointPath <SAVEPOINT_DIR> <JOB_ID>
bin/flink run -s <SAVEPOINT_PATH> <JAR_PATH>
预期结果是第一条命令返回 Savepoint 路径,第二条命令提交一个新的作业 ID。具体前缀和日志格式会随 Flink 版本与部署模式变化。
Savepoint completed. Path: <SAVEPOINT_PATH>
Job has been submitted with JobID <NEW_JOB_ID>
canonical 格式更强调跨状态后端和版本升级的兼容性;native 格式通常创建与恢复更快,但更依赖原状态后端。升级前应根据目标版本、状态后端和回滚方案选择格式,而不是只比较速度。
处理拓扑变化
新增有状态算子通常会以空状态初始化,只要它使用新的 UID 即可。删除有状态算子时,Savepoint 中会留下无法映射的状态,默认恢复应失败。只有明确接受丢弃该状态时,才使用 --allowNonRestoredState 或短参数 -n。
风险提示:
-n会跳过无法映射的状态。若 UID 因误改而不匹配,它也可能把本应恢复的数据当成废弃状态,因此必须先核对新旧作业的 UID 清单并保留原 Savepoint。
调整并行度通常可以从 Savepoint 重新分配 keyed state,但新并行度不能超过算子配置的最大并行度。修改状态字段类型、序列化器或窗口输入类型可能破坏兼容性,应先在独立环境完成恢复测试。
验证后清理 Savepoint
新作业启动成功不等于升级完成。应核对业务计数、消费位点、状态指标和下游幂等性,并等待新作业至少完成一次成功 Checkpoint。默认 NO_CLAIM 恢复模式下,在首个成功 Checkpoint 之前不要删除原 Savepoint,因为故障时仍可能需要它。
确认新作业稳定且回滚窗口结束后,再执行清理。下面命令中的路径必须指向完整 Savepoint 目录或其元数据位置。
bin/flink savepoint -d <SAVEPOINT_PATH>预期结果为客户端确认该 Savepoint 已释放;实际提示文字可能因版本不同而略有差异。
Savepoint <SAVEPOINT_PATH> disposed.不要直接按目录日期批量删除未知快照。应记录 Savepoint 对应的作业版本、创建时间、恢复记录和保留期限,并确认没有作业以 CLAIM 模式或增量文件依赖该快照。