
大数据与流处理 / 系统课时
配置 Checkpoint
配置 Checkpoint
本课完成一套可直接落地的 Checkpoint 配置,覆盖触发周期、超时、最小间隔、并发数量、外部化保留策略与存储目录,并说明如何验证配置是否真正形成可恢复的状态快照。
学习目标
- 能为 DataStream 作业启用并配置周期性 Checkpoint
- 能解释周期、超时、最小间隔与并发数之间的约束
- 能选择合适的外部化策略和共享存储位置
建立配置基线
Checkpoint 由 JobManager 中的协调器周期触发。各算子收到 barrier 后保存状态,所有任务完成快照后,本次 Checkpoint 才会标记为成功。周期决定恢复时最多重放多少数据,超时限制异常快照占用资源的时间,并发数控制同时在途的快照数量。
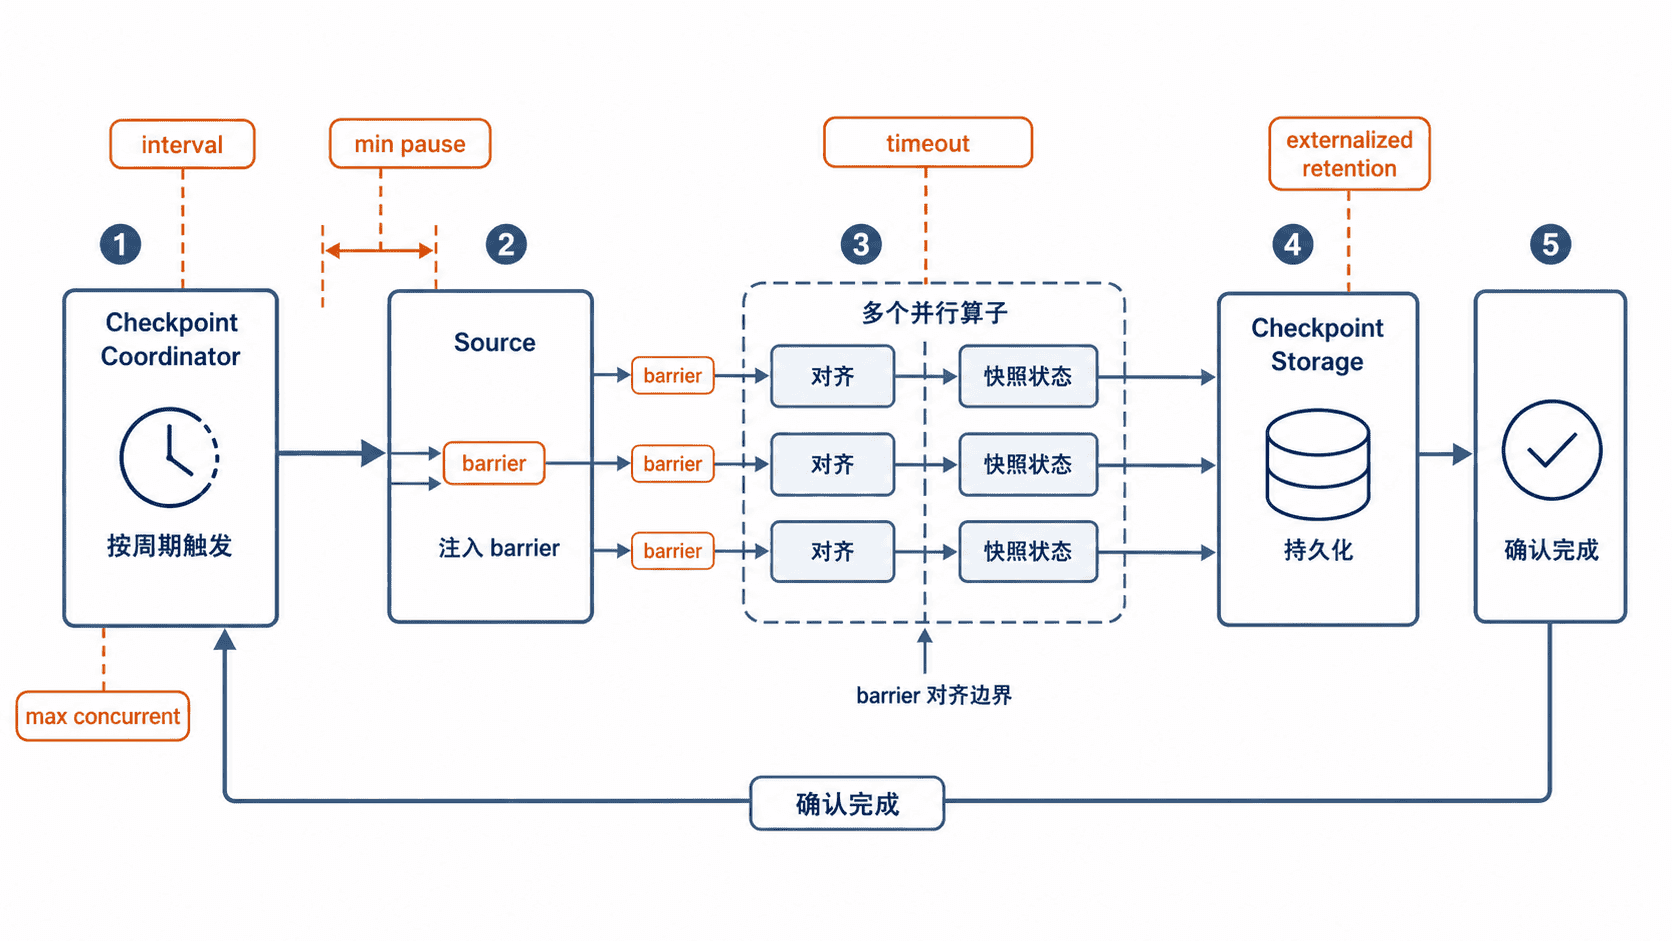
生产环境通常先采用 EXACTLY_ONCE、单并发 Checkpoint 和明确的最小间隔,再根据状态大小与实际耗时调整。周期不应短于大多数 Checkpoint 的完成时间,否则会持续排队或频繁占用网络与存储资源。
编写可运行示例
下面示例适用于已引入 Flink DataStream 依赖的 Java 项目。file:///tmp/flink-checkpoints 只适合单机开发;分布式集群必须替换为所有 JobManager、TaskManager 都能访问的 HDFS、对象存储或共享文件系统 URI。
import org.apache.flink.configuration.ExternalizedCheckpointRetention;
import org.apache.flink.streaming.api.environment.CheckpointConfig;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;

public class CheckpointConfigDemo {
    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env =
                StreamExecutionEnvironment.getExecutionEnvironment();
        env.setParallelism(1);

        // 每 10 秒触发一次,默认使用 exactly-once 一致性语义
        env.enableCheckpointing(10_000L);

        CheckpointConfig config = env.getCheckpointConfig();
        config.setCheckpointTimeout(60_000L);
        config.setMinPauseBetweenCheckpoints(5_000L);
        config.setMaxConcurrentCheckpoints(1);
        config.setTolerableCheckpointFailureNumber(2);

        // 作业被取消后仍保留最近的外部化 Checkpoint
        config.setExternalizedCheckpointRetention(
                ExternalizedCheckpointRetention.RETAIN_ON_CANCELLATION);
        config.setCheckpointStorage("file:///tmp/flink-checkpoints");

        System.out.printf(
                "interval=%dms, timeout=%dms, maxConcurrent=%d, retention=%s%n",
                config.getCheckpointInterval(),
                config.getCheckpointTimeout(),
                config.getMaxConcurrentCheckpoints(),
                config.getExternalizedCheckpointRetention());
        System.out.println("checkpointStorage=file:///tmp/flink-checkpoints");

        env.fromSequence(1, 3)
                .map(value -> value * 10)
                .name("multiply-by-ten")
                .uid("multiply-by-ten")
                .print();

        env.execute("checkpoint-config-demo");
    }
}
预期输出如下。Flink 自身日志、线程信息与时间戳会因运行环境不同而变化。
interval=10000ms, timeout=60000ms, maxConcurrent=1, retention=RETAIN_ON_CANCELLATION
checkpointStorage=file:///tmp/flink-checkpoints
10
20
30
这个有界示例主要验证代码与参数读取。要验证快照文件,应把同样配置用于持续运行的流作业,等待至少一个周期,并确认存储目录中出现作业 ID 目录和已完成的 chk-<ID> 目录。
理解参数如何协同
setCheckpointTimeout 必须明显大于正常完成耗时,否则稍有抖动就会反复过期。setMinPauseBetweenCheckpoints 从上一次完成后开始计时,可防止存储系统持续满负荷。设置最小间隔后,不应再依赖多个重叠 Checkpoint 提升频率。
setMaxConcurrentCheckpoints(1) 是稳妥基线。只有在状态快照耗时较长、存储吞吐充足且确实需要更短恢复点间隔时,才考虑提高并发数。并发越高,在途数据、网络流量和远端小文件压力越大。
RETAIN_ON_CANCELLATION 便于误取消后手工恢复,但也把清理责任交给运维。若使用 DELETE_ON_CANCELLATION,主动取消作业时快照会被删除,更适合不允许遗留状态文件的临时任务。
验证与典型失败处理
验证不能只看作业处于 RUNNING。应确认连续出现成功的 Completed Checkpoint,检查持续时间、对齐时间、状态大小与失败次数,并实际做一次从保留快照恢复的演练。
若一直超时,先比较 Checkpoint 持续时间与超时值,再检查反压、远端存储延迟和状态大小;不要只盲目增大超时。若目录不可写,检查 URI、文件系统插件、凭证以及所有节点的访问权限。若取消后磁盘持续增长,应建立按作业和保留期清理外部化 Checkpoint 的流程。
注意:Checkpoint 目录属于恢复数据,不要在作业仍可能依赖它时手工删除。生产环境也不要使用仅某台机器可见的本地路径,否则故障转移后其他节点无法恢复。