
大数据与流处理 / 系统课时
自定义函数
自定义函数
本课用一个可运行示例完成三类 Flink SQL 自定义函数的开发、注册与调用。完成后,你能够根据“单行变单值、单行变多行、多行聚合成单值”的输入输出关系选择正确函数类型,并避开类型推断、空值和聚合状态设计中的常见问题。
学习目标
- 区分标量函数、表函数和聚合函数的输入输出模型
- 使用
createTemporarySystemFunction注册函数并在 SQL 中调用 - 设计可序列化、可合并且能处理空值的聚合状态
三类函数解决什么问题
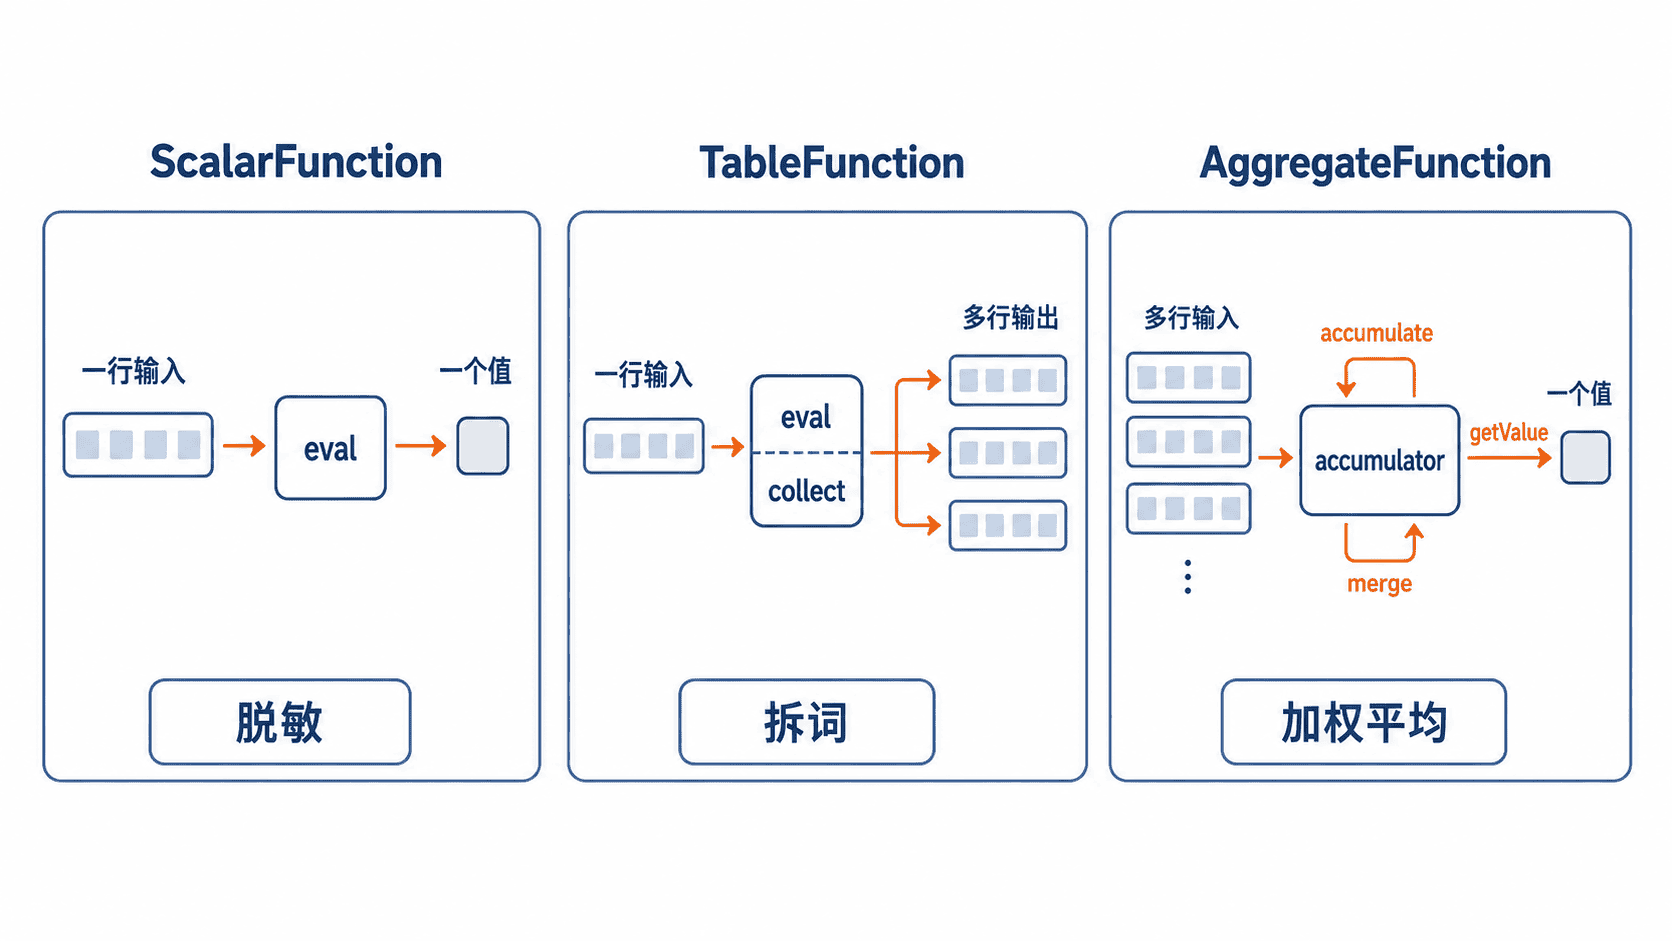
标量函数继承 ScalarFunction,每次接收一行中的若干字段并返回一个值,适合脱敏、格式化和业务规则计算。表函数继承 TableFunction<T>,一次调用可以通过 collect 产生零到多行,适合拆词、展开数组和解析复合字段。聚合函数继承 AggregateFunction<OUT, ACC>,通过累加器保存多行状态,最终输出一个聚合结果。
| 类型 | 输入输出关系 | 核心方法 | SQL 调用方式 |
|---|---|---|---|
| 标量函数 | 一行到一个值 | eval |
普通表达式 |
| 表函数 | 一行到多行 | eval 与 collect |
LATERAL TABLE |
| 聚合函数 | 多行到一个值 | createAccumulator、accumulate、getValue |
聚合表达式 |
开发并注册函数
下面的程序在批模式 TableEnvironment 中注册三个临时系统函数:邮箱脱敏、标签拆词和加权平均。临时系统函数在当前会话内可被所有 Catalog 和数据库引用,程序结束后自动消失,适合应用启动时注册。
package com.example.flink.sql;

import org.apache.flink.table.api.DataTypes;
import org.apache.flink.table.api.EnvironmentSettings;
import org.apache.flink.table.api.Table;
import org.apache.flink.table.api.TableEnvironment;
import org.apache.flink.table.functions.AggregateFunction;
import org.apache.flink.table.functions.ScalarFunction;
import org.apache.flink.table.functions.TableFunction;
import org.apache.flink.types.Row;

public class CustomFunctionsDemo {

    public static class MaskEmail extends ScalarFunction {
        public String eval(String email) {
            if (email == null) {
                return null;
            }
            int at = email.indexOf('@');
            return at <= 1 ? "***" : email.substring(0, 1) + "***" + email.substring(at);
        }
    }

    public static class SplitWords extends TableFunction<String> {
        public void eval(String text) {
            if (text == null || text.isBlank()) {
                return;
            }
            for (String word : text.trim().split("\\s+")) {
                collect(word);
            }
        }
    }

    public static class WeightedAvgAcc {
        public double weightedSum;
        public long weightSum;

        public WeightedAvgAcc() {
        }
    }

    public static class WeightedAvg
            extends AggregateFunction<Double, WeightedAvgAcc> {

        @Override
        public WeightedAvgAcc createAccumulator() {
            return new WeightedAvgAcc();
        }

        public void accumulate(WeightedAvgAcc acc, Double value, Long weight) {
            if (value != null && weight != null && weight > 0) {
                acc.weightedSum += value * weight;
                acc.weightSum += weight;
            }
        }

        public void merge(WeightedAvgAcc acc, Iterable<WeightedAvgAcc> partials) {
            for (WeightedAvgAcc partial : partials) {
                acc.weightedSum += partial.weightedSum;
                acc.weightSum += partial.weightSum;
            }
        }

        @Override
        public Double getValue(WeightedAvgAcc acc) {
            return acc.weightSum == 0 ? null : acc.weightedSum / acc.weightSum;
        }
    }

    public static void main(String[] args) {
        TableEnvironment tableEnv = TableEnvironment.create(
                EnvironmentSettings.newInstance().inBatchMode().build());

        tableEnv.createTemporarySystemFunction("mask_email", MaskEmail.class);
        tableEnv.createTemporarySystemFunction("split_words", SplitWords.class);
        tableEnv.createTemporarySystemFunction("weighted_avg", WeightedAvg.class);

        Table users = tableEnv.fromValues(
                DataTypes.ROW(
                        DataTypes.FIELD("user_name", DataTypes.STRING()),
                        DataTypes.FIELD("email", DataTypes.STRING()),
                        DataTypes.FIELD("tags", DataTypes.STRING())),
                Row.of("Alice", "alice@example.com", "flink sql"),
                Row.of("Bob", "bob@example.com", "table api"));
        tableEnv.createTemporaryView("users", users);

        Table orders = tableEnv.fromValues(
                DataTypes.ROW(
                        DataTypes.FIELD("item", DataTypes.STRING()),
                        DataTypes.FIELD("price", DataTypes.DOUBLE()),
                        DataTypes.FIELD("weight", DataTypes.BIGINT())),
                Row.of("A", 10.0D, 2L),
                Row.of("B", 20.0D, 1L));
        tableEnv.createTemporaryView("orders", orders);

        tableEnv.executeSql(
                "SELECT user_name, mask_email(email) AS masked_email FROM users")
                .print();

        tableEnv.executeSql(
                "SELECT u.user_name, word " +
                "FROM users AS u, " +
                "LATERAL TABLE(split_words(u.tags)) AS t(word)")
                .print();

        tableEnv.executeSql(
                "SELECT weighted_avg(price, weight) AS avg_price FROM orders")
                .print();
    }
}
预期输出的表格边框可能因 Flink 版本不同而变化,但数据应与下面一致。
Alice | a***@example.com
Bob   | b***@example.com

Alice | flink
Alice | sql
Bob   | table
Bob   | api

13.333333333333334
注册范围与类型边界
createTemporarySystemFunction 的名称优先级较高,适合应用级公共函数;只想让函数属于当前 Catalog 和数据库时,可改用 createTemporaryFunction。生产环境应避免用临时函数覆盖同名内置函数,并在启动日志中记录函数名与实现版本。
Flink 会从 eval、accumulate 和泛型参数推断数据类型。复杂对象、泛型集合或精度敏感的 DECIMAL 推断不稳定时,应通过类型提示显式声明。聚合累加器必须可序列化并提供稳定字段结构;分布式聚合可能产生局部结果,因此可合并的聚合应实现 merge。
标量函数和聚合函数应明确处理 null。表函数不调用 collect 就代表本行不产生结果;聚合函数在没有有效输入时返回 null,通常比返回具有业务含义的零更安全。