
大数据与流处理 / 系统课时
Map 与 FlatMap
Map 与 FlatMap
本课解决两个常见转换问题:怎样把每条事件改造成新结构,以及怎样把一条复合记录拆成零条或多条结果。完成后,你将能用 MapFunction 与 FlatMapFunction 构建可运行的数据清洗链路。
学习目标
- 理解 Map 的一进一出与 FlatMap 的一进零到多出。
- 使用 Java 函数接口完成标准化、拆分和无效值过滤。
- 根据输出数量和清洗规则选择合适的转换算子。
两种转换的本质
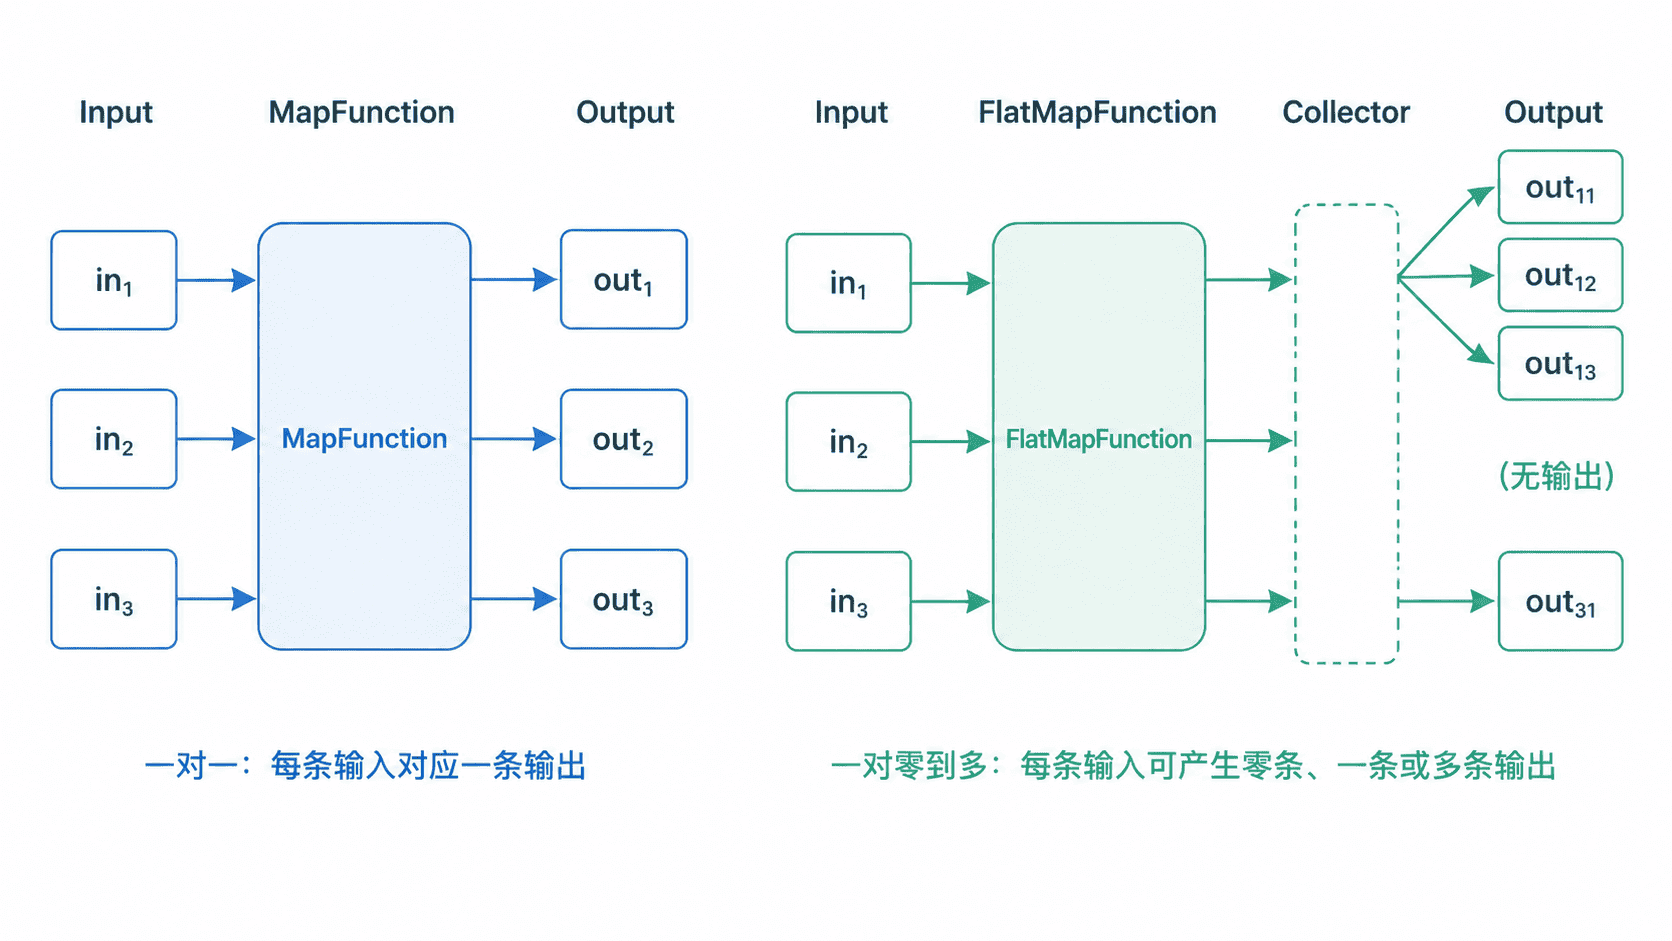
map 会对流中的每个元素调用一次函数,并且必须返回一个结果,因此它适合字段改名、类型转换、补充计算字段等一对一处理。输入有多少条,正常情况下输出就有多少条。
flatMap 通过 Collector 主动发送结果。一次调用可以不发送、发送一条或发送多条,因此既能拆分复合记录,也能在解析失败时丢弃无效数据。它常用于分词、展开数组、解析多值字段和轻量清洗。
完成标准化与拆分
下面的程序先用 MapFunction 统一大小写,再用 FlatMapFunction 拆分姓名和多个分数。格式错误的行不输出,无法解析的分数被跳过。
java
import org.apache.flink.api.common.functions.FlatMapFunction;
import org.apache.flink.api.common.functions.MapFunction;
import org.apache.flink.api.java.tuple.Tuple2;
import org.apache.flink.streaming.api.datastream.DataStream;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.util.Collector;

import java.util.Locale;

public class MapFlatMapDemo {

    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env =
                StreamExecutionEnvironment.getExecutionEnvironment();
        env.setParallelism(1);

        DataStream<String> source = env.fromElements(
                "Alice,100,90",
                " Bob ,80",
                "broken",
                "Carol,70,bad,60"
        );

        DataStream<String> normalized = source.map(
                new MapFunction<String, String>() {
                    @Override
                    public String map(String value) {
                        // Map 保持一进一出,只负责统一基础格式。
                        return value.trim().toLowerCase(Locale.ROOT);
                    }
                }
        );

        DataStream<Tuple2<String, Integer>> scores = normalized.flatMap(
                new FlatMapFunction<String, Tuple2<String, Integer>>() {
                    @Override
                    public void flatMap(
                            String value,
                            Collector<Tuple2<String, Integer>> out) {
                        String[] fields = value.split(",");
                        if (fields.length < 2) {
                            return; // 不调用 collect,当前输入产生零条输出。
                        }

                        String name = fields[0].trim();
                        for (int i = 1; i < fields.length; i++) {
                            try {
                                int score = Integer.parseInt(fields[i].trim());
                                out.collect(Tuple2.of(name, score));
                            } catch (NumberFormatException ignored) {
                                // 单个分数无效时跳过,不影响同一行中的其他分数。
                            }
                        }
                    }
                }
        );

        scores.print();
        env.execute("map-flatmap-demo");
    }
}
预期输出
text
(alice,100)
(alice,90)
(bob,80)
(carol,70)
(carol,60)
本例把并行度设置为 1,因此输出顺序稳定。实际集群并行执行时,print 的行序可能不同,也可能带有子任务编号前缀,但有效记录集合应保持一致。
选择算子与处理边界
当每条输入都必须得到一个确定结果时优先使用 map。若存在“无效数据不输出”或“一条记录展开为多条”的需求,应使用 flatMap,不要在 map 中返回 null 代替过滤。
清洗逻辑还要明确失败策略。本例选择跳过坏分数,适合允许局部脏数据的场景;若数据必须完整,应把错误记录发送到侧输出或让任务失败并告警,而不是静默丢弃。
按自己的节奏,确认真正理解。