
大数据与流处理 / 系统课时
读取 Kafka 数据
读取 Kafka 数据
本课完成一个可运行的 Flink Kafka Source 作业:订阅 orders 主题,从消费组已提交位点开始读取消息,在没有提交位点时回退到最早数据,并把反序列化后的字符串输出到控制台。
学习目标
- 使用
KafkaSource配置 Kafka 地址、主题和消费组 - 选择合适的反序列化方式与起始位点
- 理解检查点恢复、消费组位点与初始位点之间的优先级
Kafka Source 的读取链路
KafkaSource 会发现主题分区,把分区分配给并行 Source Reader,再由 Reader 持续拉取消息。Flink 检查点保存的是各分区的读取进度;作业恢复时优先使用检查点或 Savepoint 中的状态,而不是重新应用起始位点配置。
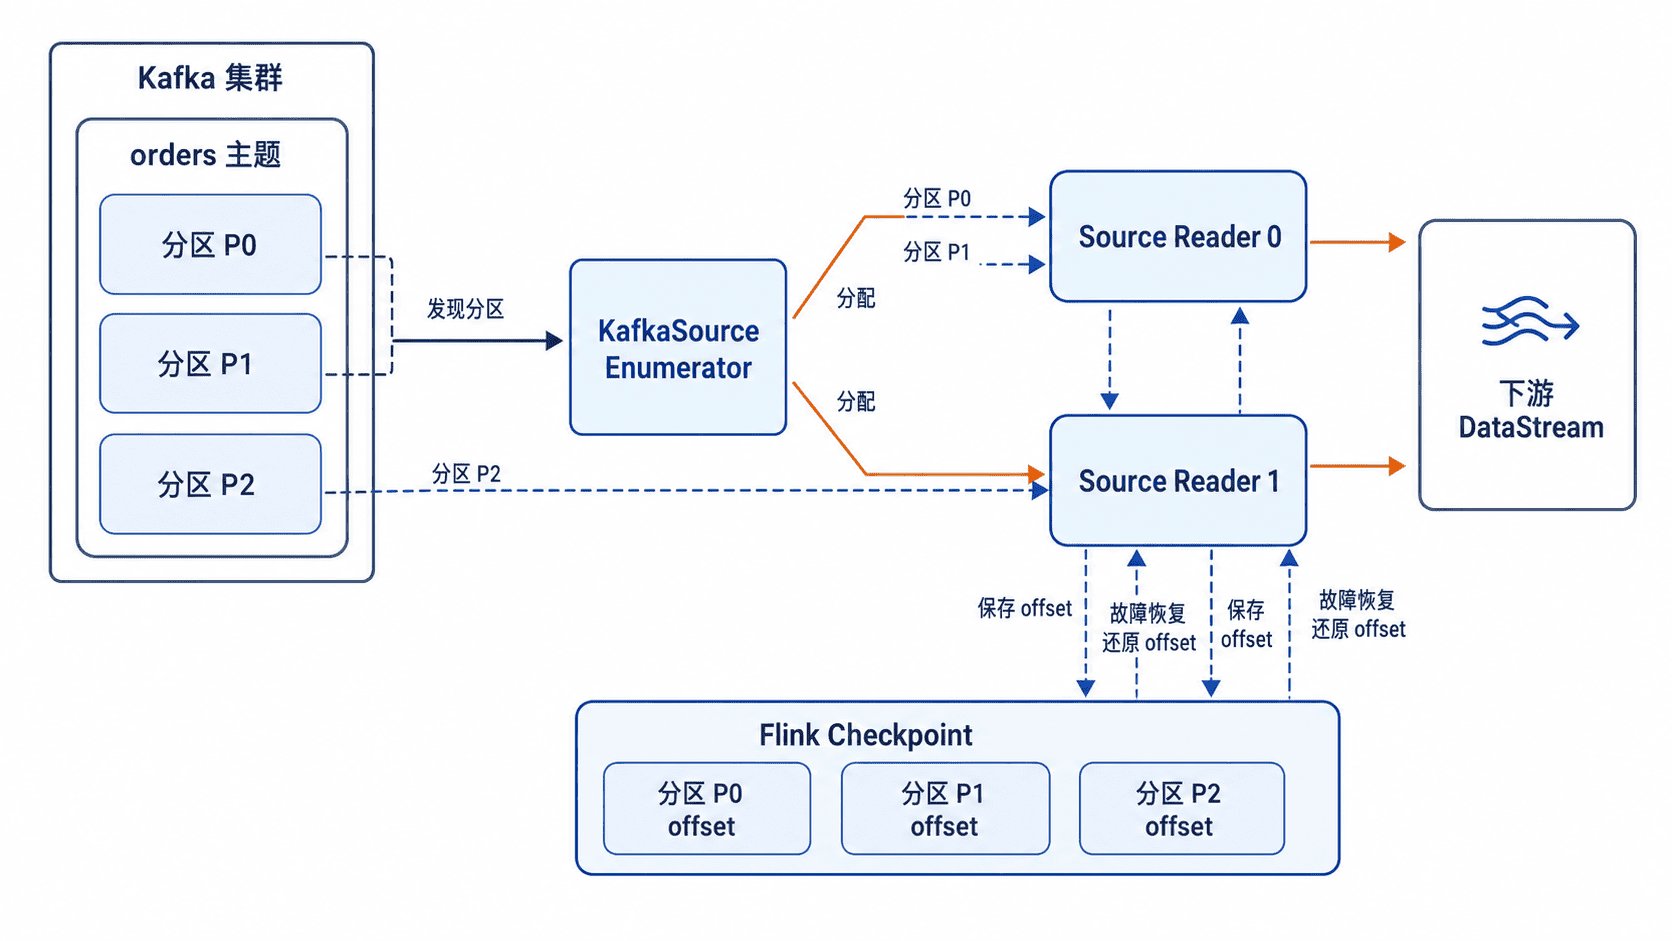
要运行示例,项目需要引入与当前 Flink 版本兼容的 Kafka 连接器。连接器通常独立发布,版本不要凭经验硬配,应以所用 Flink 发行版的兼容说明为准。
<dependency>
    <groupId>org.apache.flink</groupId>
    <artifactId>flink-connector-kafka</artifactId>
    <version>${flink.kafka.connector.version}</version>
</dependency>
这段配置只声明连接器依赖;将属性值替换为项目实际采用的兼容版本,并确认运行集群也能加载该 JAR。
完整消费示例
下面的程序订阅单个主题,使用字符串反序列化,并把并行度固定为 1,便于观察输出。运行前应保证 localhost:9092 可访问,且 orders 主题中已有 UTF-8 文本消息。
import org.apache.flink.api.common.eventtime.WatermarkStrategy;
import org.apache.flink.api.common.serialization.SimpleStringSchema;
import org.apache.flink.connector.kafka.source.KafkaSource;
import org.apache.flink.connector.kafka.source.enumerator.initializer.OffsetsInitializer;
import org.apache.flink.streaming.api.datastream.DataStream;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.kafka.clients.consumer.OffsetResetStrategy;

public class ReadKafkaJob {

    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env =
                StreamExecutionEnvironment.getExecutionEnvironment();
        env.setParallelism(1);
        // 检查点保存分区读取进度,并驱动消费组位点提交
        env.enableCheckpointing(10_000);

        KafkaSource<String> source = KafkaSource.<String>builder()
                .setBootstrapServers("localhost:9092")
                .setTopics("orders")
                .setGroupId("flink-orders-reader")
                // 优先读取消费组提交位点;首次消费时回退到最早位点
                .setStartingOffsets(
                        OffsetsInitializer.committedOffsets(
                                OffsetResetStrategy.EARLIEST))
                .setValueOnlyDeserializer(new SimpleStringSchema())
                .build();

        DataStream<String> orders = env.fromSource(
                source,
                WatermarkStrategy.noWatermarks(),
                "kafka-orders-source");

        orders.print("kafka");
        env.execute("read-kafka-orders");
    }
}
预期输出
kafka:1> {"orderId":"1001","amount":88}
kafka:1> {"orderId":"1002","amount":128}
示例把并行度固定为 1,因此打印前缀通常为 kafka:1>。消息内容和顺序取决于主题现有数据;多个分区并行消费时,只保证单个 Kafka 分区内的顺序。
起始位点怎么选
OffsetsInitializer 只决定没有可恢复状态时从哪里开始。常见策略如下:
| 策略 | 适合场景 | 关键边界 |
|---|---|---|
earliest() |
首次回放全部历史数据 | 数据量大时会产生明显追赶压力 |
latest() |
只处理作业启动后的新消息 | 启动前数据不会被读取 |
committedOffsets() |
延续消费组在 Kafka 中提交的位点 | 位点不存在时要明确重置策略 |
timestamp(...) |
从指定时间附近回放 | 时间戳单位是毫秒,各分区结果可能不同 |
当作业从 Checkpoint 或 Savepoint 恢复时,恢复状态优先级最高。若想强制从最早位点重放,不能只修改 setStartingOffsets,还要以无状态方式启动,或使用经过确认的状态迁移方案。
订阅与反序列化边界
固定主题使用 setTopics 最直接;多个主题也可一次传入。按命名规则动态订阅时可改用主题正则,但要评估新主题是否应该自动进入作业,避免误消费测试或敏感主题。
SimpleStringSchema 只适合值为 UTF-8 文本且不需要 Kafka key、headers、partition、offset 等元数据的场景。若业务需要这些字段,应实现完整的 Kafka 记录反序列化逻辑,并把解析失败数据送往独立错误流,而不是在 Source 中直接丢弃。
验证与常见失败
启动后没有数据,先按顺序检查 Broker 地址、主题名称、ACL、消费组位点和起始策略。latest() 最容易造成“作业正常但看不到旧消息”的误判。
若日志提示找不到 Kafka 连接器类,通常是依赖未打入提交包或集群缺少连接器 JAR。若出现反序列化异常,应核对生产者编码与 Schema,并保留原始消息用于定位。
生产环境应开启 Checkpoint,确保读取进度进入 Flink 状态。Kafka 消费组提交位点便于外部观察,但作业一致性恢复仍应以 Flink 状态为准。