
大数据与流处理 / 系统课时
写入 Elasticsearch
写入 Elasticsearch
本课实现一个可运行的 Elasticsearch 7 Sink:把商户实时统计写成带固定文档 ID 的索引文档,并配置按条数或时间批量刷新、指数退避重试和 checkpoint。完成后可直接查询指定文档验证结果。
学习目标
- 构造 Elasticsearch 索引请求并设置稳定文档 ID
- 配置批量刷新和指数退避重试
- 理解 checkpoint、重复写入与失败类型的边界
写入链路与一致性
Flink Sink 先把记录转换为索引请求,再进入内部批量缓冲区。达到最大动作数、刷新间隔或 checkpoint 时,缓冲请求会发送到 Elasticsearch;临时资源不足可以退避重试,而格式错误等永久失败应直接暴露并修复。
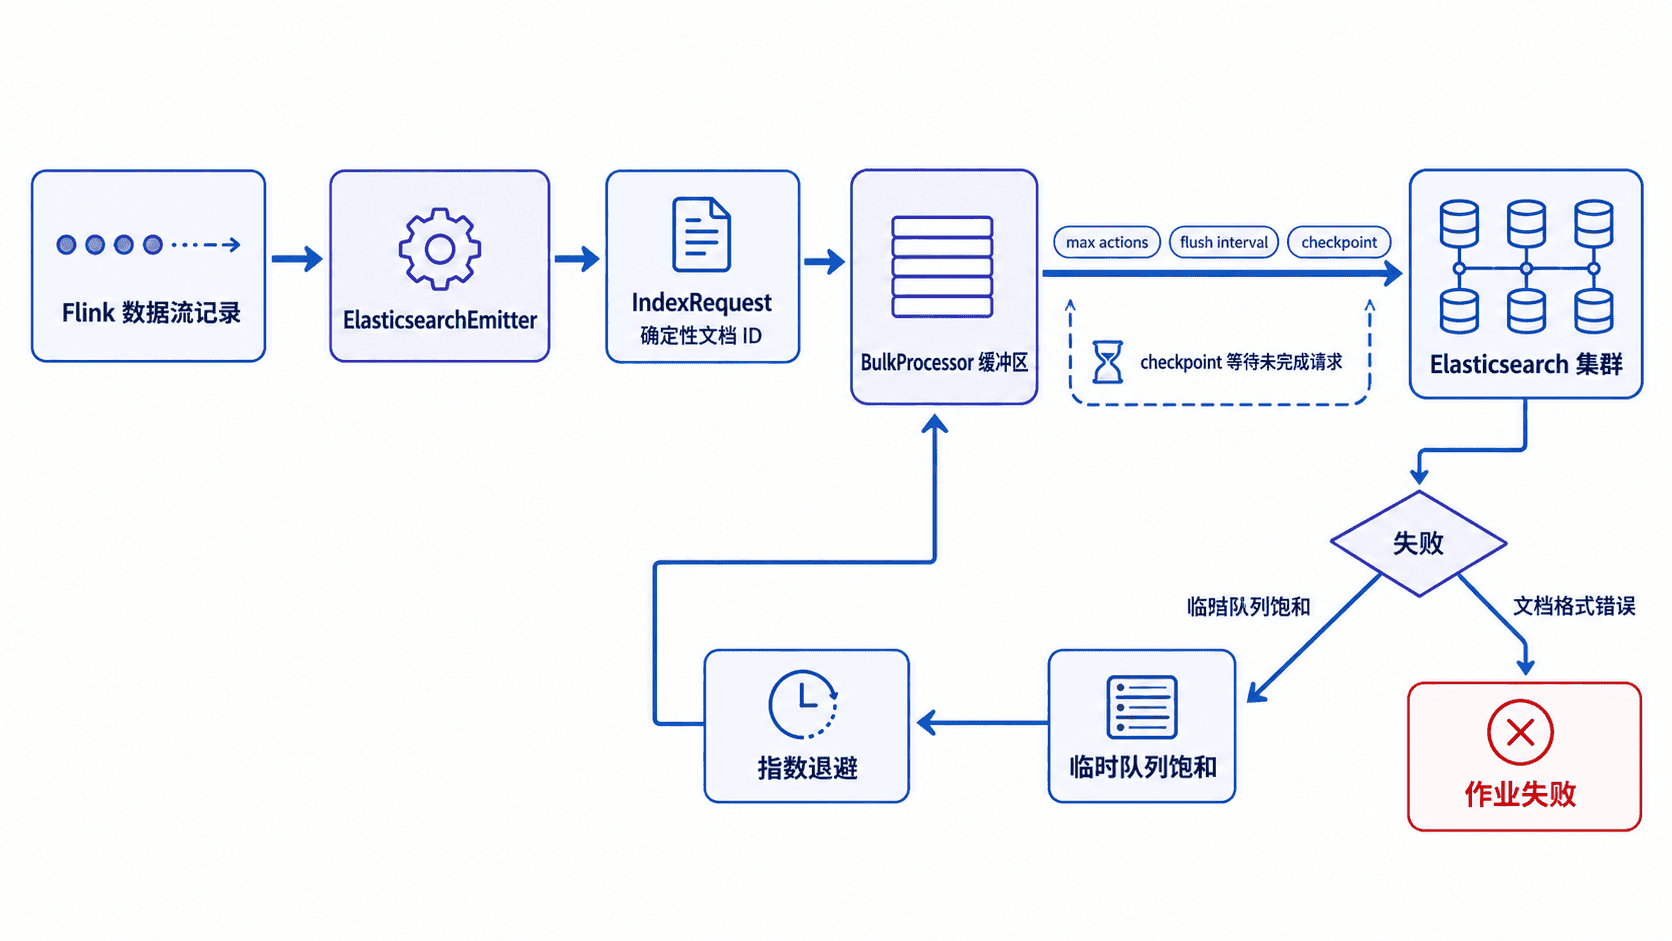
启用 checkpoint 后,Sink 会在检查点阶段等待待处理请求完成,从而提供至少一次投递。恢复时记录可能再次发送,因此示例用 merchantId 作为文档 ID;重复的索引请求会覆盖同一文档,而不会不断创建新文档。
实现实时写入
项目需要引入与 Flink 版本匹配的 flink-connector-elasticsearch7。下面程序写入两条固定数据,批次达到 2 条时立即刷新;如果 Elasticsearch 暂时拒绝请求,最多进行 5 次指数退避重试。
import org.apache.flink.api.java.tuple.Tuple3;
import org.apache.flink.connector.elasticsearch.sink.Elasticsearch7SinkBuilder;
import org.apache.flink.connector.elasticsearch.sink.FlushBackoffType;
import org.apache.flink.streaming.api.datastream.DataStream;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.http.HttpHost;
import org.elasticsearch.action.index.IndexRequest;
import org.elasticsearch.client.Requests;

import java.util.HashMap;
import java.util.Map;

public class ElasticsearchOrderStatsJob {

    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env =
                StreamExecutionEnvironment.getExecutionEnvironment();

        // checkpoint 会等待尚未完成的批量请求,避免成功记录被静默遗漏
        env.enableCheckpointing(10_000L);

        DataStream<Tuple3<String, Long, Double>> stats = env.fromElements(
                Tuple3.of("m-1001", 18L, 1268.50D),
                Tuple3.of("m-1002", 7L, 460.00D)
        );

        stats.sinkTo(
                new Elasticsearch7SinkBuilder<Tuple3<String, Long, Double>>()
                        .setHosts(new HttpHost("localhost", 9200, "http"))
                        .setEmitter((value, context, indexer) ->
                                indexer.add(toIndexRequest(value)))
                        // 条数或时间任一条件先满足,就发送当前批次
                        .setBulkFlushMaxActions(2)
                        .setBulkFlushInterval(2_000L)
                        .setBulkFlushBackoffStrategy(
                                FlushBackoffType.EXPONENTIAL,
                                5,
                                1_000L)
                        .build()
        ).name("merchant-stats-es7-sink");

        env.execute("elasticsearch-order-stats");
    }

    private static IndexRequest toIndexRequest(
            Tuple3<String, Long, Double> value) {
        Map<String, Object> document = new HashMap<>();
        document.put("merchantId", value.f0);
        document.put("orderCount", value.f1);
        document.put("amount", value.f2);

        // 固定文档 ID 让恢复后的重复写入覆盖同一商户结果
        return Requests.indexRequest()
                .index("merchant-stats")
                .id(value.f0)
                .source(document);
    }
}
预期结果
作业正常结束,索引 merchant-stats 中生成文档 m-1001 和 m-1002。
Flink 日志中的实际任务 ID、时间和端口可能不同。
查询并验证文档
作业结束后查询固定文档的 _source。若 Elasticsearch 不在本机,请把主机和 <PORT> 替换为实际地址。
curl -s "http://localhost:<PORT>/merchant-stats/_source/m-1001"预期输出
{"merchantId":"m-1001","orderCount":18,"amount":1268.5}JSON 字段顺序可能不同,但字段和值应一致。若返回 404,先确认索引名称、文档 ID 和 Sink 使用的集群地址,再检查作业日志中是否存在批量请求失败。
批量刷新与失败重试
setBulkFlushMaxActions(2) 适合演示,生产值应结合单条文档大小、允许延迟和集群写入能力压测。刷新间隔用于低流量场景,避免缓冲区长期达不到条数阈值;批次越大,吞吐通常越高,但单批失败影响和 checkpoint 等待时间也会增大。
指数退避只适合节点队列饱和等临时资源问题。字段映射冲突、非法 JSON、权限不足和索引不存在策略错误不会因为重试自动恢复,应让作业失败并修正根因。重试次数过多还会延长 checkpoint,应同时监控失败率、批量耗时和检查点持续时间。
本示例针对 Elasticsearch 7。Elasticsearch 8 使用不同的异步 Sink Builder,并不支持这里的 BulkProcessor 退避配置,升级时不能只替换依赖版本。