
大数据与流处理 / 系统课时
排查内存问题
排查内存问题
本课解决 TaskManager 出现 OutOfMemoryError、直接内存不足、容器被杀死或频繁 Full GC 时无从下手的问题。你将建立从现象分类、进程取证到配置修复的排查顺序,并避免只调大堆内存却让其他区域更紧张。
学习目标
- 区分堆内存、直接内存、托管内存和进程总内存问题
- 使用 JVM 与操作系统工具收集关键证据
- 根据证据调整 Flink 内存配置并完成回归验证
建立内存视图与证据链
TaskManager 进程内存不仅包含 JVM Heap,还包括 Managed Memory、Direct Memory、Metaspace、线程栈和 JVM Overhead。容器限制约束整个进程,而 -Xmx 只约束堆;因此堆没有打满,进程仍可能因为直接内存或额外开销超过限制而被终止。
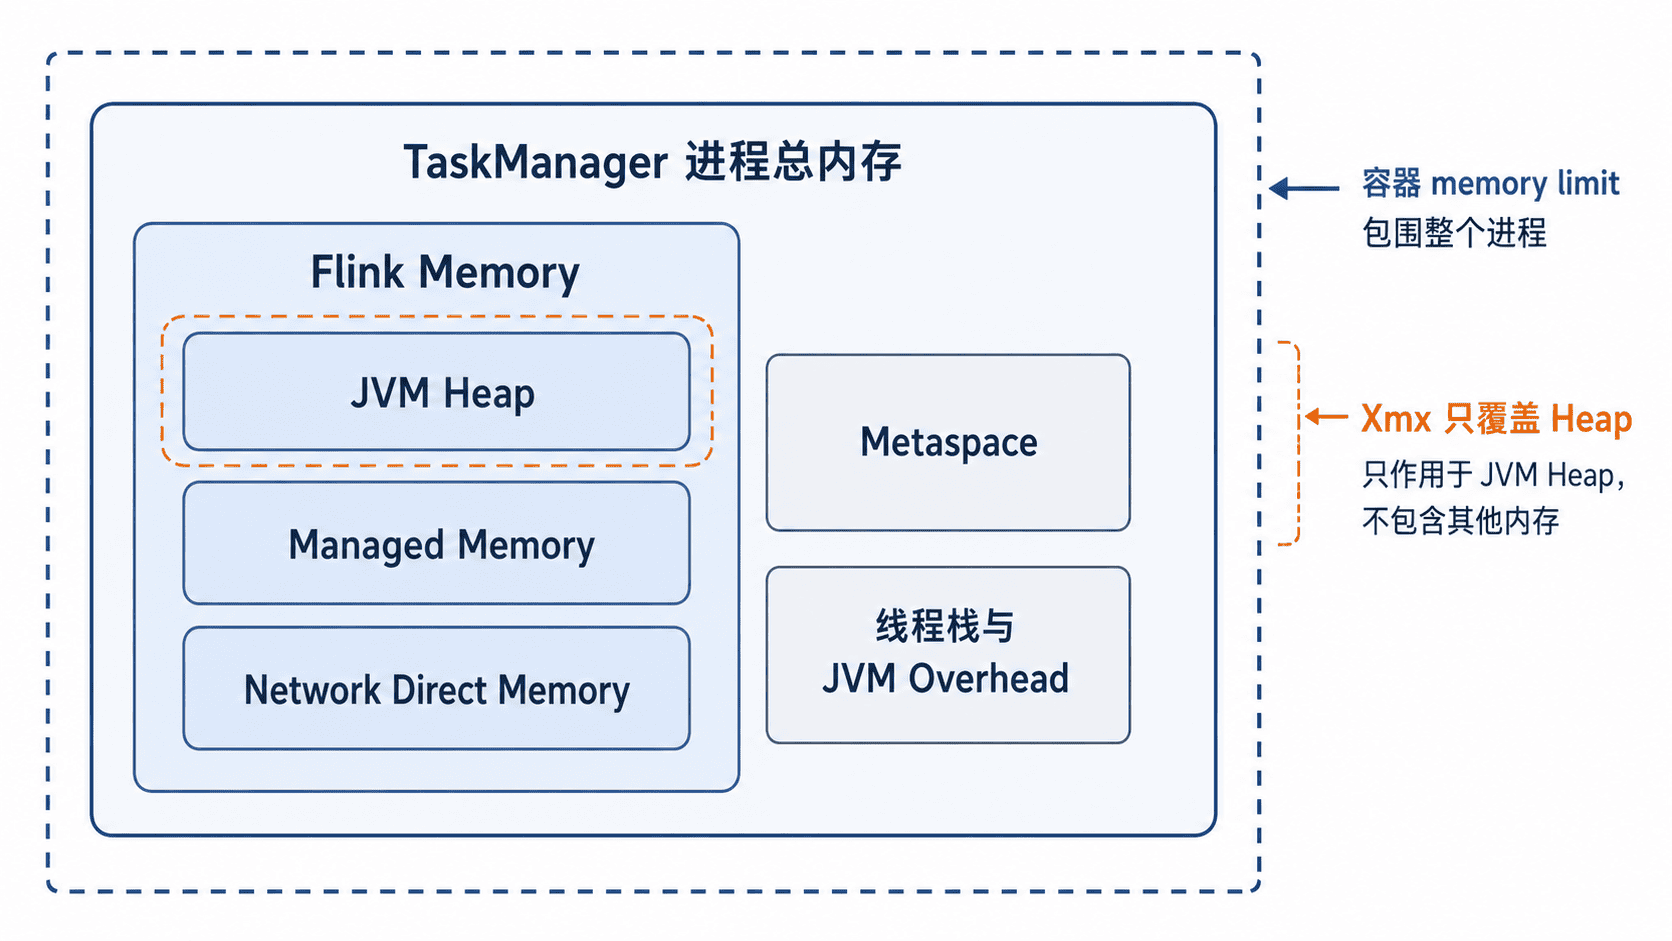
常见现象可先分为四类:Java heap space 多与对象积压或用户代码缓存有关;Direct buffer memory 多与网络缓冲、序列化或第三方库直接内存有关;频繁 Full GC 表示堆长期接近上限或对象晋升过快;容器显示 OOMKilled 而 JVM 无异常日志,通常是进程总内存超过容器限制。
先保存异常堆栈、TaskManager 日志、容器退出原因和故障前后的监控,再进入进程检查。不要在没有证据时立即重启并覆盖现场。以下命令将 <PID> 替换为 TaskManager JVM 进程号;VM.native_memory 需要 JVM 启动时开启 Native Memory Tracking。
jstat -gcutil <PID> 1000 5
jcmd <PID> GC.heap_info
jcmd <PID> VM.native_memory summary
预期输出会包含 GC 利用率、堆容量和本地内存分类,实际数值会不同;未启用 Native Memory Tracking 时,第三条命令会明确提示不可用。
 S0     S1     E      O      M     CCS    YGC    YGCT   FGC   FGCT    GCT
<VAL>  <VAL>  <VAL>  <VAL>  <VAL> <VAL>  <ID>   <TIME> <ID>  <TIME>  <TIME>
<HEAP_TYPE> heap total <BYTES>K, used <BYTES>K
Native Memory Tracking:
Total: reserved=<BYTES>KB, committed=<BYTES>KB
老年代持续升高且 Full GC 后下降很少时,应生成堆转储并分析大对象引用链;堆稳定而进程 RSS 持续升高时,则重点检查 Direct、线程数量、Metaspace 和本地库。
按现象修复内存问题
堆内存与频繁 GC
出现 Java heap space 时,先检查反压导致的记录堆积、异步请求未完成、用户代码集合无限增长、窗口或缓存缺少清理。仅增大堆可能延迟故障,却不会修复泄漏或无界状态。
Young GC 高频但停顿短,可能只是对象分配速率高;Full GC 频繁且停顿长,通常表示老年代压力或内存泄漏。应结合 GC 日志和堆转储确认,不要只依据 CPU 使用率判断。
Direct 与 Managed Memory
出现 Direct buffer memory 时,检查网络缓冲区上下界、并行度、每个 TaskManager 的 slot 数量,以及 Netty、Arrow、压缩库等组件的直接内存。网络内存过小会限制吞吐,过大又会挤压 JVM Overhead。
Managed Memory 主要由 Flink 管理,用于排序、哈希、缓存和部分状态后端。若算子频繁溢写磁盘,可在总预算允许时提高其比例;若用户代码主要消耗堆,则盲目提高 Managed Memory 反而会压缩 Task Heap。
进程总内存与容器限制
容器被 OOMKilled 时,比较 taskmanager.memory.process.size 与容器内存限制。容器限制必须覆盖完整进程预算,并考虑线程栈、本地库和监控 Agent 等额外开销。
优先以进程总内存为入口,让 Flink 推导各区域;只有明确知道瓶颈时,才固定组件大小。下面是 TaskManager 内存预算片段示例,具体值必须依据负载测试调整。
taskmanager.memory.process.size: 4096m
taskmanager.memory.managed.fraction: 0.35
taskmanager.memory.network.min: 128m
taskmanager.memory.network.max: 512m
taskmanager.memory.jvm-overhead.min: 256m
taskmanager.memory.jvm-overhead.max: 512m
配置生效后,应在启动日志中确认 Heap、Managed、Network 和 JVM Overhead 均为正值,且总和不超过进程预算。不要同时配置过多互相约束的内存项,否则可能造成预算无法满足或某一区域被意外压缩。
完成回归验证
修复后必须复现原负载,并至少跨越一个业务高峰。验收指标包括:Full GC 次数显著下降、进程 RSS 稳定、容器未再 OOMKilled、反压没有恶化、Checkpoint 耗时没有因内存调整而明显上升。
最后执行一次 TaskManager 故障恢复,确认作业能从最近 Checkpoint 恢复。内存优化不能以降低状态一致性或恢复能力为代价。