
大数据与流处理 / 系统课时
聚合算子
聚合算子
本课解决 DataStream 中“同一业务键的数据如何边到边汇总”的问题。你将使用 keyBy 建立按键状态,再用 Reduce、Sum、Min 和 Max 输出持续更新的增量结果。
学习目标
- 理解滚动聚合为什么必须先按业务键分组
- 使用
reduce编写自定义增量聚合逻辑 - 正确选择
sum、min、max及其边界
增量聚合如何工作
聚合算子不会等待整个流结束,而是为每个键保存一份当前结果。新事件到达后,只需把它与该键已有结果合并,因此单次更新通常不需要重新扫描历史数据。
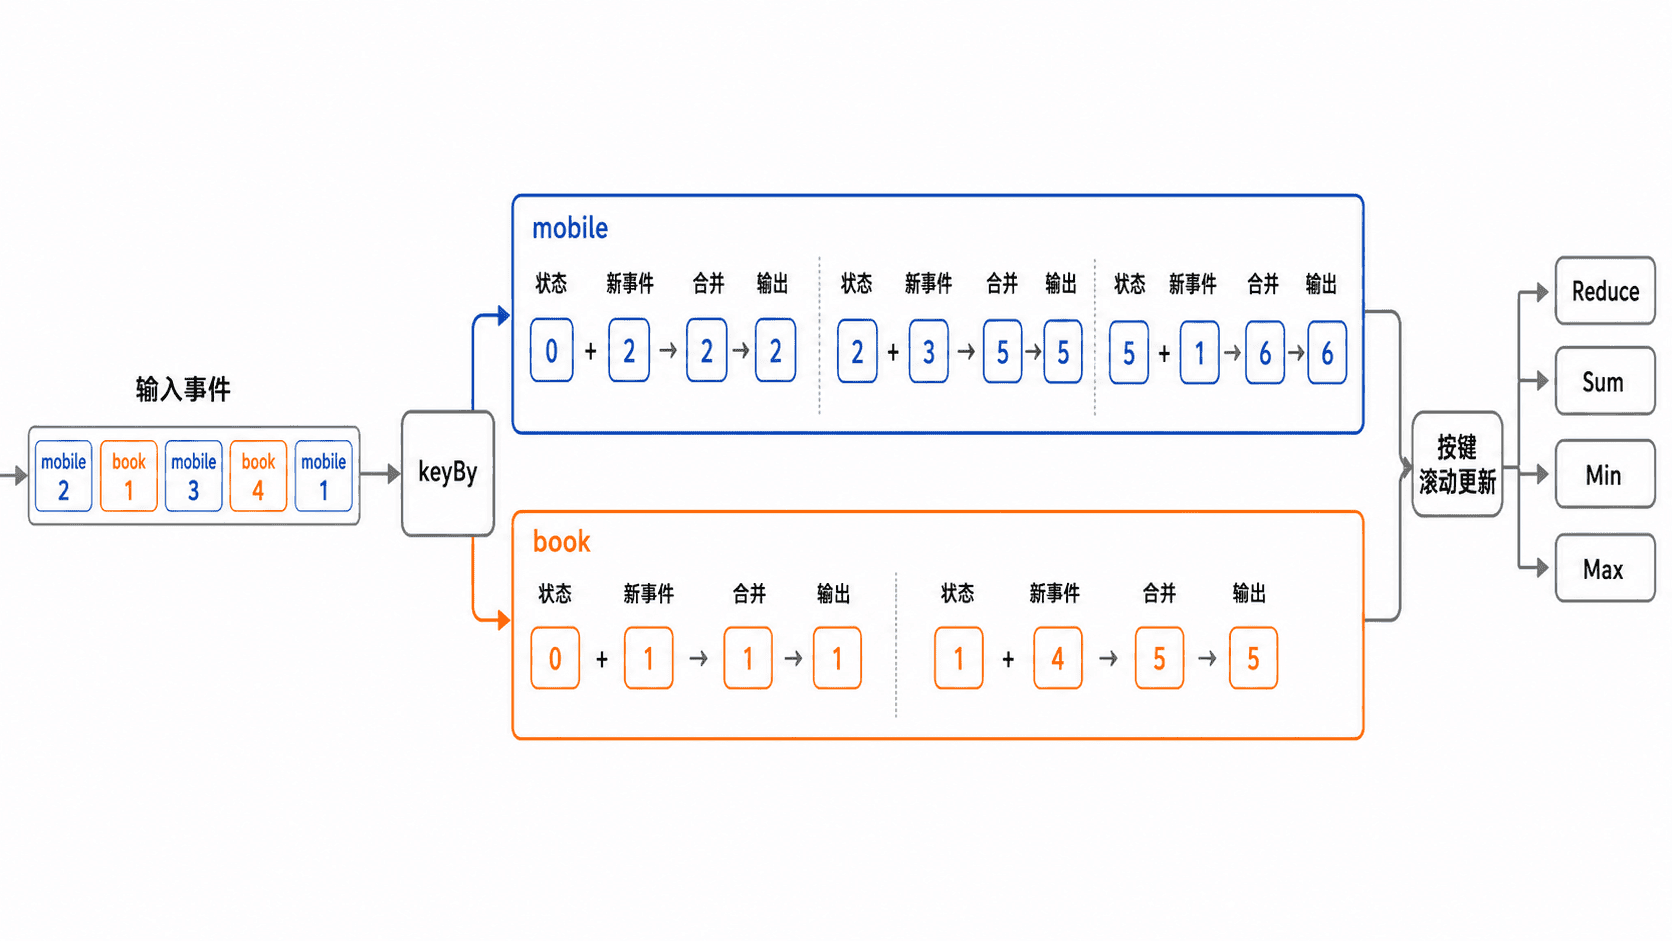
没有 keyBy 时,不能直接得到“每个商品类别各自累计”的结果。按键后,同一个键会被路由到同一逻辑分区,聚合状态也按键隔离。
完整示例
下面的 Java 程序对两个商品类别分别执行四种滚动聚合。将类放入已包含 flink-streaming-java 依赖的 Maven 项目中即可运行。
java
package com.anystack.flink.datastream;

import org.apache.flink.api.common.functions.ReduceFunction;
import org.apache.flink.api.java.tuple.Tuple2;
import org.apache.flink.streaming.api.datastream.DataStream;
import org.apache.flink.streaming.api.datastream.KeyedStream;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;

public class IncrementalAggregationDemo {

    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env =
                StreamExecutionEnvironment.getExecutionEnvironment();
        env.setParallelism(1);

        DataStream<Tuple2<String, Integer>> source = env.fromElements(
                Tuple2.of("mobile", 2),
                Tuple2.of("book", 5),
                Tuple2.of("mobile", 3),
                Tuple2.of("book", 1));

        // 四个分支都按商品类别维护独立的滚动结果。
        KeyedStream<Tuple2<String, Integer>, String> keyed =
                source.keyBy(value -> value.f0);

        keyed.reduce(new ReduceFunction<Tuple2<String, Integer>>() {
            @Override
            public Tuple2<String, Integer> reduce(
                    Tuple2<String, Integer> current,
                    Tuple2<String, Integer> incoming) {
                return Tuple2.of(current.f0, current.f1 + incoming.f1);
            }
        }).map(value -> "reduce " + value).print();

        keyed.sum(1).map(value -> "sum " + value).print();
        keyed.min(1).map(value -> "min " + value).print();
        keyed.max(1).map(value -> "max " + value).print();

        env.execute("incremental-aggregation-demo");
    }
}
预期输出按算子归类如下。多个下游分支并行消费同一输入流,因此控制台中的不同前缀可能交错,但每组结果应一致。
text
reduce (mobile,2)
reduce (book,5)
reduce (mobile,5)
reduce (book,6)
sum (mobile,2)
sum (book,5)
sum (mobile,5)
sum (book,6)
min (mobile,2)
min (book,5)
min (mobile,2)
min (book,1)
max (mobile,2)
max (book,5)
max (mobile,3)
max (book,5)
选择算子与处理边界
reduce 最灵活,适合累计金额、合并对象或同时更新多个字段;函数必须接收两个同类型元素并返回同类型结果。sum、min、max 是字段聚合快捷方式,适合 Tuple 或可按字段定位的数据类型。
min 和 max 只保证目标字段是当前极值。记录包含时间、名称等关联字段时,这些字段不一定来自产生极值的那条完整记录;需要保留整条极值记录时,应改用 minBy 或 maxBy。
滚动聚合会持续输出中间结果。只想得到固定时间范围内的最终值时,应先定义窗口,再在窗口上聚合。
按自己的节奏,确认真正理解。