
大数据与流处理 / 系统课时
窗口计算模型
窗口计算模型
窗口计算把无界数据流切成可计算的有限范围。本课从记录进入算子开始,串起窗口分配、状态保存、触发计算、结果输出和状态清理,帮助你建立后续编写滚动、滑动与会话窗口代码所需的统一模型。
学习目标
- 说明窗口分配器、触发器和窗口函数各自负责什么
- 区分触发计算、清空内容与删除窗口状态
- 根据时间语义和迟到数据要求设计窗口链路
为什么无界流需要窗口
持续到来的数据没有天然终点,直接执行“总计”通常只能得到不断变化的中间值。窗口通过时间、数量或会话间隔划定有限数据集合,使聚合、排序和统计拥有明确的计算范围与输出时机。
窗口本身不是数据副本,而是“键与窗口标识”对应的一组状态。使用 keyBy 后,每个业务键分别维护窗口;不分键的 windowAll 会把同一窗口的数据集中处理,通常不利于并行扩展。
一条记录如何经过窗口
记录先按业务键分区,再由窗口分配器判断它属于哪个窗口。算子把记录写入该键、该窗口的状态;触发器满足条件时调用窗口函数,函数读取增量聚合值或窗口元素并输出结果。时间窗口最终还会在清理时点删除状态。
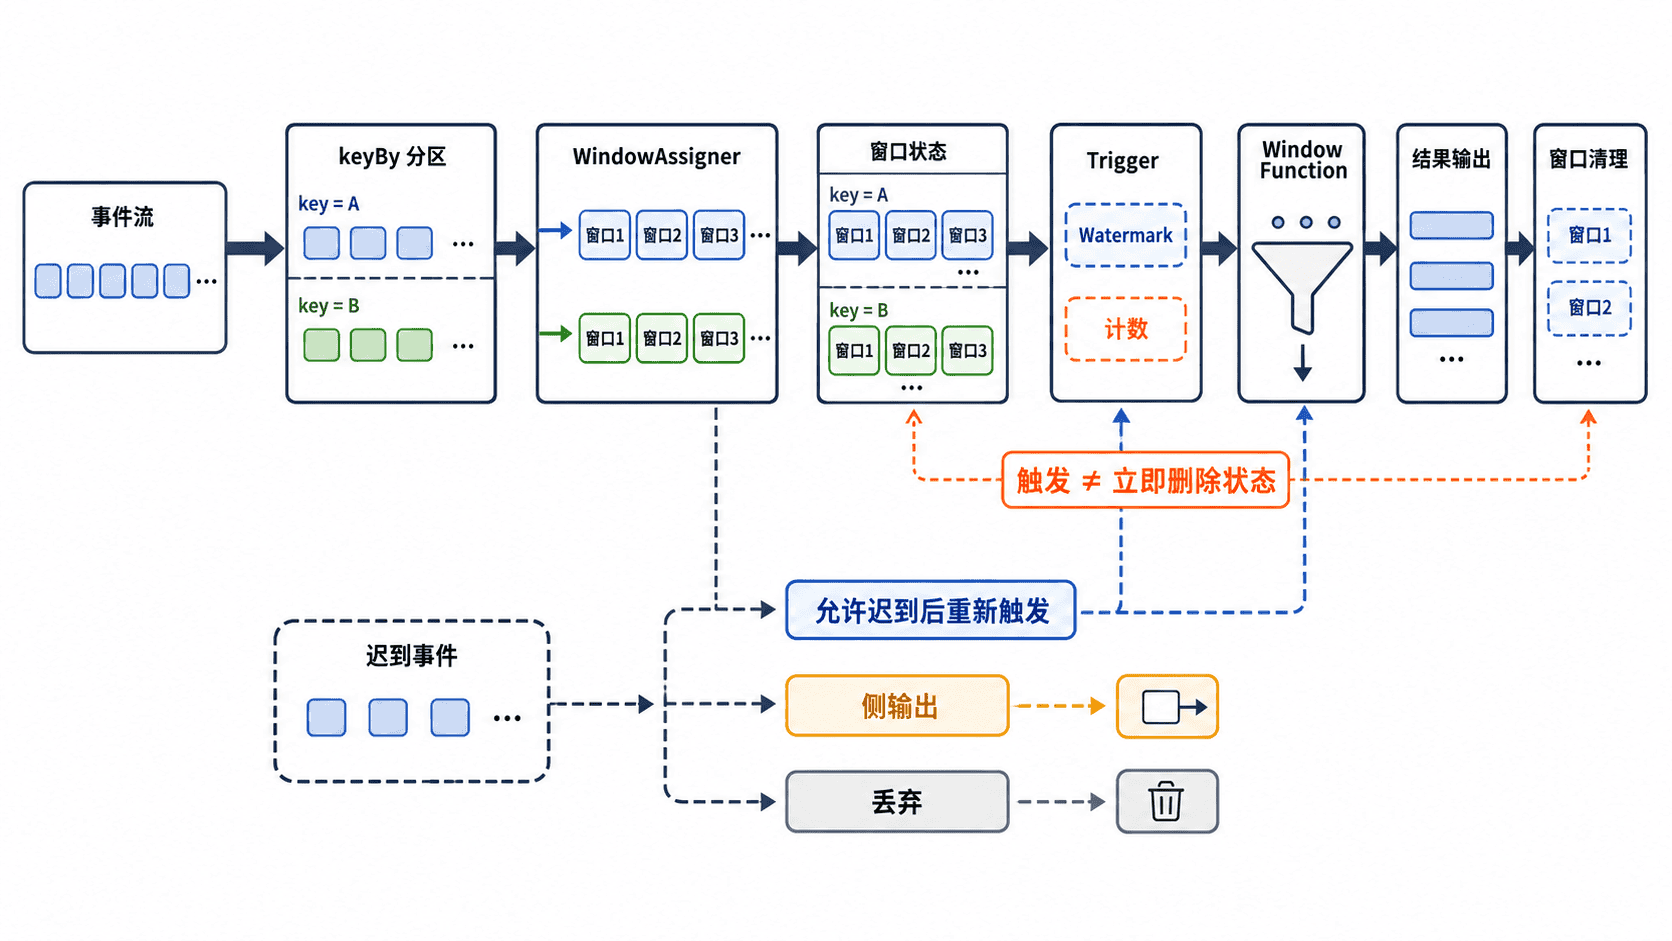
可以把完整链路记成:分区 → 分配 → 保存 → 触发 → 计算 → 输出 → 清理。其中分配器决定“算哪一组数据”,触发器决定“何时计算”,窗口函数决定“怎么算以及输出什么”。
触发不等于清理
触发器发出 FIRE 时,窗口函数会执行,但窗口内容不一定被删除,因此允许迟到数据到达后再次触发并更新结果。只有触发结果包含清除语义,或系统到达窗口清理时间,相关状态才会释放。
这一区别直接影响结果语义。下游若收到同一窗口的多次结果,应使用可更新的表、带主键的 Upsert Sink,或自行定义去重规则;把每次触发都当成独立新增记录,可能造成重复统计。
时间语义与迟到数据
处理时间窗口依据算子机器的当前时间,配置简单,但结果会受网络抖动和积压影响。事件时间窗口依据记录中的业务时间,并通过 Watermark 判断事件时间推进程度,更适合订单、日志等需要按真实发生时间统计的场景。
事件时间到达窗口结束位置后通常触发计算。设置允许迟到时间后,窗口状态会继续保留一段时间,迟到记录可能更新已输出结果;超过保留范围的记录会被丢弃,或在配置侧输出后进入补偿链路。
选择窗口函数
| 计算方式 | 状态特点 | 适用场景 |
|---|---|---|
reduce |
每来一条立即合并,状态小 | 同类型求和、最大值 |
aggregate |
自定义累加器,可输出不同类型 | 平均值、复合指标 |
process |
可访问窗口边界和上下文,单独使用时需保留全部元素 | 需要窗口元数据或全量遍历 |
生产中常用“增量聚合函数 + ProcessWindowFunction”组合:前者压缩状态,后者补充窗口起止时间等元数据。只有确实需要逐条查看窗口内全部元素时,才单独使用全量处理函数。
建模检查
设计窗口任务时依次确认业务键、窗口范围、时间语义、触发条件、迟到处理和下游更新能力。任何一项不明确,都可能出现跨用户混算、窗口不触发、结果重复或状态长期不释放。