
大数据与流处理 / 系统课时
异步 I/O
异步 I/O
本课解决流处理调用数据库或远程接口时吞吐量骤降的问题。你将用 Flink Async I/O 并发提交请求,正确完成回调,并根据业务要求配置超时、并发容量和结果顺序。
学习目标
- 理解同步阻塞调用为何会限制算子吞吐量
- 使用
RichAsyncFunction和AsyncDataStream完成异步查询 - 能选择有序或无序输出,并配置超时与容量
同步调用的问题
在普通 map 或 process 函数中直接执行 JDBC、HTTP 或 RPC 请求,会占用算子主线程直到远程响应。假设单次请求耗时 100 毫秒,一个并行实例每秒理论上只能处理约 10 条数据,远程服务的等待时间会直接转化为反压。
Async I/O 会快速发起多个请求,把未完成请求登记为进行中任务;远程结果返回后,再通过 ResultFuture 交给 Flink。算子线程不必逐条等待,因此可以利用远程服务允许的并发能力。
执行流程与参数
timeout 限制单个请求允许等待的最长时间,capacity 限制每个异步算子实例同时进行中的请求数量。容量用满后,上游会受到反压,所以它既是吞吐参数,也是保护远程服务的并发上限。
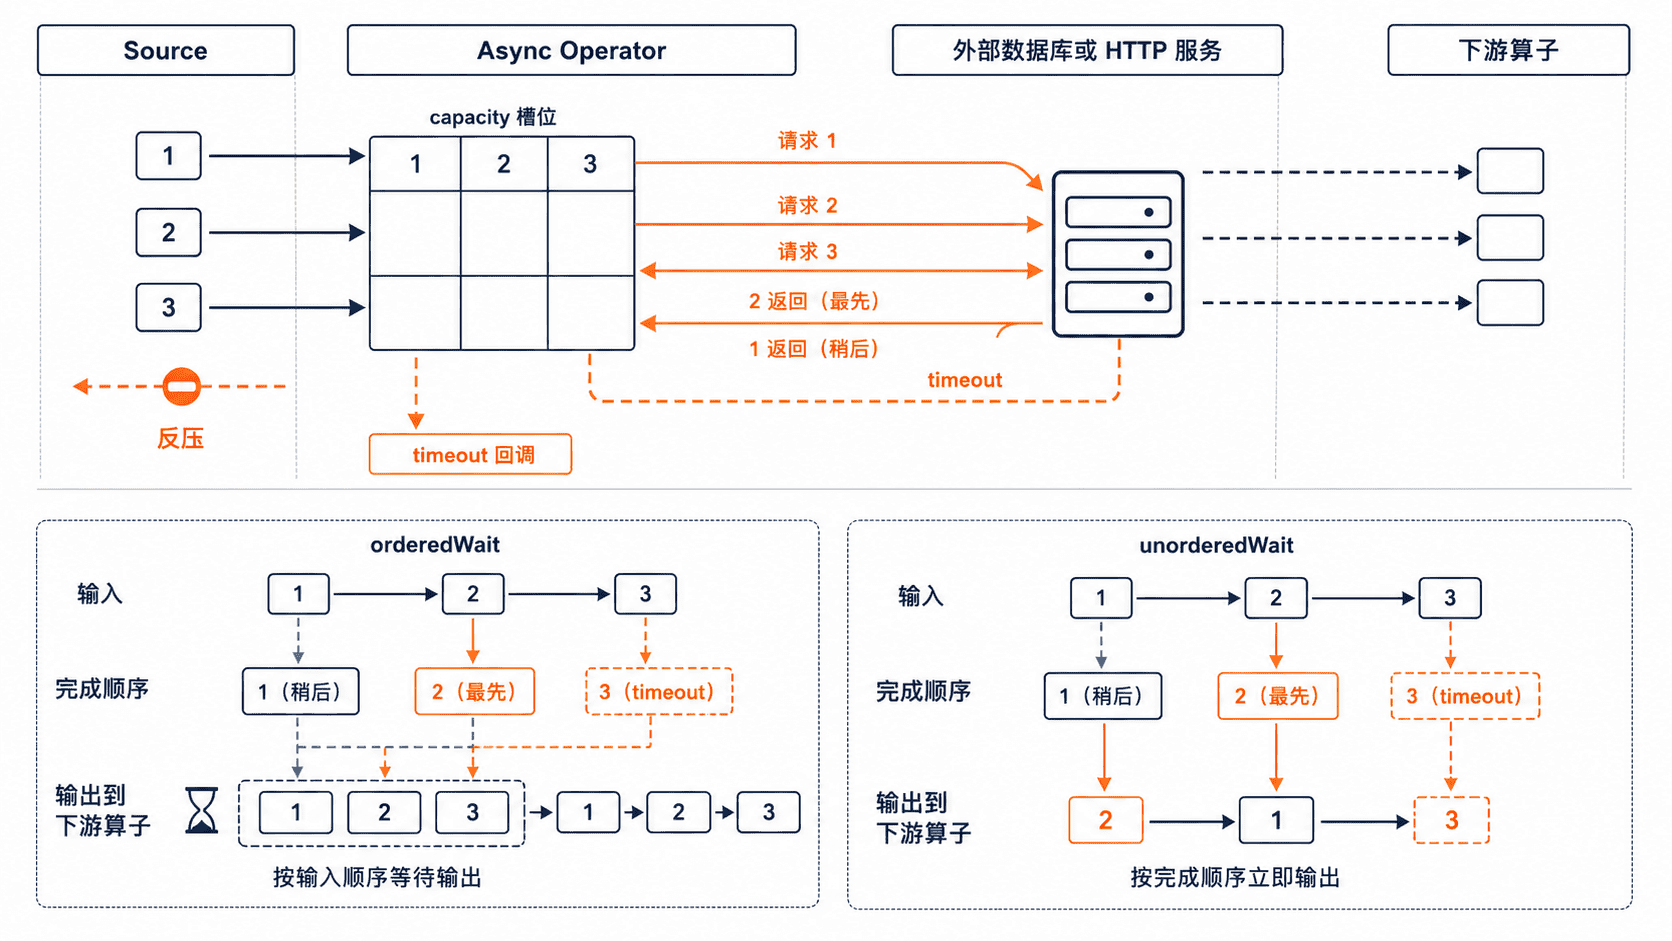
orderedWait 保持输入顺序:即使后面的请求先完成,也要等待前面的结果,适合结果顺序有业务含义的场景。unorderedWait 按完成顺序输出,等待更少、吞吐通常更高,适合每条记录相互独立的富化任务。
并行度为 、每个实例容量为 时,算子层面的最大进行中请求数约为 。实际值还受连接池、远程服务限流和客户端线程池约束。
完整示例
下面的程序模拟异步查询用户等级。用户 2 的请求更快完成,但代码使用 orderedWait,因此输出仍保持 1、2、3 的输入顺序。
import org.apache.flink.api.common.functions.OpenContext;
import org.apache.flink.streaming.api.datastream.AsyncDataStream;
import org.apache.flink.streaming.api.datastream.DataStream;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.streaming.api.functions.async.ResultFuture;
import org.apache.flink.streaming.api.functions.async.RichAsyncFunction;

import java.util.Collections;
import java.util.concurrent.CompletableFuture;
import java.util.concurrent.CompletionException;
import java.util.concurrent.ExecutorService;
import java.util.concurrent.Executors;
import java.util.concurrent.TimeUnit;

public class AsyncIoDemo {
    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env =
                StreamExecutionEnvironment.getExecutionEnvironment();
        env.setParallelism(1);

        DataStream<Long> userIds = env.fromElements(1L, 2L, 3L);

        DataStream<String> profiles = AsyncDataStream.orderedWait(
                userIds,
                new UserProfileAsyncFunction(),
                2,
                TimeUnit.SECONDS,
                20);

        profiles.print().setParallelism(1);
        env.execute("async-io-demo");
    }

    public static class UserProfileAsyncFunction
            extends RichAsyncFunction<Long, String> {
        private transient ExecutorService pool;

        @Override
        public void open(OpenContext openContext) {
            // 演示使用独立线程池;生产环境优先采用客户端原生异步 API
            pool = Executors.newFixedThreadPool(4);
        }

        @Override
        public void asyncInvoke(
                Long userId, ResultFuture<String> resultFuture) {
            CompletableFuture
                    .supplyAsync(() -> queryProfile(userId), pool)
                    .thenAccept(profile ->
                            resultFuture.complete(
                                    Collections.singleton(profile)))
                    .exceptionally(error -> {
                        resultFuture.completeExceptionally(error);
                        return null;
                    });
        }

        @Override
        public void timeout(
                Long userId, ResultFuture<String> resultFuture) {
            // 超时策略也可以改为失败、重试或输出到侧输出流
            resultFuture.complete(Collections.singleton(
                    "userId=" + userId + ", level=TIMEOUT"));
        }

        private String queryProfile(Long userId) {
            try {
                Thread.sleep(userId == 2L ? 50L : 120L);
            } catch (InterruptedException e) {
                Thread.currentThread().interrupt();
                throw new CompletionException(e);
            }
            return "userId=" + userId + ", level=L" + userId;
        }

        @Override
        public void close() {
            pool.shutdownNow();
        }
    }
}
预期输出如下。虽然用户 2 的模拟查询先完成,orderedWait 仍按输入顺序发出结果。
userId=1, level=L1
userId=2, level=L2
userId=3, level=L3
把 orderedWait 改为 unorderedWait 后,结果可能先出现用户 2;各条记录内容不变,但行序不再保证。
超时、容量与资源保护
超时值应略高于远程服务正常高分位延迟,并低于业务允许的端到端时限。过短会制造大量假超时,过长会让进行中请求长期占用容量。超时后的动作必须明确:返回降级值、让作业失败、有限重试,或记录到侧输出流等待补偿。
容量不能只按 Flink 吞吐需求放大。应同时满足“算子并行度 × capacity”不超过数据库连接池、HTTP 连接池和下游服务允许的并发量。容量过大可能把暂时抖动放大为连接耗尽或雪崩。
示例用线程池包装阻塞方法只是教学方案。生产环境优先使用真正的异步 JDBC、HTTP 或 RPC 客户端;否则线程池只是把阻塞从算子线程转移到工作线程,仍需严格限制队列和线程数。
验证与排错
若吞吐没有改善,先确认 asyncInvoke 是否立即返回,以及远程客户端是否真正异步。若回调迟迟不完成,检查每条分支是否都调用了 complete 或 completeExceptionally;遗漏完成会永久占用容量并触发反压。
若频繁超时,联合检查远程服务延迟、连接池等待、线程池队列和 Flink 反压指标。若有序模式延迟明显偏高,可在业务允许时改为无序模式,避免前一条慢请求阻塞后续已完成结果。