
大数据与流处理 / 系统课时
创建数据源
创建数据源
本课解决 DataStream 程序“数据从哪里来”的问题。你将用内置集合源和序列源创建可运行的数据流,观察作业结束行为,并建立有界源与无界源的判断标准,为后续接入文件、消息队列等外部系统打好基础。
学习目标
- 使用
StreamExecutionEnvironment创建集合源和序列源 - 根据数据是否存在结束位置区分有界源与无界源
- 通过控制台输出验证数据源是否按预期工作
数据源在作业中的位置
数据源是 DataStream 作业的入口。它负责读取外部数据、生成记录并交给下游算子。一个作业可以包含多个数据源,但每条数据都必须先由某个 Source 进入执行图。
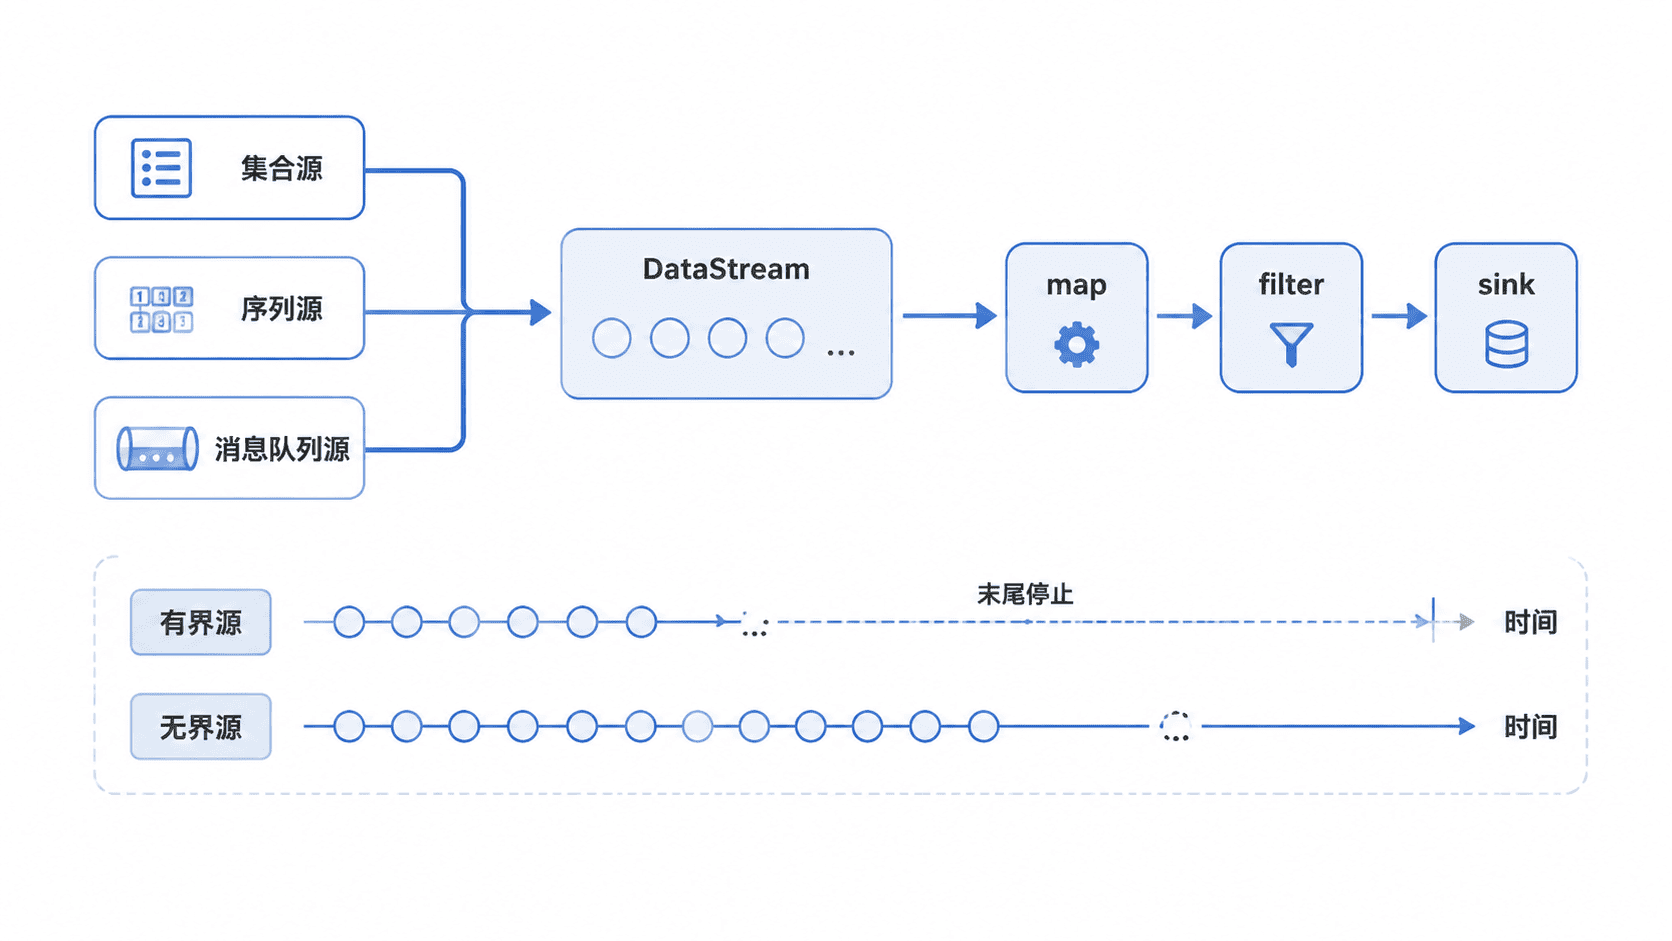
StreamExecutionEnvironment 既保存作业配置,也负责把数据源和算子组织成执行图。调用数据源方法只是在构建作业,最终仍需执行 env.execute()。
创建内置有界数据源
下面的程序使用 fromData 创建固定元素流,使用 fromSequence 创建数字序列流。两者的数据量在提交作业前已经确定,因此都属于有界源。
import org.apache.flink.streaming.api.datastream.DataStream;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;

public class BuiltInSourceDemo {

    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env =
                StreamExecutionEnvironment.getExecutionEnvironment();
        env.setParallelism(1);

        // 固定元素适合单元验证、教学演示和构造少量测试数据
        DataStream<String> users =
                env.fromData("alice", "bob", "carol");

        // 序列源可并行生成闭区间内的 long 值
        DataStream<Long> orderIds =
                env.fromSequence(1001L, 1003L);

        users.map(name -> "user=" + name).print("users");
        orderIds.map(id -> "orderId=" + id).print("orders");

        env.execute("built-in-source-demo");
    }
}
预期输出如下。两个流之间的打印顺序可能不同,但每条记录只会出现一次。
users> user=alice
users> user=bob
users> user=carol
orders> orderId=1001
orders> orderId=1002
orders> orderId=1003
fromData 创建的源默认并行度为 1,适合小规模测试数据;fromSequence 可以按源并行度拆分区间。需要严格观察顺序时,可像示例一样把并行度设为 1。
区分有界源与无界源
判断数据源是否有界,关键不是“当前数据多不多”,而是源能否明确知道不会再有新记录。
| 判断项 | 有界源 | 无界源 |
|---|---|---|
| 是否存在结束位置 | 存在 | 通常不存在 |
| 读完后作业行为 | Source 结束,下游处理完后退出 | 持续等待并处理新事件 |
| 常见例子 | 固定集合、有限序列、一次性文件 | Kafka 主题、持续日志、设备事件 |
| 常用执行语义 | 批式或流式 | 流式 |
无界不等于永远不停止。运维人员可以取消作业,源也可能因故障中断;这里的“无界”只表示数据模型没有预先确定的最后一条记录。
选择数据源时的检查顺序
先确认数据是否需要重放和故障恢复,再确认吞吐量、并行读取能力以及是否提供事件时间。集合源和序列源适合本地验证,不应代替生产消息队列或文件连接器。
还要避免把大量业务数据直接写入 fromData。这些数据会随作业定义一起提交,既增加客户端内存和提交体积,也不利于并行读取。生产数据应放在可恢复、可扩展的外部存储中。
验证与常见问题
程序没有输出时,先检查是否调用了 env.execute();只定义 Source 和算子不会真正启动作业。输出顺序与预期不同通常由并行执行造成,不代表数据丢失,可暂时设置并行度为 1 进行教学验证。
若项目使用较旧的 Flink 版本,可能看到 fromElements 或 fromCollection。它们与这里的固定数据源用途相近,但新版本代码应优先采用 fromData,避免继续依赖已进入弃用流程的接口。