
大数据与流处理 / 系统课时
维表关联
维表关联
本课完成一个可落地的 Lookup Join:实时订单到达后,Flink 按客户编号查询 MySQL 维表,把客户名称和等级补充到事实流中,并说明处理时间、主键、缓存与数据库压力之间的关系。
学习目标
- 理解 Lookup Join 的查询时机和适用边界
- 使用 JDBC 维表完成实时事实流关联
- 能够验证结果并排查常见的关联失败
Lookup Join 的工作方式
普通流式 Join 往往需要把两侧数据都保存在 Flink 状态中。Lookup Join 不同:事实流每到一条记录,运行时根据关联键向外部系统查询当前维度值,再把查询结果拼接到事实记录上。
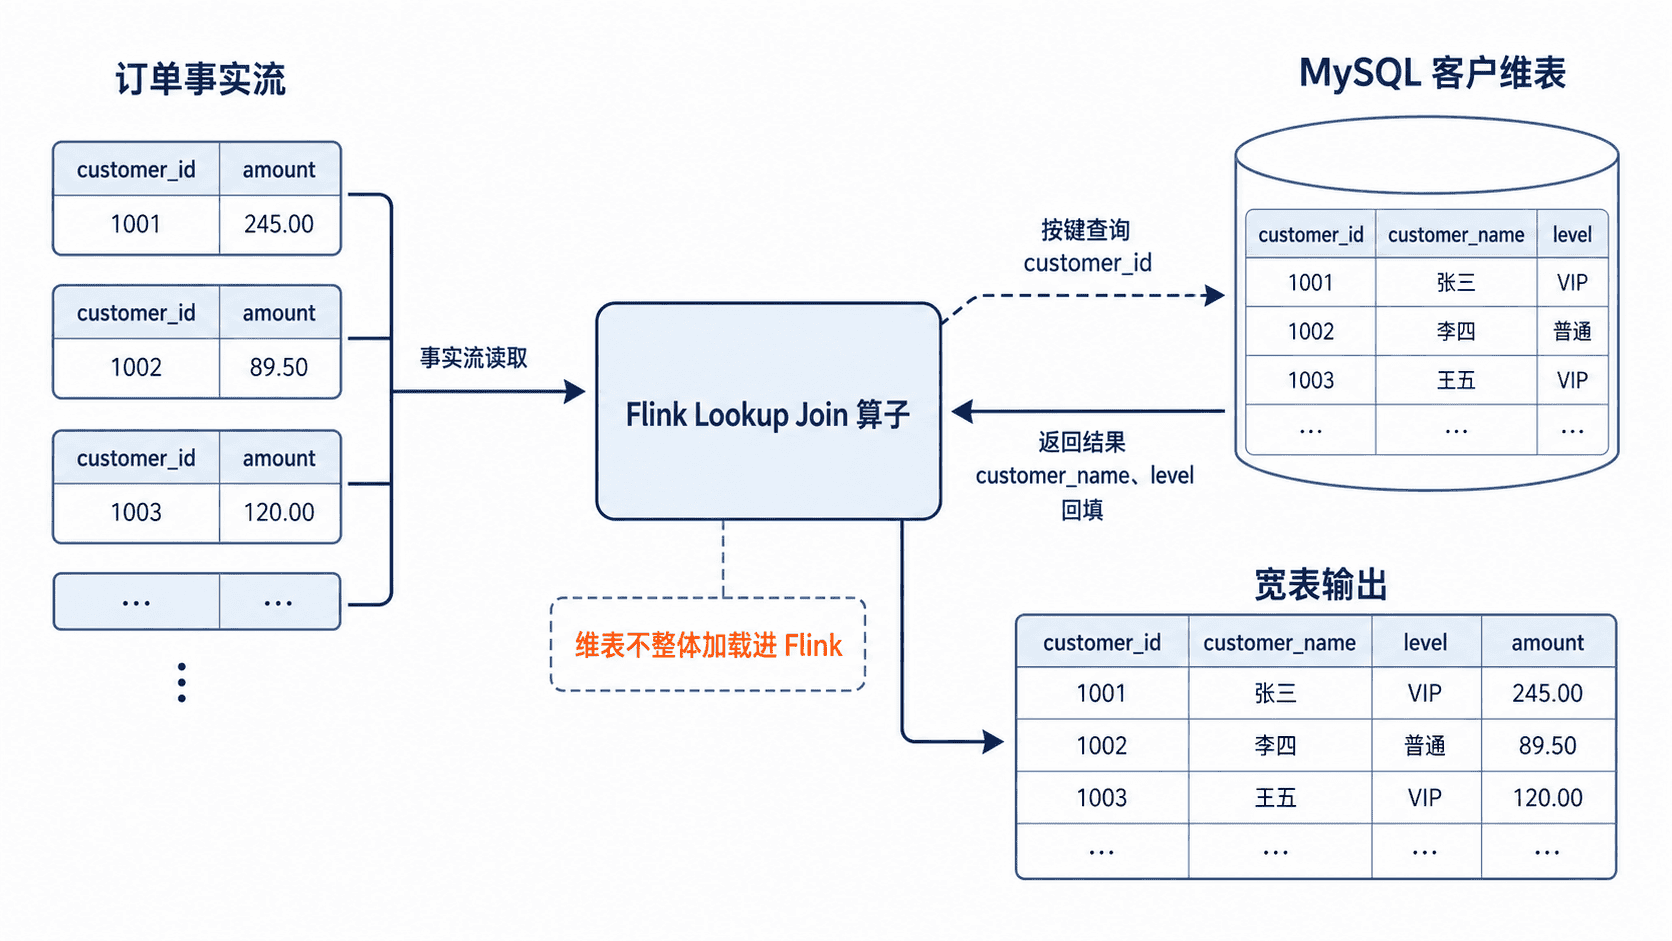
SQL 中必须为事实表提供处理时间属性,并使用 FOR SYSTEM_TIME AS OF 指定查询时刻。对于 JDBC 维表,这表示每条事实记录到达算子时,查询外部数据库中当时可见的最新维度值,而不是回溯历史版本。
准备 MySQL 维表
先在 MySQL 中创建客户维表并写入两条测试数据。customer_id 必须能够唯一定位一行,否则查询结果可能重复或不稳定。
CREATE TABLE customer_dim (
    customer_id BIGINT PRIMARY KEY,
    customer_name VARCHAR(64) NOT NULL,
    level_name VARCHAR(32) NOT NULL
);

INSERT INTO customer_dim(customer_id, customer_name, level_name)
VALUES
    (101, 'Alice', 'GOLD'),
    (102, 'Bob', 'SILVER');

SELECT customer_id, customer_name, level_name
FROM customer_dim
ORDER BY customer_id;
预期结果:
+-------------+---------------+------------+
| customer_id | customer_name | level_name |
+-------------+---------------+------------+
|         101 | Alice         | GOLD       |
|         102 | Bob           | SILVER     |
+-------------+---------------+------------+
实际数据库名、账号和密码应由环境变量或安全配置提供,不要把生产凭证直接写入课程脚本。
在 Flink SQL 中完成关联
下面示例假设订单来自 Kafka。运行前需要把与当前 Flink 版本匹配的 Kafka SQL Connector 和 JDBC Connector JAR 放入 <PATH>/lib,并重启 SQL Client。示例中的 <HOST>、<PORT>、<DATABASE> 和 <PASSWORD> 需要替换为实际值。
CREATE TABLE orders (
    order_id BIGINT,
    customer_id BIGINT,
    amount DECIMAL(12, 2),
    proc_time AS PROCTIME()
) WITH (
    'connector' = 'kafka',
    'topic' = 'orders',
    'properties.bootstrap.servers' = '<HOST>:<PORT>',
    'properties.group.id' = 'lookup-join-demo',
    'scan.startup.mode' = 'earliest-offset',
    'format' = 'json'
);

CREATE TABLE customer_dim (
    customer_id BIGINT,
    customer_name STRING,
    level_name STRING,
    PRIMARY KEY (customer_id) NOT ENFORCED
) WITH (
    'connector' = 'jdbc',
    'url' = 'jdbc:mysql://<HOST>:<PORT>/<DATABASE>',
    'table-name' = 'customer_dim',
    'username' = '<USER>',
    'password' = '<PASSWORD>'
);

SELECT
    o.order_id,
    o.customer_id,
    c.customer_name,
    c.level_name,
    o.amount
FROM orders AS o
LEFT JOIN customer_dim FOR SYSTEM_TIME AS OF o.proc_time AS c
ON o.customer_id = c.customer_id;
向 orders 主题写入 {"order_id":9001,"customer_id":101,"amount":88.50} 后,预期查询结果为:
+----------+-------------+---------------+------------+--------+
| order_id | customer_id | customer_name | level_name | amount |
+----------+-------------+---------------+------------+--------+
|     9001 |         101 | Alice         | GOLD       |  88.50 |
+----------+-------------+---------------+------------+--------+
SQL Client 的列宽、行模式和时间字段展示可能不同,但关联字段应保持一致。使用 LEFT JOIN 时,维表中不存在键值也会保留订单,维度字段为 NULL;使用 JOIN 时,该订单不会出现在结果中。
性能与一致性边界
Lookup Join 的吞吐上限通常受维表查询延迟和数据库并发能力影响。事实流量较大时,应先保证关联键命中主键或索引,再根据连接器版本配置查询缓存、超时和重试;缓存能降低数据库压力,但也会让维度变更在缓存失效前不可见。
处理时间 Lookup Join 查询的是“处理到该记录时”的维表值。它适合客户等级、商品信息、地区编码等允许短暂延迟的在线补全,不适合要求严格按事件发生时刻还原历史维度的场景。需要历史一致性时,应使用带版本的变更日志维表和事件时间时态关联。
常见失败处理
No suitable driver 或找不到 connector factory,通常表示 JDBC Connector 或数据库驱动未安装、版本不匹配。维表查询持续超时,应检查数据库连接数、慢查询、网络和关联键索引,而不是盲目增加 Flink 并行度。
关联结果始终为 NULL 时,依次核对两侧字段类型、键值内容、数据库权限和表名大小写。可先在 MySQL 中用同一个 customer_id 执行单行查询,确认维表确实能够命中。