
大数据与流处理 / 系统课时
写入 Kafka
写入 Kafka
本课完成一个可运行的 Kafka Sink 作业:把 Flink 中的处理结果写入 processed-orders 主题,并通过检查点与 Kafka 事务实现精确一次提交,同时给出至少一次模式的适用边界。
学习目标
- 使用
KafkaSink配置目标主题和序列化方式 - 区分
AT_LEAST_ONCE与EXACTLY_ONCE的提交机制 - 掌握事务前缀、检查点和下游隔离级别的验证方法
Kafka Sink 的提交机制
Kafka Sink 先把记录交给 Kafka Producer。至少一次模式会在检查点时等待缓冲区记录被确认,故障恢复后可能重发;精确一次模式则把一批记录写入 Kafka 事务,只有对应 Flink 检查点完成后才提交事务,失败或取消时未提交事务不会成为已提交数据。
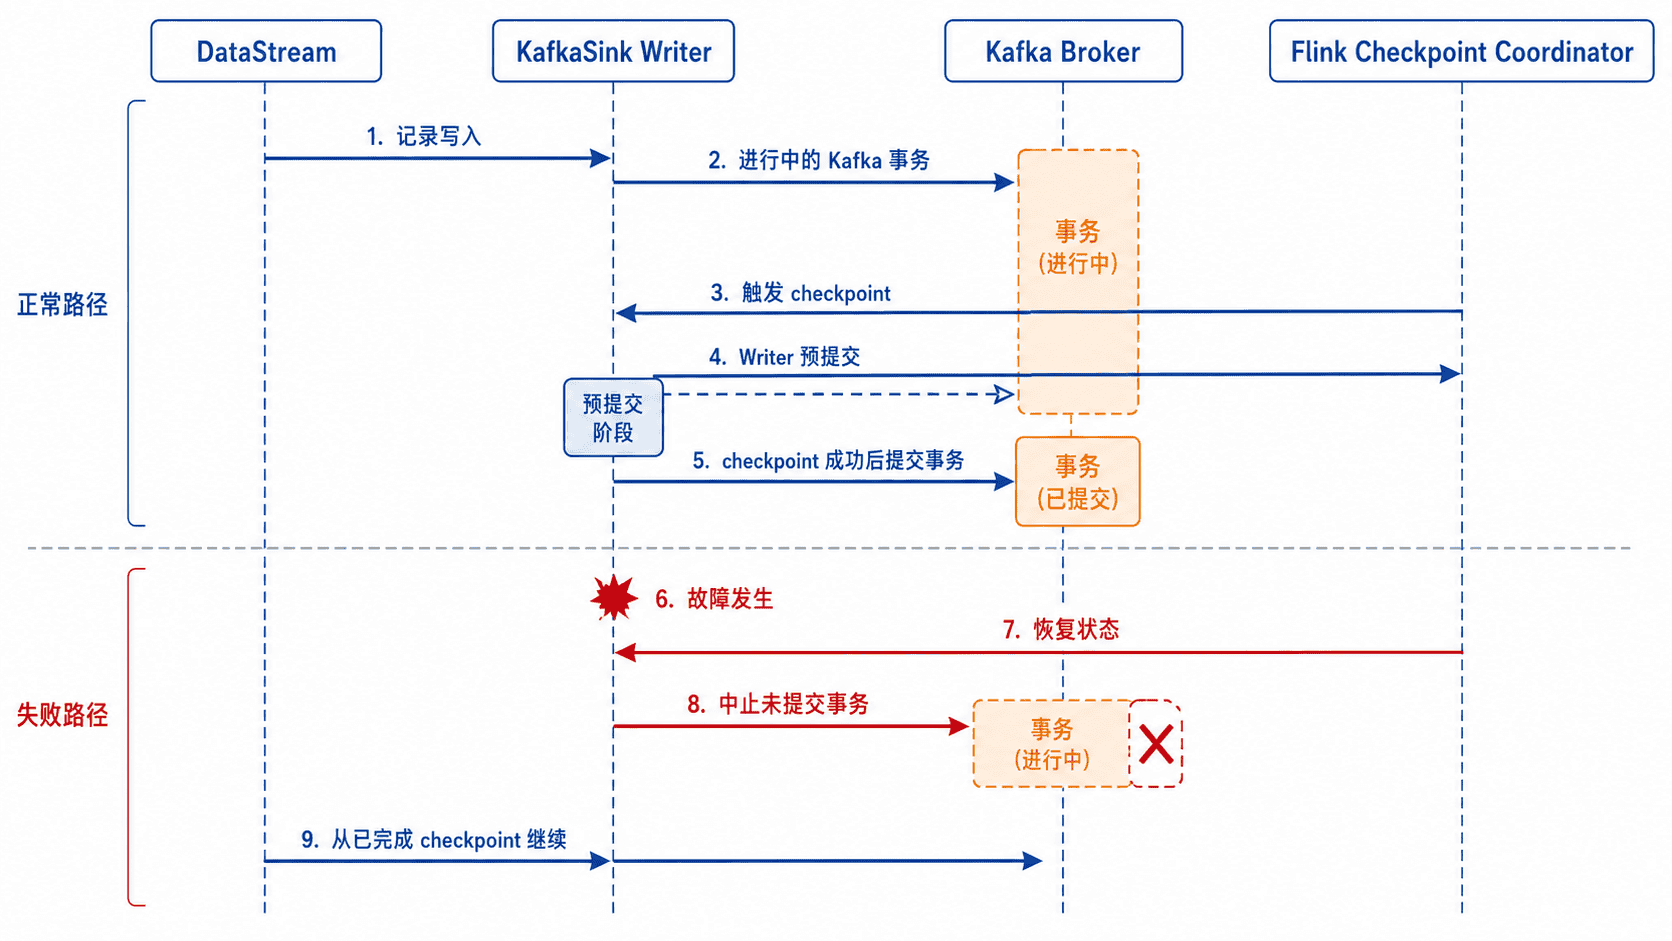
项目需要引入与当前 Flink 版本兼容的 Kafka 连接器。不要同时混用旧版 FlinkKafkaProducer 与新版 KafkaSink API。
<dependency>
    <groupId>org.apache.flink</groupId>
    <artifactId>flink-connector-kafka</artifactId>
    <version>${flink.kafka.connector.version}</version>
</dependency>
这段配置是依赖片段。替换为项目实际兼容版本后,应确认提交包或集群插件目录中能够加载连接器。
完整精确一次示例
下面的程序生成两条订单结果,转换为大写后写入 Kafka。精确一次模式必须启用 Checkpoint,并为每个并发作业实例设置稳定且不冲突的事务 ID 前缀。
import org.apache.flink.connector.base.DeliveryGuarantee;
import org.apache.flink.connector.kafka.sink.KafkaRecordSerializationSchema;
import org.apache.flink.connector.kafka.sink.KafkaSink;
import org.apache.flink.api.common.serialization.SimpleStringSchema;
import org.apache.flink.streaming.api.CheckpointingMode;
import org.apache.flink.streaming.api.datastream.DataStream;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;

public class WriteKafkaJob {

    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env =
                StreamExecutionEnvironment.getExecutionEnvironment();
        env.setParallelism(1);

        // Kafka 事务提交与 Flink 检查点完成绑定
        env.enableCheckpointing(10_000);
        env.getCheckpointConfig()
                .setCheckpointingMode(CheckpointingMode.EXACTLY_ONCE);

        DataStream<String> result = env
                .fromElements("order-1001,88", "order-1002,128")
                .map(String::toUpperCase);

        KafkaSink<String> sink = KafkaSink.<String>builder()
                .setBootstrapServers("localhost:9092")
                .setRecordSerializer(
                        KafkaRecordSerializationSchema.builder()
                                .setTopic("processed-orders")
                                .setValueSerializationSchema(
                                        new SimpleStringSchema())
                                .build())
                .setDeliveryGuarantee(DeliveryGuarantee.EXACTLY_ONCE)
                .setTransactionalIdPrefix("flink-practice-orders-")
                .build();

        result.sinkTo(sink).name("kafka-processed-orders-sink");
        env.execute("write-kafka-orders");
    }
}
预期结果。作业保持运行,并在首个成功 Checkpoint 完成后把两条记录作为已提交事务写入 processed-orders;业务结果通过下面的消费者命令验证。作业启动后,使用已提交隔离级别读取目标主题:
bin/kafka-console-consumer.sh \
  --bootstrap-server localhost:9092 \
  --topic processed-orders \
  --from-beginning \
  --isolation-level read_committed \
  --max-messages 2
预期输出
ORDER-1001,88
ORDER-1002,128
控制台中的客户端日志、耗时和分区信息可能不同,但 read_committed 消费者只应看到已经提交的事务记录。
至少一次与精确一次怎么选
| 保证级别 | 写入行为 | 故障后的结果 | 使用条件 |
|---|---|---|---|
NONE |
不等待可靠确认 | 可能丢失,也可能重复 | 只适合可丢弃的低价值数据 |
AT_LEAST_ONCE |
检查点时等待未完成记录被确认 | 不丢失,但恢复时可能重复 | 下游可按业务键幂等 |
EXACTLY_ONCE |
记录进入 Kafka 事务,检查点成功后提交 | 已提交结果不重复 | 必须启用 Checkpoint,并正确配置事务 |
若业务可以使用订单号、事件 ID 或版本号去重,至少一次通常更简单,吞吐和运维成本也更可控。只有重复会造成不可接受后果,且下游能够按 read_committed 读取时,才应采用精确一次。
精确一次的关键边界
事务 ID 前缀必须在同时运行的作业实例之间保持唯一。复制作业、蓝绿发布或临时回放时若复用同一前缀,Kafka Producer 可能发生 fencing,旧实例会被新事务生产者阻断。
Kafka 的事务超时必须大于一次事务可能持续的最长时间。检查点间隔、检查点超时、故障恢复时间或长时间背压都可能拉长事务;若 Broker 的事务上限过小,会出现事务超时或提交失败。
精确一次并不是自动覆盖所有外部系统。它描述的是 Flink 状态与 Kafka 事务的协同结果;下游若使用 read_uncommitted,仍可能读到尚未提交或后来被中止的记录。
修复与验收
目标主题没有数据时,先确认作业是否完成过成功 Checkpoint。精确一次事务在首个检查点完成前可能保持未提交状态,read_committed 消费者暂时看不到记录。
出现 ProducerFencedException 时,检查是否有两个作业实例使用相同事务前缀。出现事务超时时,应先排查背压和检查点耗时,再协调 Kafka 的 transaction.max.timeout.ms 与 Producer 事务超时,不能只盲目扩大参数。
最终验收应同时检查 Flink Web UI 中的成功 Checkpoint、Kafka 目标主题内容,以及故障恢复后是否出现业务重复。只看到“消息写进去了”不足以证明精确一次成立。