
大数据与流处理 / 系统课时
建立监控与告警
建立监控与告警
本课把实时交易作业接入 Prometheus 监控链路,建立吞吐、延迟、背压、检查点和业务结果的统一看板,并通过分级告警把“发现异常”变成可执行的处置动作。
学习目标
- 配置 Flink Prometheus 指标暴露与采集
- 建立覆盖系统指标和业务指标的监控面板
- 编写可验证、可降噪的告警规则
设计监控闭环
监控链路应形成“作业暴露指标、Prometheus 采集、Grafana 展示、Alertmanager 通知、值班人员处置”的闭环。吞吐和业务量回答系统处理了多少数据,延迟回答数据多久可见,背压定位上下游速度不匹配,检查点指标判断状态保护是否稳定。
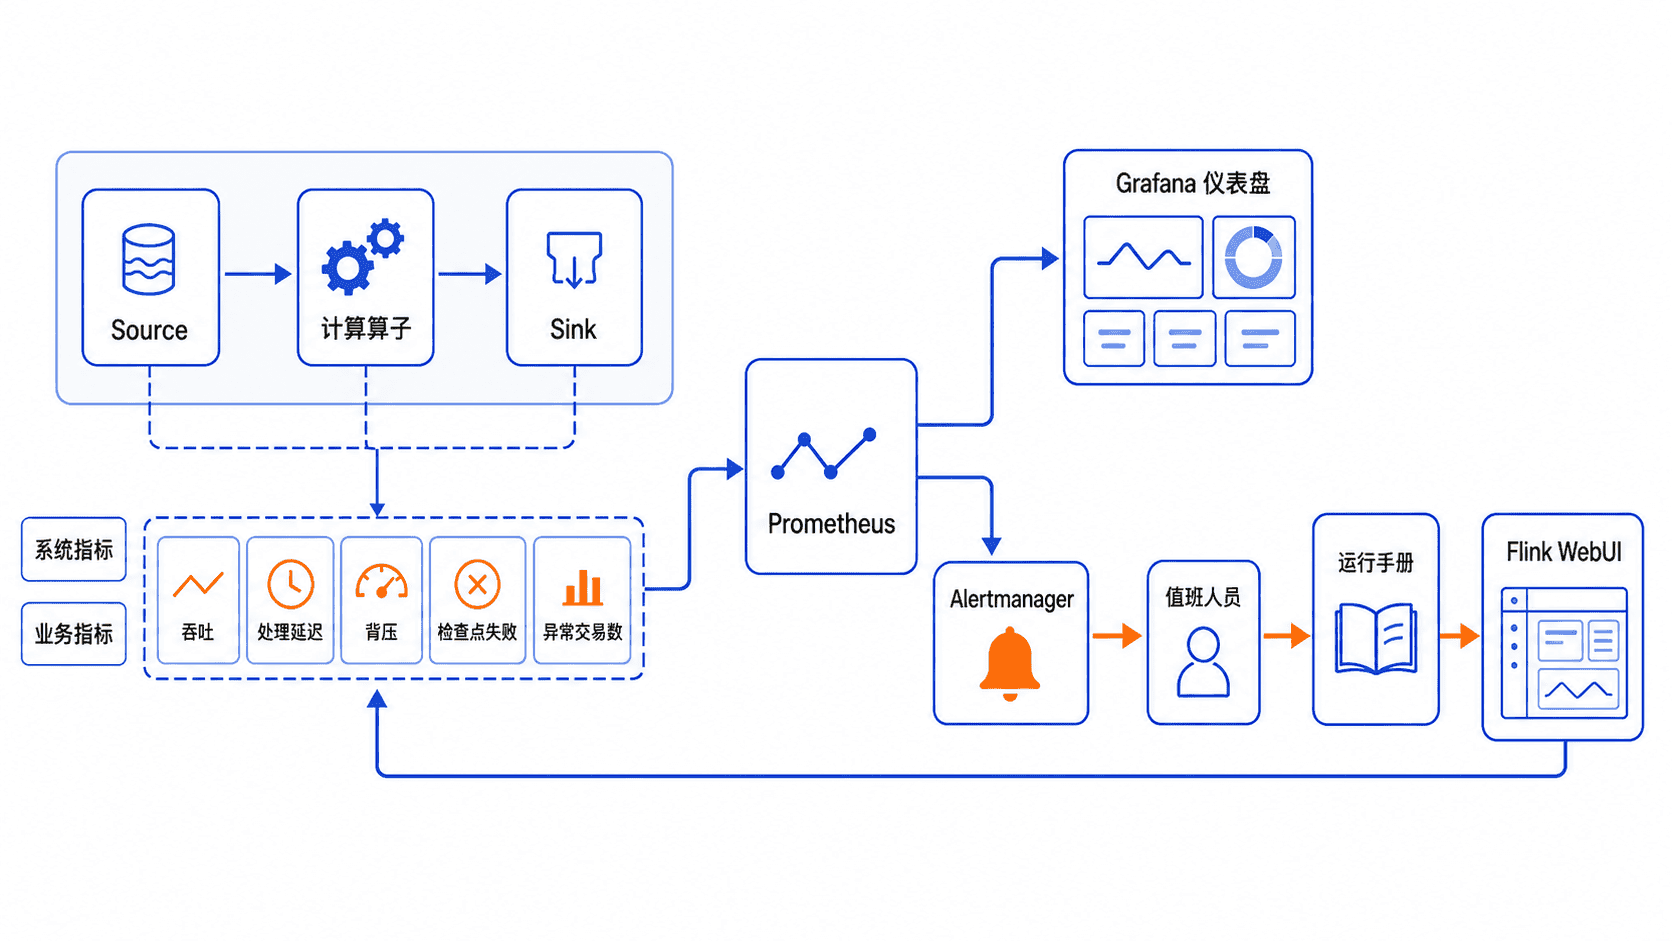
Flink 原生指标系统支持 Counter、Gauge、Histogram 和 Meter,并允许用户函数通过 MetricGroup 注册业务指标;Prometheus Reporter 采用拉取模式并把 Flink 变量转换为标签。:contentReference[oaicite:0]{index=0}
建议至少维护以下口径:
| 维度 | 关键指标 | 主要判断 |
|---|---|---|
| 吞吐 | numRecordsInPerSecond、numRecordsOutPerSecond |
输入与输出是否匹配,吞吐是否达到目标 |
| 延迟 | 业务事件时间到结果写入时间的 P95/P99 | 用户可见结果是否超时 |
| 背压 | backPressuredTimeMsPerSecond |
下游是否持续限制上游 |
| 检查点 | 完成数、失败数、持续时间、对齐时间 | 状态保护是否稳定 |
| 业务 | 成功交易数、异常交易数、重复数、金额差异 | 技术运行是否满足业务正确性 |
暴露并采集 Flink 指标
以下配置适合 JobManager 和 TaskManager 分别运行在独立容器或 Pod、每个实例都可使用 9249 端口的环境。若多个 Flink 进程共享同一主机,应改成端口范围,并使用服务发现采集实际分配端口。
# flink-conf.yaml
metrics.reporter.prom.factory.class: org.apache.flink.metrics.prometheus.PrometheusReporterFactory
metrics.reporter.prom.port: 9249
metrics.reporter.prom.scope.variables.additional: cluster_name:trade-prod,environment:prod
配置生效后,Prometheus Reporter 会在对应进程启动时开放 HTTP 指标端点。Reporter 所需 JAR 必须能被 Flink 启动过程加载;具体放置位置按当前发行包的插件目录约定处理。官方文档同时建议在同机多实例场景使用端口范围避免冲突。:contentReference[oaicite:1]{index=1}
Prometheus 采集配置如下。生产环境通常由 Kubernetes、Consul 或文件服务发现维护目标列表,静态目标只适合固定测试环境。
# prometheus.yml
scrape_configs:
  - job_name: flink-trade
    scrape_interval: 15s
    static_configs:
      - targets:
          - jobmanager:9249
          - taskmanager-1:9249
          - taskmanager-2:9249
重启 Flink 进程和 Prometheus 后,先直接检查指标端点。实际标签和完整指标名前缀会受作用域配置与版本影响,因此应以端点输出为准。
METRICS_HOST="${METRICS_HOST:-127.0.0.1}"
METRICS_PORT="${METRICS_PORT:-9249}"
curl -fsS "http://${METRICS_HOST}:${METRICS_PORT}/metrics"   | grep -E 'numRecords(In|Out)PerSecond|backPressuredTimeMsPerSecond|numberOfFailedCheckpoints|lastCheckpointDuration'   | head
预期输出
flink_taskmanager_job_task_operator_numRecordsOutPerSecond{...} <VALUE>
flink_taskmanager_job_task_backPressuredTimeMsPerSecond{...} <VALUE>
flink_jobmanager_job_numberOfFailedCheckpoints{...} <VALUE>
flink_jobmanager_job_lastCheckpointDuration{...} <VALUE><VALUE>、标签集合和指标前缀会随运行状态、作用域和 Flink 版本变化。若没有输出,依次检查 Reporter JAR、启动日志、端口监听、网络策略和 Prometheus Target 状态。
建立仪表盘与告警规则
仪表盘不要只展示集群 CPU。交易项目至少应按“总览、算子、检查点、业务正确性”分组,并同时保留当前值、趋势和分位数。Flink 的背压、空闲和忙碌时间指标在一个采样周期内合计约为 1000 毫秒,可用于区分下游阻塞、数据不足和算子饱和。:contentReference[oaicite:2]{index=2}
下面的告警规则使用指标名后缀匹配,降低不同作用域前缀造成的迁移成本。示例按 60 秒检查点间隔设置 30 秒持续时间阈值,实际阈值必须依据项目 SLO 和稳定压测基线调整。
groups:
  - name: flink-trade-analysis
    rules:
      - alert: FlinkTradeBackpressureHigh
        expr: 'max by (job_name) ({__name__=~"flink_.*_backPressuredTimeMsPerSecond",job_name="trade-analysis"}) > 500'
        for: 5m
        labels:
          severity: warning
        annotations:
          summary: "交易作业持续高背压"

      - alert: FlinkTradeCheckpointFailed
        expr: 'increase({__name__=~"flink_.*_numberOfFailedCheckpoints",job_name="trade-analysis"}[5m]) > 0'
        for: 0m
        labels:
          severity: critical
        annotations:
          summary: "交易作业出现检查点失败"

      - alert: FlinkTradeCheckpointSlow
        expr: 'max by (job_name) ({__name__=~"flink_.*_lastCheckpointDuration",job_name="trade-analysis"}) > 30000'
        for: 10m
        labels:
          severity: warning
        annotations:
          summary: "交易作业检查点持续变慢"
规则加载后,通过 Prometheus 的规则检查工具验证语法,再用测试环境制造短时背压或降低阈值验证通知链路。告警消息必须包含环境、作业名、算子、当前值、持续时间、看板链接和运行手册链接,避免值班人员收到“有问题”却无法定位。
补充业务指标
技术指标只能说明作业是否在运行,不能证明交易结果正确。业务指标至少应包含输入交易数、成功结果数、异常结果数、去重命中数、金额汇总差异和端到端延迟。业务计数用 Counter,当前积压或最近延迟可用 Gauge,延迟分布用 Histogram。
命名应稳定且低基数,例如 trade_success_total、trade_abnormal_total、trade_processing_latency_ms。不要把 trade_id、用户号等高基数字段作为标签,否则会显著增加 Prometheus 时间序列数量。业务标签只保留环境、渠道、结果类型等有限枚举。
验证监控闭环
上线前必须完成一次端到端演练:持续发送测试交易,确认吞吐曲线变化;人为降低下游处理能力,确认背压告警出现;恢复下游后确认告警自动解除;制造一次测试检查点失败,确认严重告警送达;最后核对业务成功数与输入数。
Flink WebUI 能查看检查点总数、完成数、失败数、持续时间和子任务明细;失败检查点统计按尽力而为方式更新,因此最终判断应结合 WebUI、Prometheus 指标与 JobManager 日志。:contentReference[oaicite:3]{index=3}