
大数据与流处理 / 系统课时
压测与项目验收
压测与项目验收
本课把实时交易项目从“能够运行”推进到“可证明达标”:生成可追踪的测试交易,执行阶梯压力和故障恢复测试,再用性能数据与数据库对账给出明确验收结论。
学习目标
- 制定可量化的性能、稳定性和正确性验收标准
- 生成带批次标识、可精确对账的交易流量
- 完成压力测试、故障演练和验收报告
明确验收基线
验收标准必须在测试前冻结,不能看到结果后再修改口径。下面是一组适用于教学环境的示例,生产项目应替换为真实 SLO、资源规模和峰值模型。
| 验收项 | 示例标准 | 证据 |
|---|---|---|
| 稳态吞吐 | 5000 条/秒持续 30 分钟 | 输入、输出吞吐曲线 |
| 处理延迟 | P95 不超过 2 秒,P99 不超过 5 秒 | 业务延迟直方图 |
| 背压 | 平均不超过 10%,不得连续 5 分钟高于 50% | 算子背压曲线 |
| 检查点 | 失败数为 0,P95 持续时间小于 30 秒 | 检查点历史 |
| 故障恢复 | 单个 TaskManager 退出后 2 分钟内恢复并追平积压 | 作业状态与消费延迟 |
| 数据正确性 | 无丢失、无重复、金额汇总一致 | 批次对账 SQL |
Flink WebUI 将背压状态划分为 OK、LOW 和 HIGH,其中不超过 10% 为 OK,高于 50% 为 HIGH;检查点页面可以查看完成、失败、持续时间和子任务明细。:contentReference[oaicite:4]{index=4}
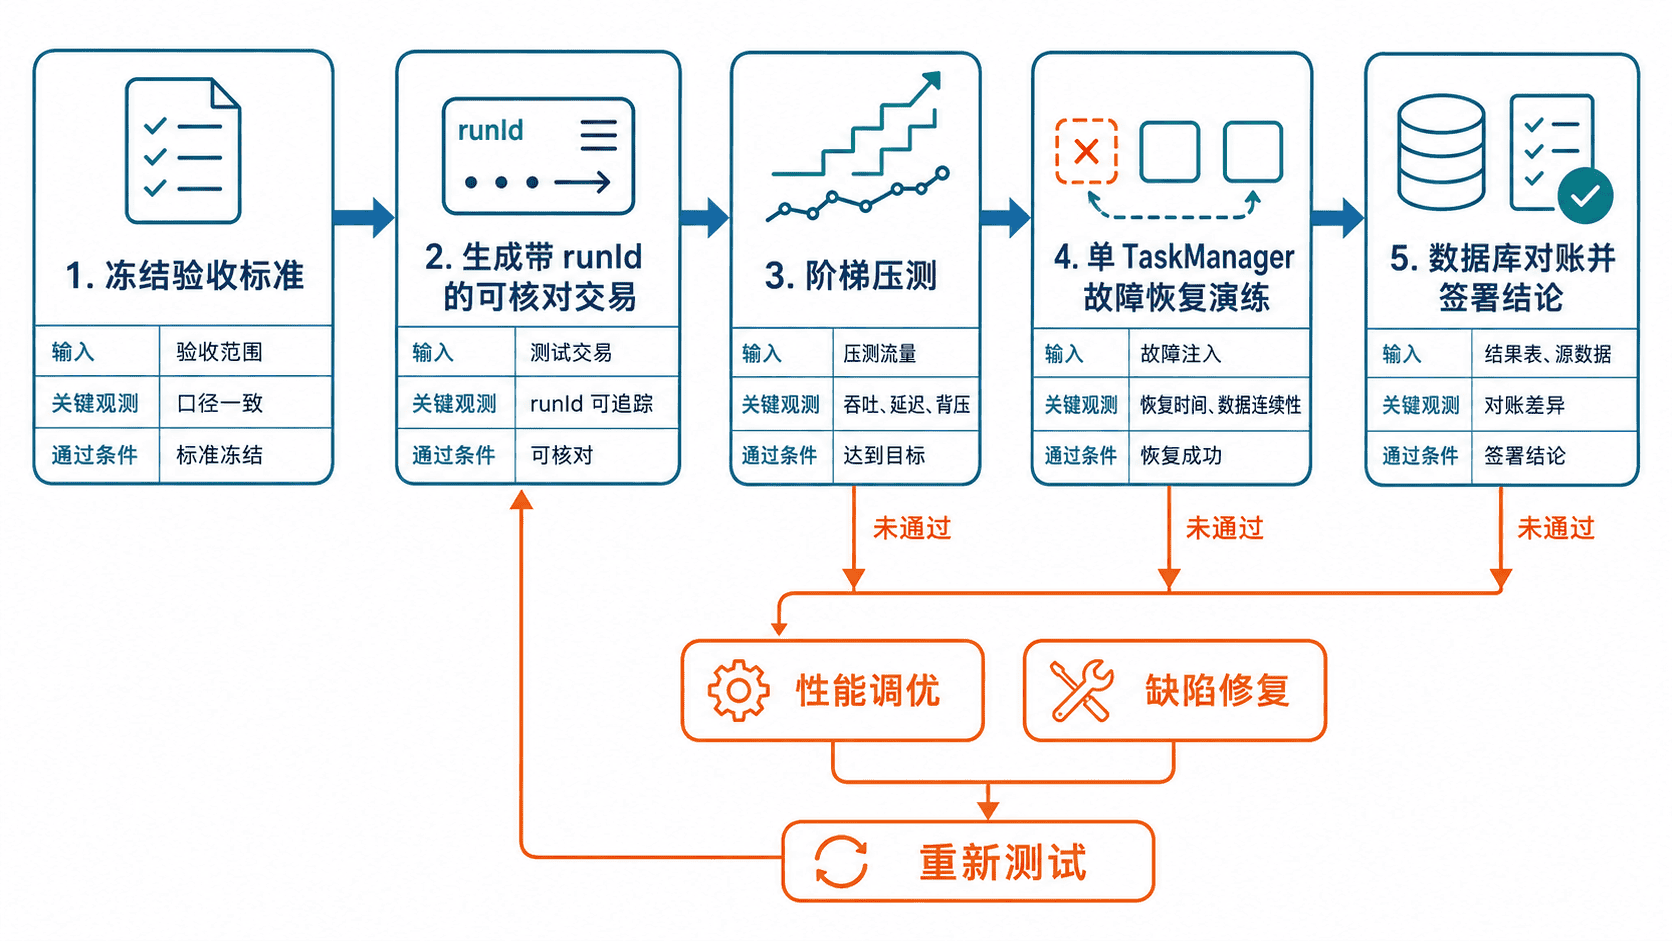
生成可核对的交易流量
压测数据必须带唯一 runId,并使用确定金额,才能在结果库中精确统计总数、唯一数和金额合计。下面的生成器以固定速率向 Kafka 写入 JSON 交易,每条金额为 100 分,发送过程异步化并限制待确认请求数量。依赖文件:
kafka-python>=2.0,<3保存为 requirements.txt 后,在隔离虚拟环境中安装依赖。再将以下程序保存为 trade_load.py。
import argparse
import json
import time
from collections import deque
from datetime import datetime, timezone

from kafka import KafkaProducer

def parse_args() -> argparse.Namespace:
    parser = argparse.ArgumentParser(description="Generate traceable trade events")
    parser.add_argument("--bootstrap-server", required=True)
    parser.add_argument("--topic", required=True)
    parser.add_argument("--qps", type=int, required=True)
    parser.add_argument("--duration", type=int, required=True)
    parser.add_argument("--run-id", required=True)
    return parser.parse_args()

def main() -> None:
    args = parse_args()
    if args.qps <= 0 or args.duration <= 0:
        raise ValueError("qps and duration must be positive")

    producer = KafkaProducer(
        bootstrap_servers=args.bootstrap_server,
        acks="all",
        linger_ms=5,
        key_serializer=lambda value: value.encode("utf-8"),
        value_serializer=lambda value: json.dumps(
            value, ensure_ascii=False, separators=(",", ":")
        ).encode("utf-8"),
    )

    planned = args.qps * args.duration
    pending = deque()
    acked = 0
    started = time.perf_counter()

    for index in range(planned):
        target_time = started + index / args.qps
        sleep_seconds = target_time - time.perf_counter()
        if sleep_seconds > 0:
            time.sleep(sleep_seconds)

        trade_id = f"{args.run_id}-{index:010d}"
        event = {
            "runId": args.run_id,
            "tradeId": trade_id,
            "userId": f"user-{index % 10000:05d}",
            "amountCents": 100,
            "channel": "PRESS_TEST",
            "eventTime": datetime.now(timezone.utc).isoformat(),
        }
        pending.append(producer.send(args.topic, key=trade_id, value=event))

        # 控制未确认请求数量,避免客户端内存随测试时长持续增长。
        if len(pending) >= 5000:
            pending.popleft().get(timeout=30)
            acked += 1

    while pending:
        pending.popleft().get(timeout=30)
        acked += 1

    producer.flush(timeout=30)
    producer.close(timeout=30)
    elapsed = time.perf_counter() - started
    result = {
        "run_id": args.run_id,
        "planned": planned,
        "acked": acked,
        "elapsed_seconds": round(elapsed, 2),
        "actual_tps": round(acked / elapsed, 2),
    }
    print(json.dumps(result, ensure_ascii=False))

if __name__ == "__main__":
    main()
先用 10 分钟目标负载验证链路。将 <ID> 替换为本次测试批次号,且保证下游结果表保留 runId。
RUN_ID="accept-<ID>"
python trade_load.py   --bootstrap-server localhost:9092   --topic trade-events   --qps 5000   --duration 600   --run-id "${RUN_ID}"
预期输出
{"run_id":"accept-<ID>","planned":3000000,"acked":3000000,"elapsed_seconds":<TIME>,"actual_tps":<VALUE>}acked 必须等于 planned。<TIME> 和 <VALUE> 受机器、Kafka 与网络性能影响;若实际吞吐长期低于目标,应先确认压测机是否成为瓶颈,再判断 Flink 作业能力。
执行阶梯压测
不要直接从零跳到峰值。建议依次执行 25%、50%、75%、100% 和 120% 目标负载,每档保持 10 至 30 分钟,记录输入吞吐、输出吞吐、P95/P99 延迟、背压、CPU、内存、GC、Kafka Lag、检查点持续时间和失败数。
每档结束后先判断瓶颈位置:Source 忙而下游空闲,通常是输入不足;中间算子忙且背压向上游传播,通常是计算或数据倾斜;Sink 忙且上游背压,通常是外部存储写入能力不足。重启、扩容或改参数后必须从同一档位重新测试,不能把不同配置的数据拼成一条曲线。
检查点在重背压下可能因屏障传播变慢而出现较高的启动延迟和对齐时间;应优先消除背压根因,再评估缓冲区调整或非对齐检查点。:contentReference[oaicite:5]{index=5}
注入故障并验证恢复
故障演练只允许在隔离测试环境执行,并提前确认 Kafka 和结果库具有足够保留时间。下面命令会停止一个 TaskManager 容器,可能触发任务重启和短时积压;禁止在生产环境照搬,也不要同时停止全部 TaskManager。
docker stop -t 10 flink-taskmanager-1
sleep 30
docker start flink-taskmanager-1
sleep 60
curl -fsS "http://localhost:8081/jobs/<JOB_ID>"   | jq '{jid: .jid, name: .name, state: .state}'
预期输出
{"jid":"<JOB_ID>","name":"trade-analysis","state":"RUNNING"}实际 <JOB_ID> 与恢复时间会不同。通过标准不是“容器重新启动”,而是作业恢复为 RUNNING、检查点重新成功、Kafka Lag 回落到故障前水平,并且本批次数据最终通过对账。Flink 检查点用于保存容错状态,恢复能力还依赖可重放的数据源与兼容的 Sink 语义。:contentReference[oaicite:6]{index=6}
核对数据并形成结论
将生成器字段映射到结果表,并保留 run_id、trade_id 和 amount_cents。以下 SQL 以 300 万条、每条 100 分为例,检查总数、唯一数和金额合计。
SELECT
    COUNT(*) AS total_rows,
    COUNT(DISTINCT trade_id) AS unique_rows,
    SUM(amount_cents) AS total_amount_cents
FROM trade_result
WHERE run_id = 'accept-<ID>';
预期结果
+------------+-------------+--------------------+
| total_rows | unique_rows | total_amount_cents |
+------------+-------------+--------------------+
|    3000000 |     3000000 |          300000000 |
+------------+-------------+--------------------+
若 total_rows 小于生成器的 acked,说明存在未处理或丢失;若 total_rows 大于 unique_rows,说明存在重复;若行数一致但金额不一致,应检查解析、单位换算、聚合和更新语义。对账还应按渠道、时间窗口和结果类型分组,避免总量一致掩盖局部错误。
验收报告至少记录代码版本、配置版本、集群资源、测试批次、负载曲线、故障时间线、监控截图、对账结果、未解决风险和最终结论。只有全部硬性标准通过才能写“验收通过”;性能不足但数据正确应写“有条件通过”或“未通过”,并明确复测条件。