
大数据与流处理 / 系统课时
创建表环境
创建表环境
本课解决 Flink Table API 开发的第一步:如何创建可用的表环境,并明确流模式、配置入口和模块的职责。完成后,你可以在 Java 程序中初始化 TableEnvironment,检查关键配置,并确认当前可用模块。
学习目标
- 创建流模式的
TableEnvironment - 通过
TableConfig设置和读取执行配置 - 理解模块对内置函数解析的影响
表环境负责什么
TableEnvironment 是 Table API 与 Flink SQL 的统一入口,负责注册表、解析 SQL、管理目录与模块、生成执行计划并提交作业。它不是数据源,也不是算子,而是把表定义和 SQL 转换为 Flink 可执行图的上下文。
在只使用 Table API 或 SQL 的程序中,可以直接创建 TableEnvironment。当作业还需要 DataStream API,并且要在流与表之间转换时,通常改用 StreamTableEnvironment,让它与同一个 StreamExecutionEnvironment 共享执行上下文。
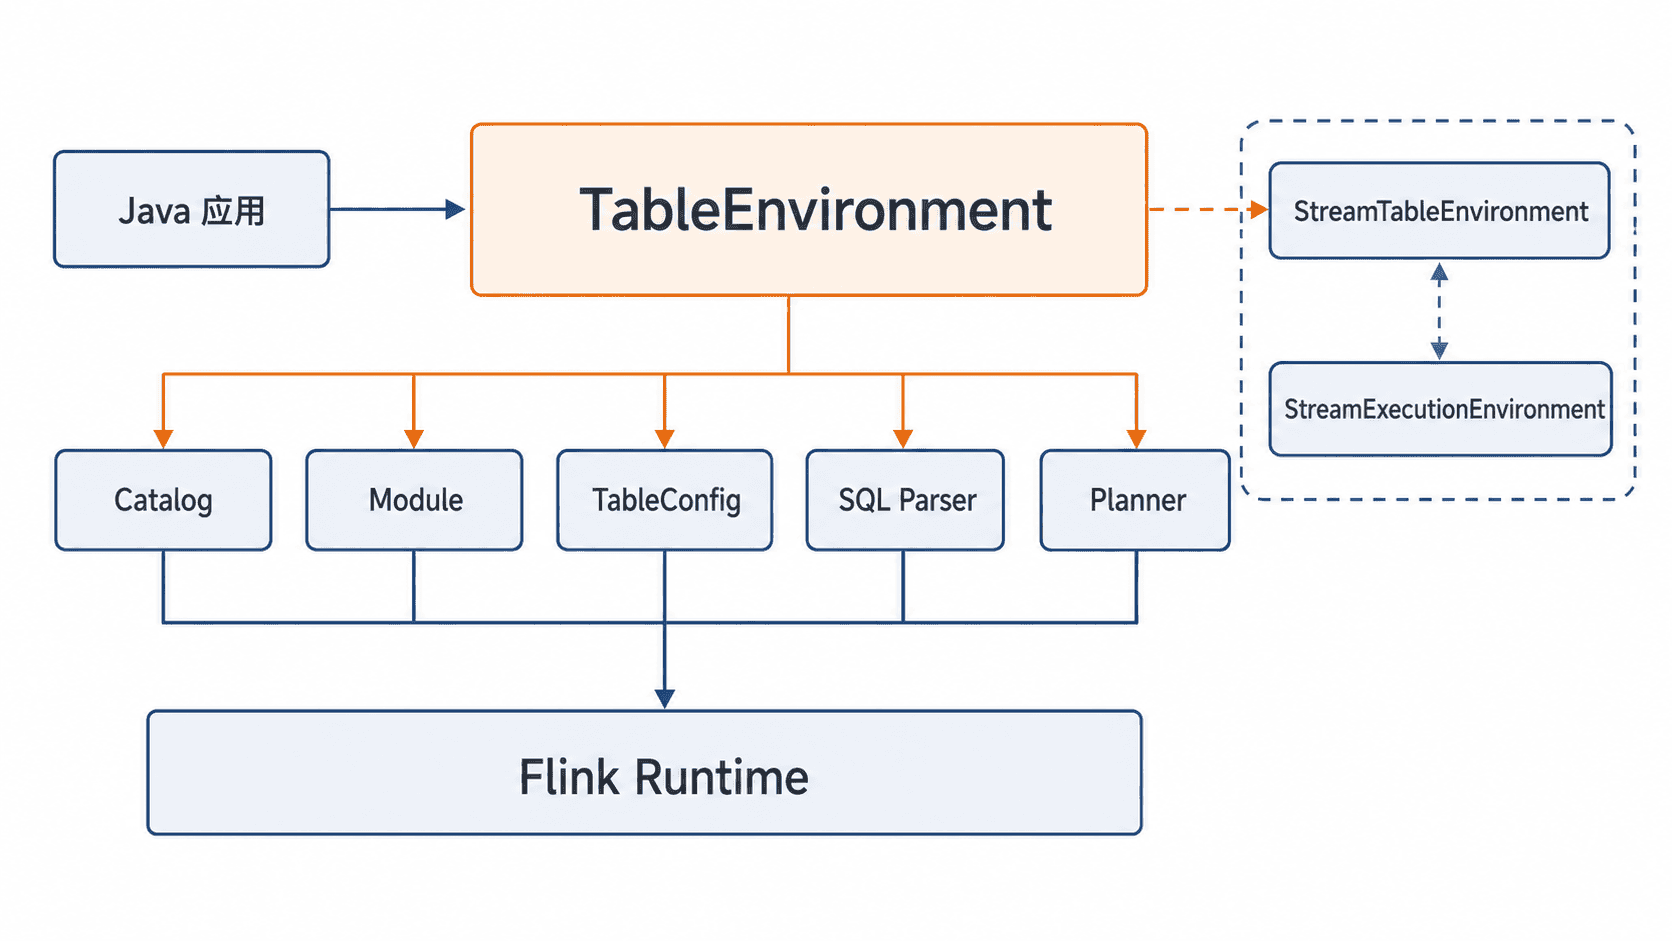
创建流模式环境
下面的程序创建流模式表环境,设置默认并行度,并打印当前模块。示例只依赖 Flink Table API,不需要启动外部数据源。
import org.apache.flink.table.api.EnvironmentSettings;
import org.apache.flink.table.api.TableEnvironment;

public class CreateTableEnvironmentDemo {

    public static void main(String[] args) {
        EnvironmentSettings settings = EnvironmentSettings.newInstance()
                .inStreamingMode()
                .build();

        TableEnvironment tableEnv = TableEnvironment.create(settings);

        // TableConfig 是表执行、优化和时区等配置的统一入口。
        tableEnv.getConfig().getConfiguration().setString(
                "table.exec.resource.default-parallelism", "2");

        String parallelism = tableEnv.getConfig()
                .getConfiguration()
                .getString("table.exec.resource.default-parallelism", "1");

        System.out.println("mode=streaming");
        System.out.println("parallelism=" + parallelism);
        System.out.println("modules=" + String.join(",", tableEnv.listModules()));
    }
}
预期输出:
mode=streaming
parallelism=2
modules=core
若项目额外加载了模块,最后一行会出现更多名称;实际模块列表以运行环境为准。
流模式与批模式
inStreamingMode() 面向持续到达的数据,表查询通常生成长期运行的流作业。inBatchMode() 面向有界数据,优化器可以采用批处理执行策略。模式在创建环境时确定,不应在同一个 TableEnvironment 中途切换。
选择模式时看数据是否有界,而不是看 SQL 是否包含窗口。文件快照、固定分区等有界输入适合批模式;Kafka、CDC 等持续输入适合流模式。
配置入口
表相关配置通过 tableEnv.getConfig() 管理。常见配置包括本地时区、空闲状态保留时间、默认并行度和执行算子行为。配置应在创建表或提交查询前完成,避免同一程序的不同语句使用不一致的上下文。
例如,时间字段需要按业务时区解释时,可以设置 table.local-time-zone。并行度则应结合数据源分区数、下游吞吐和集群资源确定,不宜只为提高速度盲目调大。
模块机制
模块决定当前环境中可见的系统函数及其解析优先级。默认 core 模块提供 Flink 内置函数。加载自定义模块后,可以扩展函数集合;通过调整模块使用顺序,还能控制同名函数优先匹配哪个模块。
模块只影响函数发现和解析,不替代表、目录或连接器。排查“函数不存在”时,应依次确认模块是否已加载、是否位于启用列表中,以及函数名和参数类型是否匹配。