
大数据与流处理 / 系统课时
数据类型与序列化
数据类型与序列化
本课解决 DataStream 中“记录以什么结构流动、运行时怎样传输”的问题。你将认识基础类型、Flink 元组、POJO 与 TypeInformation,并通过可运行示例查看类型推断结果,理解类型设计为什么会影响网络传输、状态存储和作业性能。
学习目标
- 选择适合 DataStream 记录的基础类型、元组或 POJO
- 理解
TypeInformation在类型推断和序列化中的作用 - 识别触发通用序列化的常见写法并主动规避
Flink 为什么需要类型信息
Java 编译后会擦除大量泛型信息,而 Flink 在作业真正执行前就需要知道每条流的记录类型。框架会把推断结果保存为 TypeInformation,再据此创建序列化器、检查键字段,并规划网络传输和状态存储。
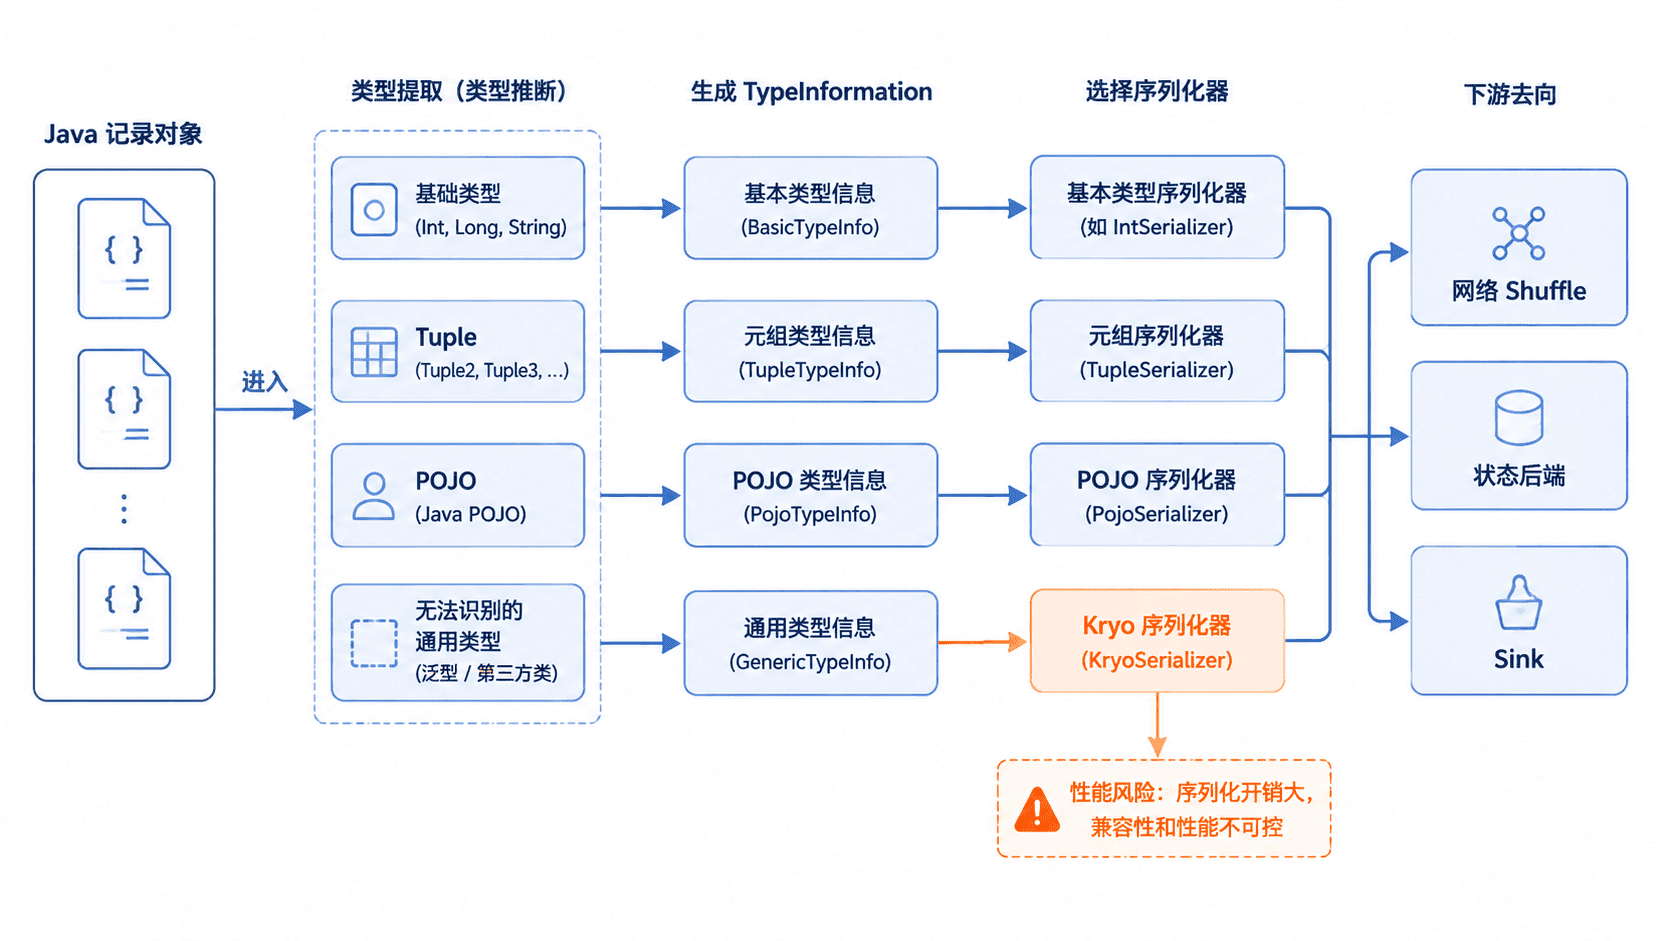
类型信息不是普通的 Java Class。例如 List<String> 和 List<Long> 在运行时都可能只剩 List.class,但 Flink 需要保留元素类型,才能正确生成序列化器。
常用记录类型
基础类型适合单字段流,例如 String、Integer 和 Long。元组适合字段很少、只在局部流转的中间结果;Java API 提供 Tuple0 到 Tuple25,字段通过 f0、f1 等位置访问。
POJO 更适合业务事件。一个典型 Flink POJO 应是公开类,具有公开无参构造器,并让非静态、非瞬态字段保持公开且非 final,或者提供符合 JavaBean 规范的 getter 和 setter。字段有明确名称,可读性通常优于元组。
查看类型推断结果
下面的程序创建 POJO 数据流,再映射为 Tuple2。returns 显式补充输出类型,可避免复杂 Lambda 或泛型方法导致的类型推断失败。
import org.apache.flink.api.common.typeinfo.Types;
import org.apache.flink.api.java.tuple.Tuple2;
import org.apache.flink.streaming.api.datastream.DataStream;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;

public class TypeInformationDemo {

    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env =
                StreamExecutionEnvironment.getExecutionEnvironment();
        env.setParallelism(1);

        DataStream<OrderEvent> events = env.fromData(
                new OrderEvent("A1001", 120),
                new OrderEvent("A1002", 80));

        // 显式声明 Lambda 输出类型,避免泛型擦除造成类型信息缺失
        DataStream<Tuple2<String, Integer>> labels = events
                .map(event -> Tuple2.of(event.orderId, event.amount))
                .returns(Types.TUPLE(Types.STRING, Types.INT));

        System.out.println("eventType="
                + events.getType().getTypeClass().getSimpleName());
        System.out.println("tupleType="
                + labels.getType().getTypeClass().getSimpleName());

        labels.print("orders");
        env.execute("type-information-demo");
    }

    public static class OrderEvent {
        public String orderId;
        public int amount;

        public OrderEvent() {
        }

        public OrderEvent(String orderId, int amount) {
            this.orderId = orderId;
            this.amount = amount;
        }
    }
}
预期输出如下。打印 Sink 的前缀可能因版本略有差异,但类型名称和元组内容应一致。
eventType=OrderEvent
tupleType=Tuple2
orders> (A1001,120)
orders> (A1002,80)
调用 getType() 适合在开发阶段确认推断结果。若实际显示为通用类型,或作业在提交阶段报告无法确定返回类型,应优先检查 POJO 结构和 Lambda 的输出类型。
序列化如何影响性能
数据跨算子网络传输、写入状态或进入检查点时,都需要序列化。基础类型、元组和可识别 POJO 通常能使用 Flink 针对结构生成的序列化器;无法识别的普通对象会被当作通用类型,并可能回退到 Kryo。
通用序列化并非一定错误,但框架无法充分理解对象字段,序列化开销、对象创建和兼容性风险通常更高。高吞吐或大状态作业中,这些差异会放大,因此应优先使用结构稳定且可被 Flink 识别的类型。
常见失误与修复
非静态内部类会隐式持有外部类引用,不适合作为 POJO;应改为顶层类或 public static 嵌套类。只有带参数构造器而没有公开无参构造器,也可能导致 POJO 识别失败。
Lambda 返回泛型容器、匿名类或层层包装的第三方类型时,类型推断容易丢失。可在算子后调用 returns(TypeInformation),或改用具名 MapFunction 明确输入和输出泛型。
不要只为“方便”把所有记录都包装成 Map<String, Object>。这种结构缺少固定字段和稳定类型,既不利于编译期检查,也容易让序列化和状态演进变得不可控。
类型设计检查清单
业务事件优先使用字段清晰的 POJO;短生命周期的两三个字段中间结果可以使用元组;固定单值使用基础类型。提交作业前通过 getType() 或作业计划检查类型是否符合预期,并对通用类型回退进行性能评估。