
大数据与流处理 / 系统课时
Kubernetes 部署
Kubernetes 部署
本课使用 Flink 原生 Kubernetes Application Mode 部署一个独立作业集群,完成镜像准备、命名空间与服务账号配置、作业提交和资源验证。你将理解客户端、JobManager、TaskManager 与 Kubernetes 控制面的协作顺序,并能判断作业结束或失败后资源应处于什么状态。
学习目标
- 说明 Application Mode 中作业与集群的生命周期关系
- 准备包含作业 JAR 的镜像和最小 Kubernetes 权限
- 提交作业并检查 Deployment、Pod、Service 和日志
选择 Application Mode
Application Mode 会为一个应用创建独立集群,作业入口在 JobManager 中执行,适合发布边界清晰、需要独立资源和故障隔离的生产作业。与长期共享的 Session 集群相比,它减少了作业之间的类加载和资源干扰。
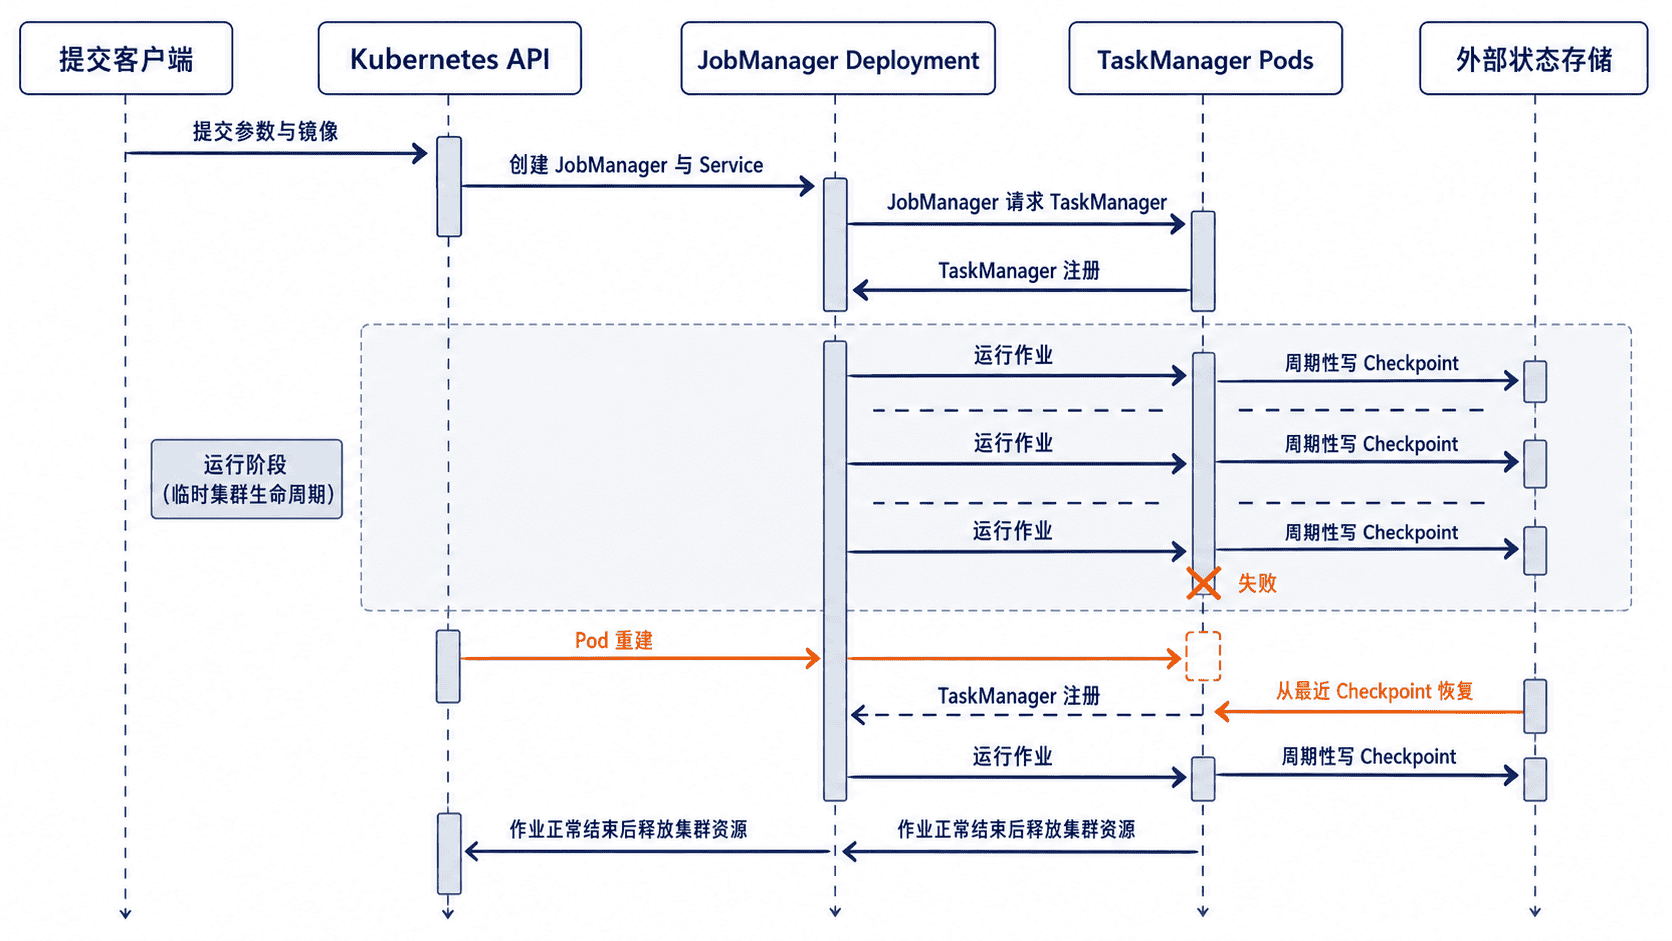
原生部署由 Flink 客户端调用 Kubernetes API 创建集群资源。JobManager 启动后再申请 TaskManager Pod,因此服务账号既要能读取集群状态,也要能在目标命名空间内创建和删除工作负载资源。
构建作业镜像
原生 Application Mode 推荐把 JAR 放入镜像,避免依赖提交机器上的本地文件。项目根目录创建 Dockerfile:
ARG FLINK_BASE_IMAGE
FROM ${FLINK_BASE_IMAGE}

COPY target/app.jar /opt/flink/usrlib/app.jar
构建并推送镜像前,将占位值替换为可访问的镜像仓库与 Flink 版本:
export FLINK_BASE_IMAGE="flink:<FLINK_VERSION>"
export APP_IMAGE="<REGISTRY>/flink-orders:<TAG>"

docker build --build-arg FLINK_BASE_IMAGE="$FLINK_BASE_IMAGE" -t "$APP_IMAGE" .
docker push "$APP_IMAGE"
预期输出的关键结果如下,镜像摘要会因仓库和构建内容而不同:
Successfully tagged <REGISTRY>/flink-orders:<TAG>
<TAG>: digest: sha256:<ID> size: <SIZE>
Kubernetes 节点必须能拉取该镜像。私有仓库还需要配置 imagePullSecrets,否则 JobManager Pod 会停在 ImagePullBackOff。
定义命名空间与权限
创建 k8s-rbac.yaml。示例把内置 edit 角色绑定到专用命名空间中的 flink 服务账号:
apiVersion: v1
kind: Namespace
metadata:
  name: flink
---
apiVersion: v1
kind: ServiceAccount
metadata:
  name: flink
  namespace: flink
---
apiVersion: rbac.authorization.k8s.io/v1
kind: RoleBinding
metadata:
  name: flink-edit
  namespace: flink
subjects:
  - kind: ServiceAccount
    name: flink
    namespace: flink
roleRef:
  apiGroup: rbac.authorization.k8s.io
  kind: ClusterRole
  name: edit
应用并验证服务账号是否能创建 Pod:
kubectl apply -f k8s-rbac.yaml
kubectl auth can-i create pods \
  --as=system:serviceaccount:flink:flink \
  --namespace=flink
预期输出:
yesedit 权限较宽,只应绑定到隔离的专用命名空间。生产环境若多个团队共享命名空间,应改为自定义 Role,仅授权 Flink 所需的 Pod、Service、ConfigMap 和 Deployment 等资源操作。
提交原生 Kubernetes 作业
本机需要可用的 kubectl 上下文和与作业版本匹配的 Flink 客户端。将 $APP_IMAGE 保留为刚推送的镜像,然后执行:
bin/flink run-application \
  -t kubernetes-application \
  -d \
  -Dkubernetes.cluster-id=orders-job \
  -Dkubernetes.namespace=flink \
  -Dkubernetes.container.image="$APP_IMAGE" \
  -Dkubernetes.jobmanager.service-account=flink \
  -Djobmanager.memory.process.size=1600m \
  -Dtaskmanager.memory.process.size=1728m \
  -Dtaskmanager.numberOfTaskSlots=1 \
  -Dparallelism.default=2 \
  local:///opt/flink/usrlib/app.jar
预期输出的关键内容如下,具体措辞和 JobID 会随版本变化:
Cluster started with application id orders-job
Job has been submitted with JobID <ID>
local:///opt/flink/usrlib/app.jar 指的是镜像内路径,不是提交机器路径。若入口类不能从 JAR 清单确定,应在命令中增加 -c <MAIN_CLASS>。
观察资源与生命周期
提交后检查资源和 JobManager 日志:
kubectl get deployment,pod,service -n flink
kubectl logs deployment/orders-job -n flink --tail=100
预期结果中应出现名称包含 orders-job 的 JobManager Deployment、REST Service,以及一个或多个 TaskManager Pod;日志中应看到 TaskManager 注册和作业进入 RUNNING 状态。Pod 名称、IP 和启动时间属于动态值。
运行期间,JobManager 根据并行度和任务槽数量申请 TaskManager。任务失败时,Flink 按重启策略恢复执行;Pod 丢失时,Kubernetes 负责重建容器,Flink 再从可用 Checkpoint 恢复状态。Checkpoint 不应写入 Pod 本地磁盘,应使用对象存储或持久卷。
正常完成的 Application 作业会结束对应集群。需要人工停止时,应先触发 Savepoint 并确认成功,再取消作业;直接删除 Deployment 只适合无状态测试或紧急处置,否则可能丢失最近一次 Checkpoint 之后的数据。