
大数据与流处理 / 系统课时
优化状态与 Checkpoint
优化状态与 Checkpoint
本课解决 Flink 作业状态持续膨胀、Checkpoint 越来越慢和远端存储压力升高的问题。你将先用指标判断瓶颈属于状态体积、对齐、持久化还是配置,再选择不会破坏一致性的优化方案,并完成优化后的验证。
学习目标
- 根据状态大小、耗时和失败率定位 Checkpoint 瓶颈
- 从状态设计、状态后端和 Checkpoint 参数三个层面实施优化
- 用 Flink REST API 验证优化是否真正生效
建立 Checkpoint 诊断链路
Checkpoint 慢不等于状态后端一定慢。一次 Checkpoint 依次经历 Barrier 传播、输入对齐、状态快照和远端持久化,任何一段变慢都会拉长端到端耗时。排查时应同时观察作业背压、end_to_end_duration、对齐耗时、状态大小和失败原因。
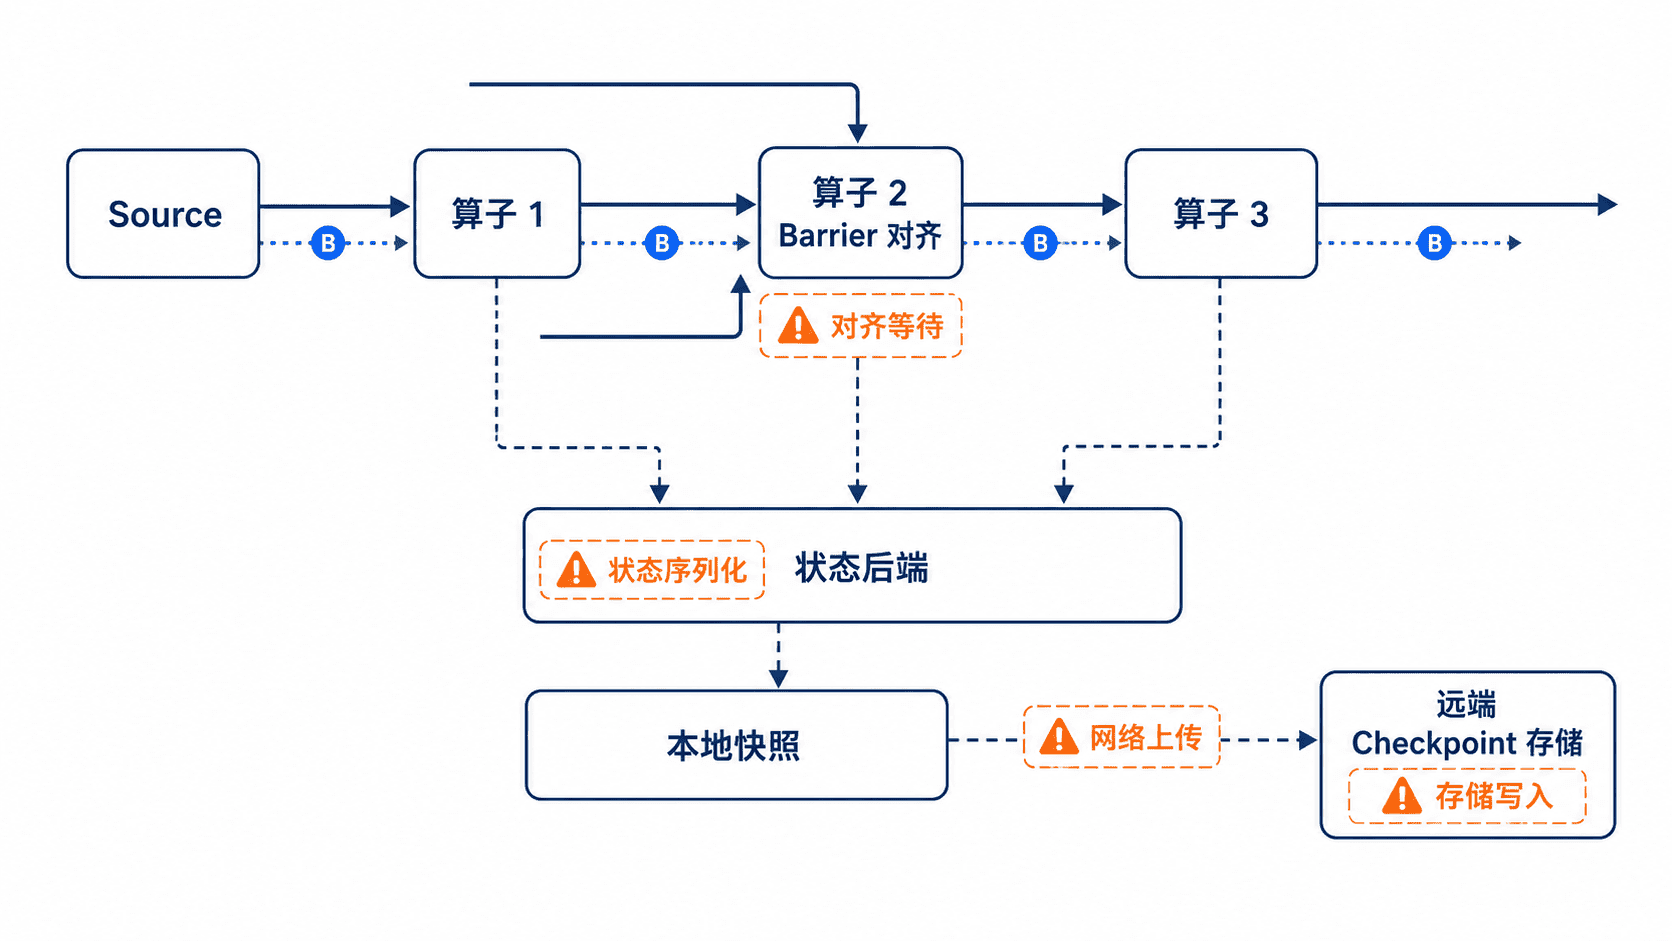
可以先从 JobManager REST API 读取最近一次成功 Checkpoint 的体积与耗时。将 <PORT> 和 <JOB_ID> 替换为实际值;没有成功记录时,latest 中对应字段可能为空。
curl -s "http://localhost:<PORT>/jobs/<JOB_ID>/checkpoints" | jq '{
  total: .counts.total,
  completed: .counts.completed,
  failed: .counts.failed,
  latest_state_bytes: .latest.completed.state_size,
  latest_duration_ms: .latest.completed.end_to_end_duration
}'
预期输出如下,具体数值会随作业负载变化。
{
  "total": 42,
  "completed": 40,
  "failed": 2,
  "latest_state_bytes": 734003200,
  "latest_duration_ms": 12840
}
状态体积稳定但耗时突增时,应继续查看背压、对齐和存储延迟;状态体积持续增长时,则优先检查状态生命周期、窗口清理和 key 基数。
分层选择优化策略
减少不必要的状态
最有效的优化通常不是调大超时,而是减少需要保存的数据。Keyed State 应设置明确的清理条件,例如窗口结束、定时器触发或状态 TTL;聚合场景优先保存累计值,不要把所有原始事件长期放入 ListState。
状态 TTL 适合清理长时间不再访问的业务状态,但它不是精确到秒的定时删除机制。过短会误删仍有价值的数据,过长则无法缓解存储压力。扩缩容前还要检查 key 倾斜,因为最慢的热点实例会拖住整个 Checkpoint。
选择快照与后端
内存型状态后端适合状态较小的任务;嵌入式 RocksDB 或 ForSt 一类磁盘型状态后端更适合大状态。大状态场景通常应评估增量 Checkpoint,使每次主要上传新增或变化的文件,减少重复持久化。
Checkpoint 间隔决定故障时可能重放的数据量,最小暂停时间用于避免连续快照挤占资源。下面是配置片段示例,具体键名和可用值需与实际 Flink 版本核对。
execution.checkpointing.interval: 60 s
execution.checkpointing.min-pause: 20 s
execution.checkpointing.timeout: 10 min
execution.checkpointing.max-concurrent-checkpoints: 1
execution.checkpointing.externalized-checkpoint-retention: RETAIN_ON_CANCELLATION
生效后,正常情况下同一时间只运行一个 Checkpoint,两次之间至少暂停 20 秒。可在 Web UI 或 REST API 中验证实际间隔、持续时间和失败次数。
处理背压与存储压力
当 Barrier 长时间卡在上游,且对齐耗时明显高于状态写入耗时,可以评估 Unaligned Checkpoint。它会把在途数据纳入快照,通常能降低强背压下的等待,但可能增大快照与恢复读取量,因此不应在没有背压证据时默认开启。
远端存储写入慢时,应检查对象存储限流、文件数量、带宽和权限。增量 Checkpoint 会增加共享文件引用关系,不要人工删除仍被 Checkpoint 或 Savepoint 引用的目录。若失败只来自偶发网络抖动,可适度增加超时;若每次耗时都接近间隔,应先降低状态量或提升存储吞吐。
验证优化结果
至少连续观察 10 次成功 Checkpoint,并比较优化前后的中位数,而不是只看单次最好结果。验收应同时满足:状态增长符合业务预期、端到端耗时稳定、失败率下降、远端存储增长速度可控。
还要执行一次受控重启或故障恢复,确认作业能从最近 Checkpoint 恢复,且状态、输出语义和处理进度均正确。只有指标与恢复测试都通过,优化才算完成。