
大数据与流处理 / 系统课时
有状态计算模型
有状态计算模型
本课用一个按用户累计数值的最小程序,说明 Flink 状态究竟保存在哪里、为什么必须先 KeyBy,以及同一个算子实例如何同时维护多份彼此隔离的业务数据。完成后,你能判断一段计算应使用普通变量还是托管状态。
学习目标
- 说清无状态计算与有状态计算的差异
- 理解
KeyBy、并行子任务与 keyed state 的对应关系 - 运行一个按业务键独立累计的有状态程序
状态解决什么问题
无状态算子只根据当前输入产生当前输出,例如把字符串转成大写。它不需要记住历史事件,因此相同输入通常得到相同结果。
有状态算子会把历史信息带入下一次计算。累计金额、去重、会话判断、窗口聚合和规则匹配都依赖“之前发生过什么”。普通成员变量虽然也能暂存数据,但它不受 Flink 状态机制管理,发生失败、重启或扩缩容时无法可靠恢复和重新分配。
Flink 的托管状态由运行时负责序列化、保存和恢复。启用检查点后,状态会随数据流处理进度形成一致性快照,任务恢复时继续从快照中的值计算,而不是从零开始。
KeyBy 如何划分状态
KeyBy 不是把同一个键的数据一次性收集成列表,而是按键计算分区,把相同键的事件稳定路由到同一个下游并行子任务。下游算子访问 keyed state 时,运行时会自动切换到“当前事件所属键”的那一份状态。
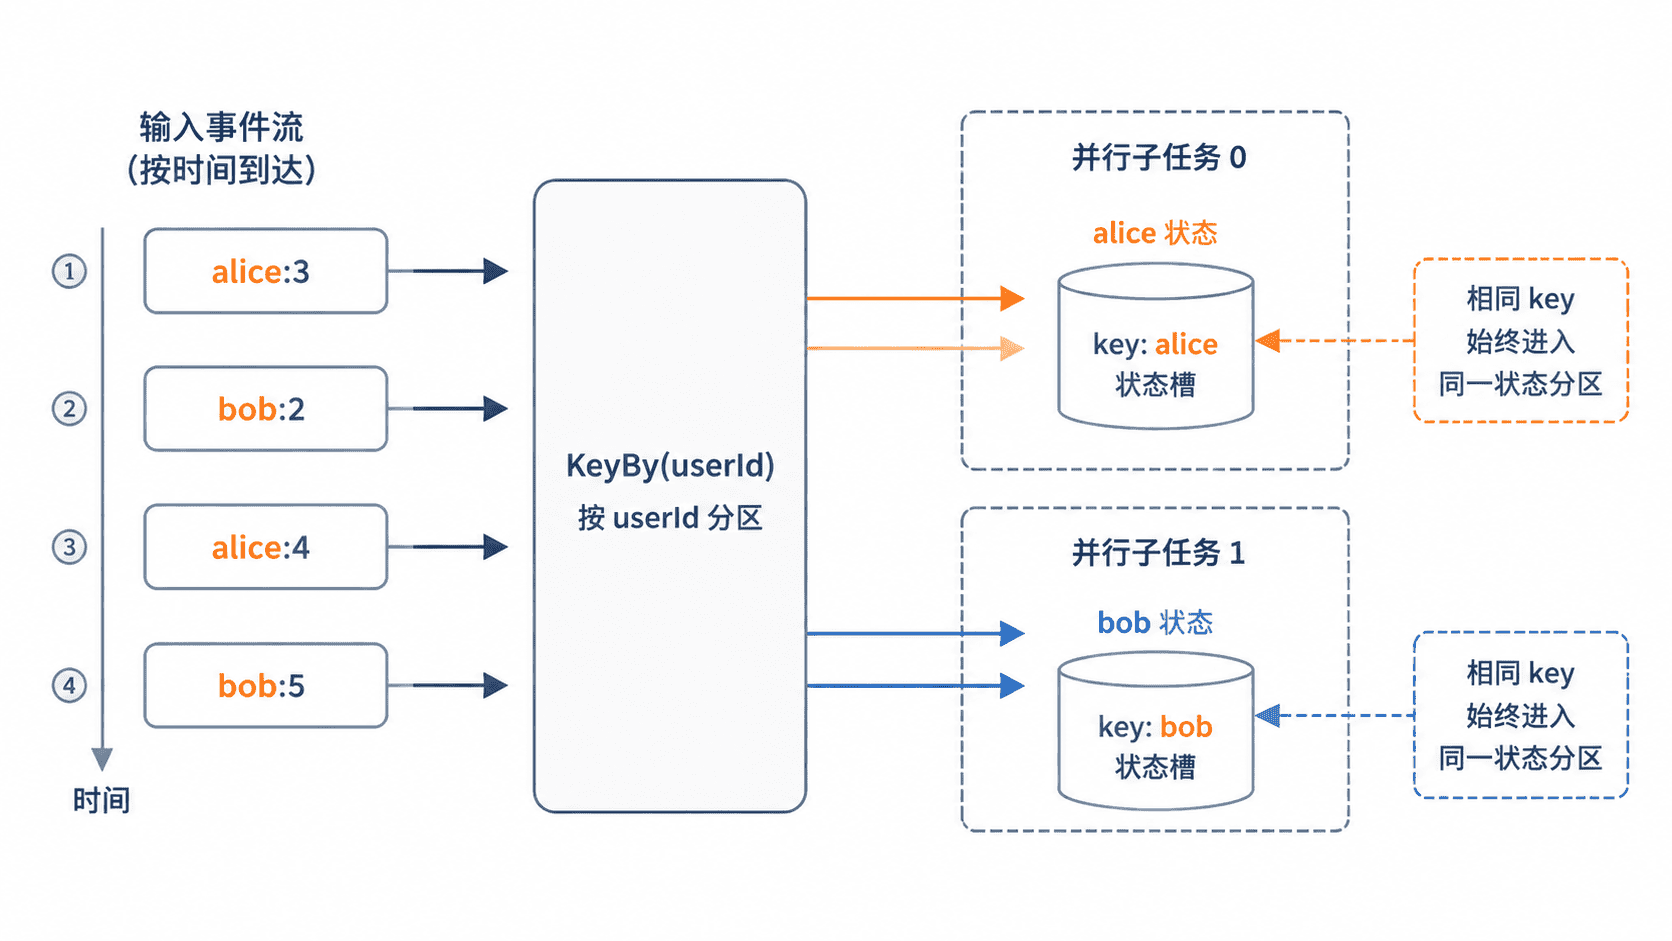
一份 keyed state 的逻辑作用域可以理解为“算子 + 当前 key”。即使多个 key 落在同一个物理子任务中,它们读写的状态仍然彼此隔离。并行度调整后,Flink 还能基于检查点或 Savepoint 重新分配这些键及其状态。
运行按键累计示例
下面的程序先按用户名分区,再用 ValueState<Integer> 保存每个用户的累计值。为了让本地输出顺序稳定,示例把并行度设为 1;这不会改变不同 key 拥有独立状态的语义。
import org.apache.flink.api.common.functions.RichMapFunction;
import org.apache.flink.api.common.state.ValueState;
import org.apache.flink.api.common.state.ValueStateDescriptor;
import org.apache.flink.api.java.tuple.Tuple2;
import org.apache.flink.configuration.Configuration;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;

public class KeyedStateModelDemo {

    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env =
                StreamExecutionEnvironment.getExecutionEnvironment();
        env.setParallelism(1);

        env.fromElements(
                        Tuple2.of("alice", 3),
                        Tuple2.of("bob", 2),
                        Tuple2.of("alice", 4),
                        Tuple2.of("bob", 5))
                .keyBy(value -> value.f0)
                .map(new RichMapFunction<Tuple2<String, Integer>, String>() {
                    private transient ValueState<Integer> sumState;

                    @Override
                    public void open(Configuration parameters) {
                        ValueStateDescriptor<Integer> descriptor =
                                new ValueStateDescriptor<>("sum", Integer.class);
                        sumState = getRuntimeContext().getState(descriptor);
                    }

                    @Override
                    public String map(Tuple2<String, Integer> value) throws Exception {
                        Integer current = sumState.value();
                        int next = (current == null ? 0 : current) + value.f1;
                        sumState.update(next);
                        return value.f0 + " -> " + next;
                    }
                })
                .print();

        env.execute("keyed-state-model-demo");
    }
}
预期输出:
alice -> 3
bob -> 2
alice -> 7
bob -> 7
第二次处理 alice 时读到的是 3,而不是 bob 的 2;第二次处理 bob 时也只读取自己的历史值。这正是 keyed state 按业务键隔离的效果。
选择状态模型
需要按用户、设备、订单等业务键保存历史时,先 KeyBy,再使用 ValueState、ListState、MapState 等 keyed state。需要保存算子分片自身的数据,而不是某个业务键的数据时,才考虑 operator state。
状态会增加存储、序列化和检查点成本,因此只保存后续计算必需的信息。对于可能长期不再出现的 key,还应设计清理条件或状态 TTL,避免状态无限增长。