
大数据与流处理 / 系统课时
排查结果不一致
排查结果不一致
本课建立一套可执行的对账与定位顺序,用于处理 Flink 作业出现重复、缺失或字段不一致的问题。完成后,你能从数据源、状态恢复、检查点和目标端逐层缩小范围,并用最小回放验证修复是否真正有效。
学习目标
- 区分源端重复、处理中重复和目标端重复
- 按检查点与状态恢复链路定位缺失数据
- 使用对账脚本验证修复前后的差异
先定义什么叫“一致”
排查前先写清业务语义,否则“数量相等”也可能是假一致。至少确认唯一业务键、允许的更新顺序、删除事件如何表达,以及目标端采用追加、覆盖还是撤回结果。
端到端一致性不是单个开关。它要求数据源能够从确定位置恢复,算子状态随检查点一致恢复,计算逻辑不产生不可重放的副作用,目标端还要支持事务提交或基于业务键幂等写入。任何一环不满足,都可能在失败恢复后产生重复或缺失。
| 现象 | 优先怀疑 | 关键证据 |
|---|---|---|
| 同一业务键出现多条相同记录 | Source 重放、Sink 重试非幂等 | 源偏移、目标端唯一键、重试日志 |
| 某一时间段整段缺失 | 起始位点错误、过滤条件、检查点恢复点异常 | 消费位点、作业参数、恢复记录 |
| 数量相等但字段不同 | 状态旧值、乱序覆盖、非确定性逻辑 | 事件版本、状态快照、更新顺序 |
| 重启后才出现差异 | 检查点未完成、外部副作用未纳入事务 | Checkpoint 历史、失败时间、提交记录 |
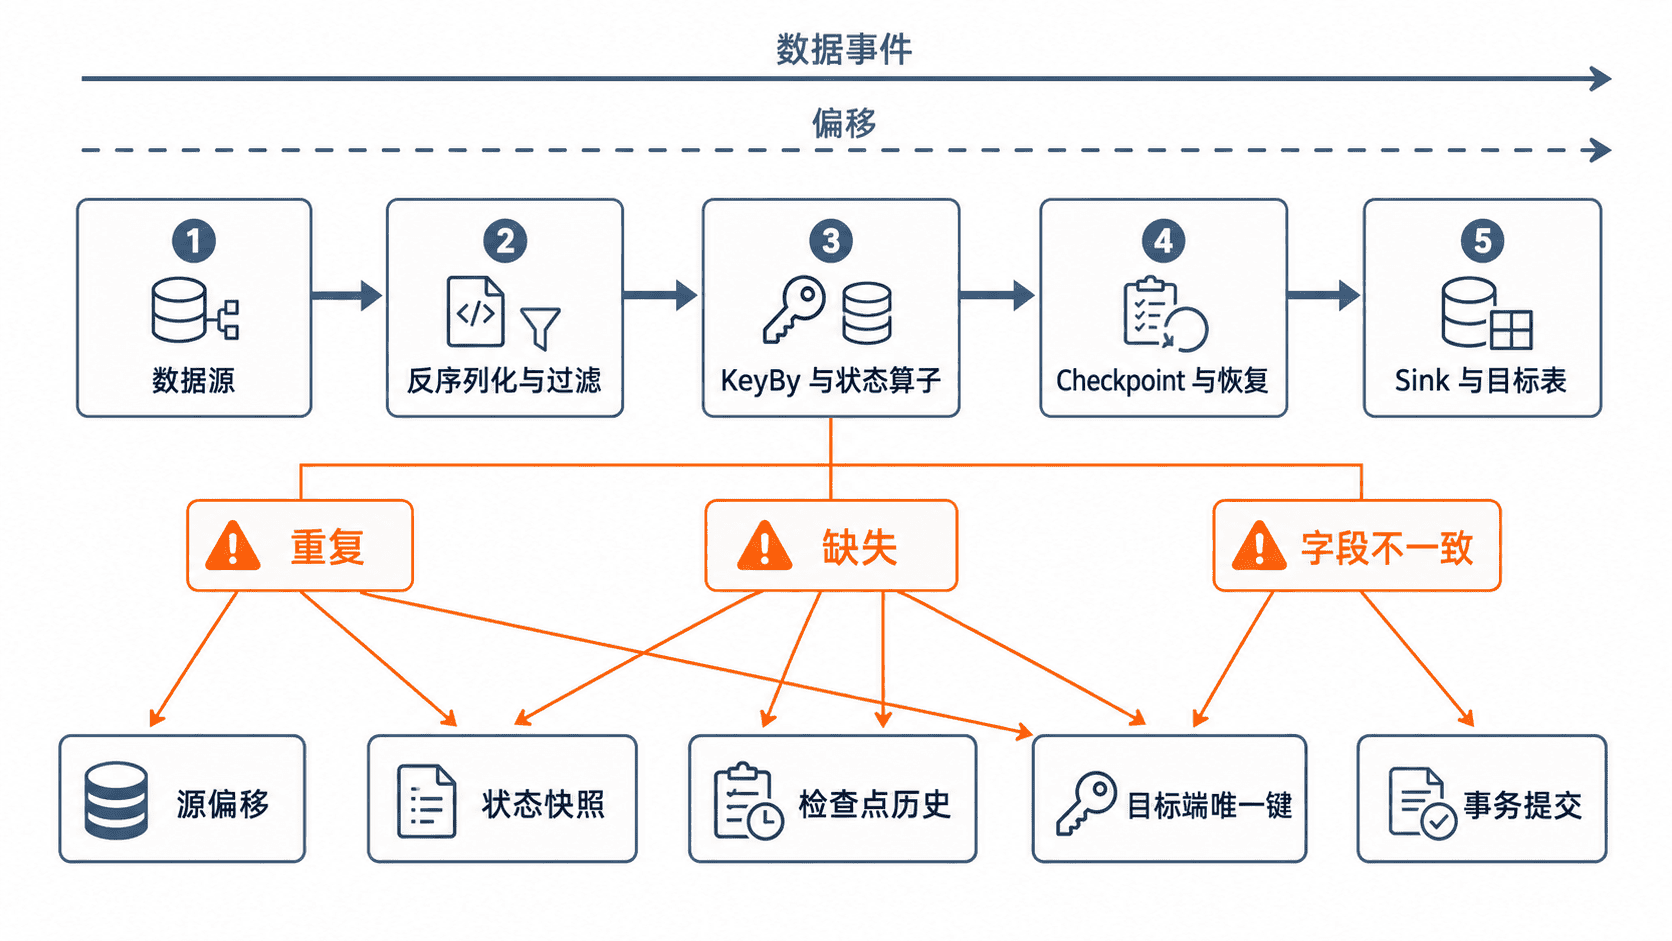
按数据链路定位
先固定一个足够小的业务窗口,例如十分钟或一批订单,并记录作业版本、并行度、恢复方式和失败时间。不要直接在全量数据上反复重跑,否则新的重放会继续扩大差异。
第一步检查数据源。确认同一业务键在源端是否已经重复,Kafka 消费组、分区与起始位点是否符合预期;CDC 场景还要区分快照记录与增量日志,检查主键变更、删除事件和表结构变更是否被正确处理。若源端已经缺失,后续算子无法补回。
第二步检查状态与逻辑。重点核对 keyBy 使用的键、状态 TTL、窗口允许延迟、定时器清理和去重状态。并行度或 maxParallelism 变化后,要确认状态是否按兼容方式恢复。随机数、当前系统时间、外部查询等非确定性输入,也可能让同一条重放数据得到不同结果。
第三步检查检查点。关注失败前最后一个成功检查点、恢复时实际使用的检查点、失败次数和完成耗时。只有成功完成的检查点才形成一致恢复点;作业从更早位置恢复时,源端会重放一段数据,这本身正常,但目标端必须能抵消重复。
第四步检查目标端。追加写入最容易放大重试重复;Upsert 需要稳定主键;两阶段提交需要事务超时大于最坏检查点与恢复时间。还要检查目标端是否存在异步写入超时后“实际成功但客户端认为失败”的情况,这会触发再次提交。
用对账脚本缩小差异
下面脚本比较两份 CSV。文件必须包含 id、amount、status 三列,其中 id 是业务唯一键。脚本同时报告重复键、源有目标无、目标有源无以及字段不一致,适合先验证一个小窗口。
import argparse
import csv
import json
from collections import Counter
from pathlib import Path

def load_rows(path: Path) -> list[dict[str, str]]:
    with path.open("r", encoding="utf-8", newline="") as file:
        rows = list(csv.DictReader(file))
    required = {"id", "amount", "status"}
    if not rows or not required.issubset(rows[0]):
        raise ValueError(f"{path} 必须包含列: {sorted(required)}")
    return rows

def index_last(rows: list[dict[str, str]]) -> dict[str, dict[str, str]]:
    # 对重复键保留最后一条,重复本身由 Counter 单独报告
    return {row["id"]: row for row in rows}

def main() -> None:
    parser = argparse.ArgumentParser()
    parser.add_argument("source_csv", type=Path)
    parser.add_argument("sink_csv", type=Path)
    args = parser.parse_args()

    source_rows = load_rows(args.source_csv)
    sink_rows = load_rows(args.sink_csv)
    source_count = Counter(row["id"] for row in source_rows)
    sink_count = Counter(row["id"] for row in sink_rows)
    source = index_last(source_rows)
    sink = index_last(sink_rows)

    common_ids = source.keys() & sink.keys()
    result = {
        "source_duplicates": sorted(k for k, v in source_count.items() if v > 1),
        "sink_duplicates": sorted(k for k, v in sink_count.items() if v > 1),
        "missing_in_sink": sorted(source.keys() - sink.keys()),
        "unexpected_in_sink": sorted(sink.keys() - source.keys()),
        "payload_mismatch": sorted(
            key for key in common_ids
            if (source[key]["amount"], source[key]["status"])
            != (sink[key]["amount"], sink[key]["status"])
        ),
    }
    print(json.dumps(result, ensure_ascii=False, indent=2))

if __name__ == "__main__":
    main()
创建最小样本并运行:
cat > source.csv <<'CSV'
id,amount,status
1,100,PAID
2,250,PAID
3,180,REFUNDED
5,90,PAID
CSV

cat > sink.csv <<'CSV'
id,amount,status
1,100,PAID
2,250,PAID
2,250,PAID
3,200,REFUNDED
4,70,PAID
CSV

python reconcile.py source.csv sink.csv
预期输出:
{
  "source_duplicates": [],
  "sink_duplicates": [
    "2"
  ],
  "missing_in_sink": [
    "5"
  ],
  "unexpected_in_sink": [
    "4"
  ],
  "payload_mismatch": [
    "3"
  ]
}
生产环境应从相同时间窗口、相同业务过滤条件导出两端数据。若数据量很大,可先按日期或主键哈希分桶,再逐桶计算数量、最小最大位点和校验摘要,最后只展开异常桶。
修复与回放验证
修复时只改一个变量。例如先给目标表增加业务唯一键并改为 Upsert,再从失败前的已知检查点恢复。若同时修改并行度、状态 TTL、SQL 和 Sink 语义,即使结果恢复正常,也无法确认真正根因。
验证至少覆盖三种路径:正常持续运行、制造一次算子失败后恢复、从保存点或检查点重新启动。每次都对同一业务窗口执行对账,并确认源端最终位点、成功检查点和目标端提交记录相互对应。
不要通过直接删除目标端重复行来宣告修复完成。清洗历史数据只能修结果,必须同时修正重试、幂等或事务语义,才能阻止问题再次发生。