
大数据与流处理 / 系统课时
分区与并行度
分区与并行度
本课解决 DataStream 在不同并行算子之间如何分发数据的问题。学完后,你能根据负载均衡、局部传输、全量复制和业务规则选择合适的分区策略,并用并行度与下游子任务编号验证数据是否按预期流动。
学习目标
- 说明并行度、分区和网络交换之间的关系
- 区分 Shuffle、Rebalance、Rescale 与 Broadcast
- 编写并验证一个自定义分区器
先理解并行度与分区
并行度表示一个算子同时运行的子任务数量。上游并行度为 2、下游并行度为 4 时,每条记录必须选择一个或多个下游子任务,这个选择过程就是分区。分区策略会直接影响负载均衡、网络传输量和结果正确性。
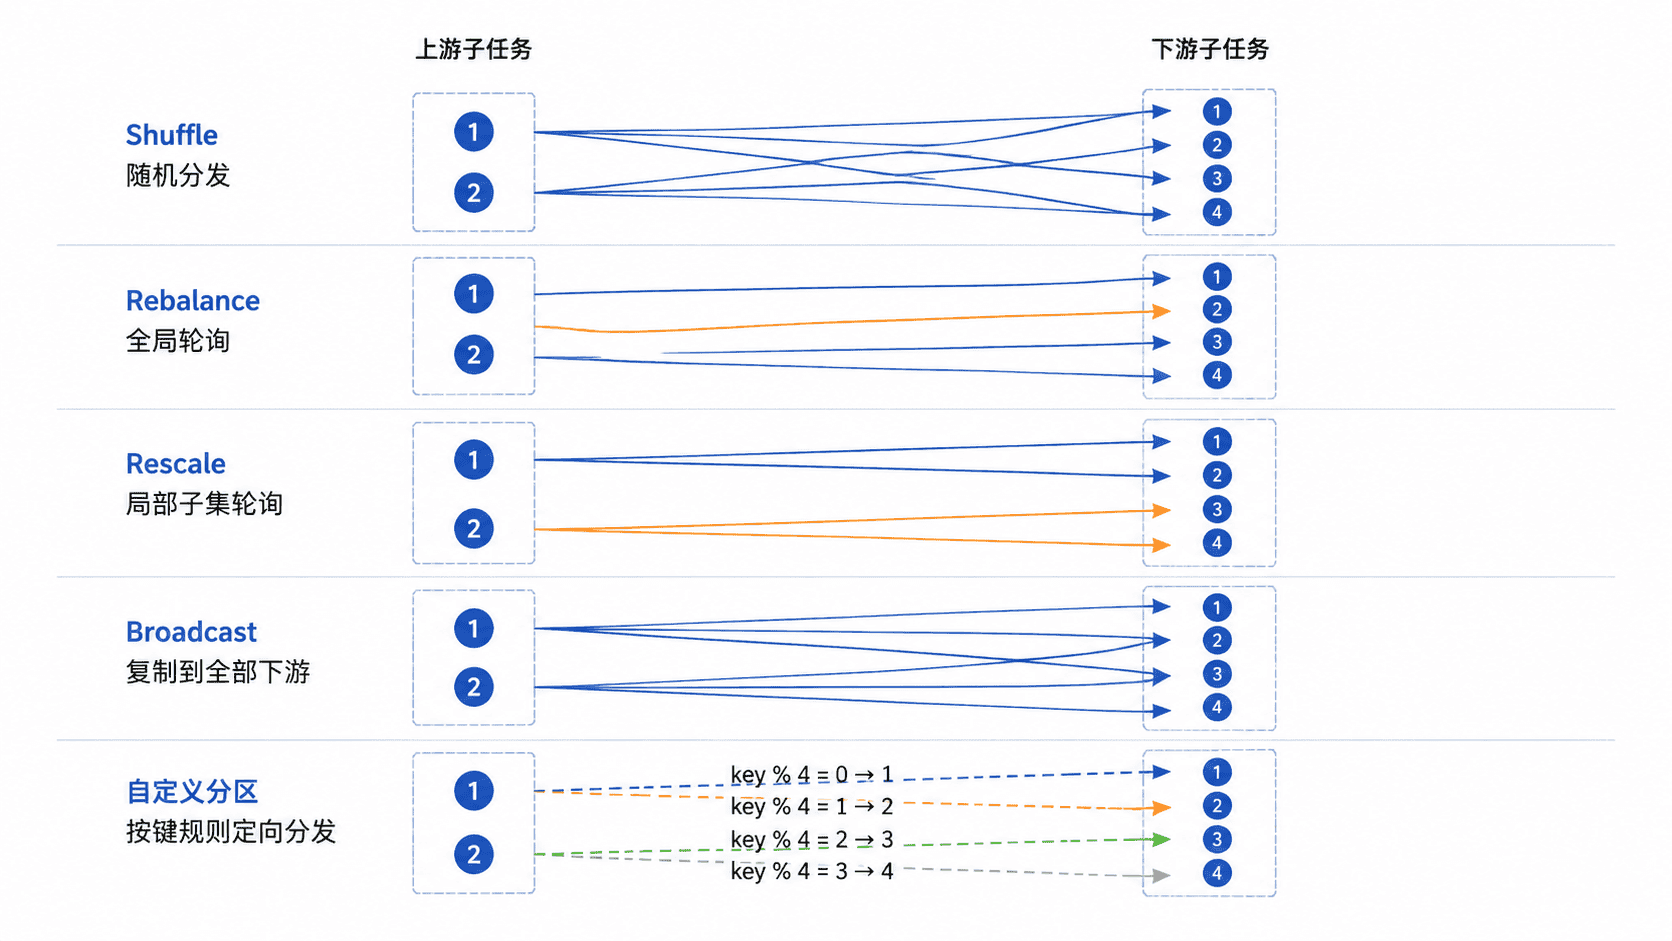
这里的 shuffle() 是 Flink API 中的随机分发策略,不要把它与广义的“网络 Shuffle 阶段”混为一谈。只要上下游并行度不同或显式改变分区,通常就会产生数据交换。
五种策略怎么选
| 策略 | 分发规则 | 典型用途 | 主要代价 |
|---|---|---|---|
shuffle() |
每条记录随机选择下游 | 快速打散数据 | 负载只能近似均衡,结果不可预测 |
rebalance() |
面向全部下游子任务轮询 | 消除上游数据倾斜 | 可能产生跨节点网络传输 |
rescale() |
只在分配到的下游子集内轮询 | 同一 TaskManager 内局部均衡 | 均衡范围小于 Rebalance |
broadcast() |
每条记录复制给全部下游 | 下发规则、配置或小型维表 | 数据量按下游并行度放大 |
partitionCustom() |
由业务函数返回目标分区号 | 租户隔离、固定路由、特殊分片 | 规则错误会造成倾斜或越界 |
rebalance() 更关注全局均衡;rescale() 更关注局部传输效率。是否真正减少网络开销还取决于任务调度位置,因此不能只根据算子名称判断物理部署结果。
编写自定义分区器
下面把偶数发送到子任务 0、奇数发送到子任务 1。上游并行度固定为 1,下游映射算子并行度固定为 2,便于观察分区结果。
java
import org.apache.flink.api.common.functions.Partitioner;
import org.apache.flink.api.common.functions.RichMapFunction;
import org.apache.flink.api.common.functions.OpenContext;
import org.apache.flink.streaming.api.datastream.DataStream;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;

public class CustomPartitionDemo {

    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env =
                StreamExecutionEnvironment.getExecutionEnvironment();

        DataStream<Long> numbers = env
                .fromSequence(1, 8)
                .setParallelism(1);

        Partitioner<Long> oddEvenPartitioner =
                (key, numPartitions) -> Math.floorMod(key, numPartitions);

        numbers
                .partitionCustom(oddEvenPartitioner, value -> value)
                .map(new RichMapFunction<Long, String>() {
                    private int subtaskIndex;

                    @Override
                    public void open(OpenContext openContext) {
                        subtaskIndex = getRuntimeContext()
                                .getIndexOfThisSubtask();
                    }

                    @Override
                    public String map(Long value) {
                        return "subtask=" + subtaskIndex
                                + ", value=" + value;
                    }
                })
                .setParallelism(2)
                .print()
                .setParallelism(1);

        env.execute("custom-partition-demo");
    }
}
预期输出如下,行顺序可能因并行执行而不同,但偶数应进入子任务 0,奇数应进入子任务 1。
text
subtask=1, value=1
subtask=0, value=2
subtask=1, value=3
subtask=0, value=4
subtask=1, value=5
subtask=0, value=6
subtask=1, value=7
subtask=0, value=8
自定义分区器返回值必须位于 0 到 numPartitions - 1。同时要避免把大量热点键映射到同一个分区,否则即使总体并行度很高,也会形成单个子任务的处理瓶颈。
验证与常见误区
验证分区策略时,不要只看最终业务结果,还要记录下游子任务编号、各分区记录数和反压情况。测试数据应覆盖热点键、空值、极端键值以及并行度变化后的行为。
broadcast()会复制数据,但不会自动形成可查询的广播状态。需要让规则流与业务流协同时,应继续使用 Broadcast State 模式,而不是只调用普通的broadcast()分区。
按自己的节奏,确认真正理解。