
大数据与流处理 / 系统课时
集合状态
集合状态
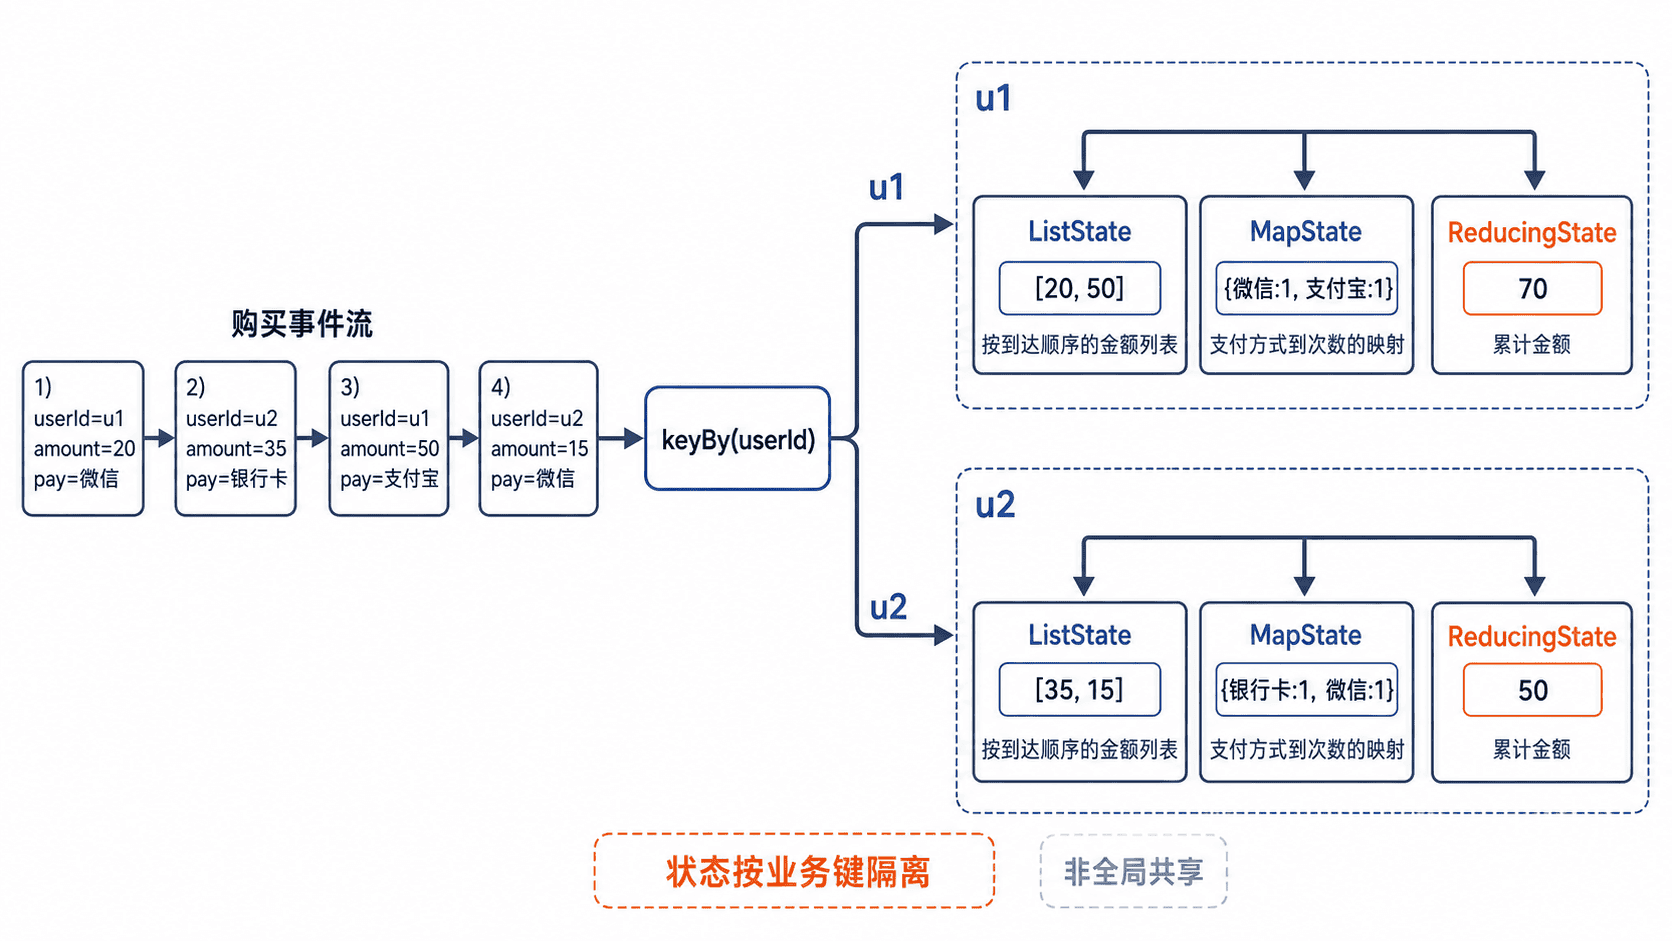
当一个业务键既要保存明细、又要维护分类计数和累计值时,单个 ValueState 会迅速变得笨重。本课用一条可运行的购买事件流,演示如何组合 ListState、MapState 与 ReducingState,并明确它们的状态边界、更新方式和清理责任。
学习目标
- 根据数据访问方式选择 ListState、MapState 或 ReducingState
- 在 KeyedProcessFunction 中初始化并更新多个独立状态
- 识别集合状态无限增长、状态命名冲突和跨键误读问题
三类状态分别解决什么问题
ListState<T> 保存当前业务键下的一组同类型元素,适合保留最近事件、待处理明细或分批缓存。它支持 add、addAll、get、update 和 clear,读取结果是可迭代对象。
MapState<UK, UV> 在当前业务键内部再维护一层映射,适合按商品、渠道或规则编号做随机查询与更新。例如流先按用户编号 keyBy,MapState 再保存“支付方式 → 使用次数”。
ReducingState<T> 保存同类型元素的增量归约结果。每次调用 add 时,Flink 使用描述器中的 ReduceFunction 合并新旧值,因此无需保留全部明细,适合累计金额、最大值或最小值。
完整示例:维护用户购买状态
下面的程序按用户编号分区。每到一条购买事件,就把金额追加到 ListState,更新 MapState 中的支付方式次数,并把金额加入 ReducingState。示例将并行度设为 1,便于观察稳定顺序。
import org.apache.flink.api.common.functions.OpenContext;
import org.apache.flink.api.common.functions.ReduceFunction;
import org.apache.flink.api.common.state.ListState;
import org.apache.flink.api.common.state.ListStateDescriptor;
import org.apache.flink.api.common.state.MapState;
import org.apache.flink.api.common.state.MapStateDescriptor;
import org.apache.flink.api.common.state.ReducingState;
import org.apache.flink.api.common.state.ReducingStateDescriptor;
import org.apache.flink.api.java.tuple.Tuple3;
import org.apache.flink.streaming.api.datastream.DataStream;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.streaming.api.functions.KeyedProcessFunction;
import org.apache.flink.util.Collector;

import java.util.ArrayList;
import java.util.List;
import java.util.Map;
import java.util.TreeMap;

public class CollectionStateDemo {

    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env =
                StreamExecutionEnvironment.getExecutionEnvironment();
        env.setParallelism(1);

        DataStream<Tuple3<String, String, Long>> purchases = env.fromData(
                Tuple3.of("u1", "card", 10L),
                Tuple3.of("u1", "qr", 20L),
                Tuple3.of("u2", "card", 7L),
                Tuple3.of("u1", "card", 30L));

        purchases
                .keyBy(event -> event.f0)
                .process(new PurchaseStateFunction())
                .print();

        env.execute("collection-state-demo");
    }

    static class PurchaseStateFunction extends
            KeyedProcessFunction<String, Tuple3<String, String, Long>, String> {

        private transient ListState<Long> amounts;
        private transient MapState<String, Integer> methodCounts;
        private transient ReducingState<Long> totalAmount;

        @Override
        public void open(OpenContext openContext) throws Exception {
            amounts = getRuntimeContext().getListState(
                    new ListStateDescriptor<>("amounts", Long.class));

            methodCounts = getRuntimeContext().getMapState(
                    new MapStateDescriptor<>(
                            "method-counts", String.class, Integer.class));

            ReducingStateDescriptor<Long> totalDescriptor =
                    new ReducingStateDescriptor<>(
                            "total-amount",
                            new ReduceFunction<Long>() {
                                @Override
                                public Long reduce(Long left, Long right) {
                                    return left + right;
                                }
                            },
                            Long.class);
            totalAmount = getRuntimeContext()
                    .getReducingState(totalDescriptor);
        }

        @Override
        public void processElement(
                Tuple3<String, String, Long> event,
                Context context,
                Collector<String> out) throws Exception {

            amounts.add(event.f2);

            Integer oldCount = methodCounts.get(event.f1);
            methodCounts.put(event.f1, oldCount == null ? 1 : oldCount + 1);

            totalAmount.add(event.f2);

            List<Long> amountSnapshot = new ArrayList<>();
            for (Long amount : amounts.get()) {
                amountSnapshot.add(amount);
            }

            Map<String, Integer> countSnapshot = new TreeMap<>();
            for (Map.Entry<String, Integer> entry : methodCounts.entries()) {
                countSnapshot.put(entry.getKey(), entry.getValue());
            }

            out.collect(
                    event.f0
                            + " amounts=" + amountSnapshot
                            + " methods=" + countSnapshot
                            + " total=" + totalAmount.get());
        }
    }
}
预期输出如下,Flink 启动日志和实际线程信息可能不同。
u1 amounts=[10] methods={card=1} total=10
u1 amounts=[10, 20] methods={card=1, qr=1} total=30
u2 amounts=[7] methods={card=1} total=7
u1 amounts=[10, 20, 30] methods={card=2, qr=1} total=60
状态边界与访问规则
这三个状态句柄都定义在同一个函数实例中,但读取值取决于当前输入元素的业务键。处理 u1 时只能看到 u1 的状态,切换到 u2 后,Flink 自动把句柄指向 u2 对应的状态空间。
状态描述器名称用于识别状态,必须在同一算子内保持稳定且避免重名。上线后随意修改名称,会让恢复任务无法继续读取原来的状态。状态对象只是访问句柄,实际数据可能位于堆内存、RocksDB 或远端持久化快照中。
选择与控制增长
需要完整遍历或保留顺序时选择 ListState;需要按子键查询、覆盖或删除单项时选择 MapState;只关心可增量合并的结果时选择 ReducingState。若输入类型和输出聚合类型不同,应改用 AggregatingState。
集合状态不会因为“长期未使用”自动缩小。生产代码应根据业务设置数量上限、注册定时器后主动删除、调用 clear,或启用 State TTL。不要把无限事件明细永久追加到 ListState,也不要把无界维度直接写入 MapState。