
大数据与流处理 / 系统课时
文件系统连接器
文件系统连接器
文件系统连接器不仅能读取本地 CSV,还能统一访问 HDFS、对象存储等路径,并把流式结果安全写成分桶文件。本课完成一个可运行的 FileSource 到 FileSink 作业,再说明 CSV、JSON、Parquet 的格式选择、滚动策略和文件可见性。
学习目标
- 使用 FileSource 在有界模式下读取目录中的文本文件
- 使用 FileSink 配置分桶、滚动策略和检查点提交
- 区分 CSV、JSON 与 Parquet 对应的行式和批式格式接口
先选读取模式,再选文件格式
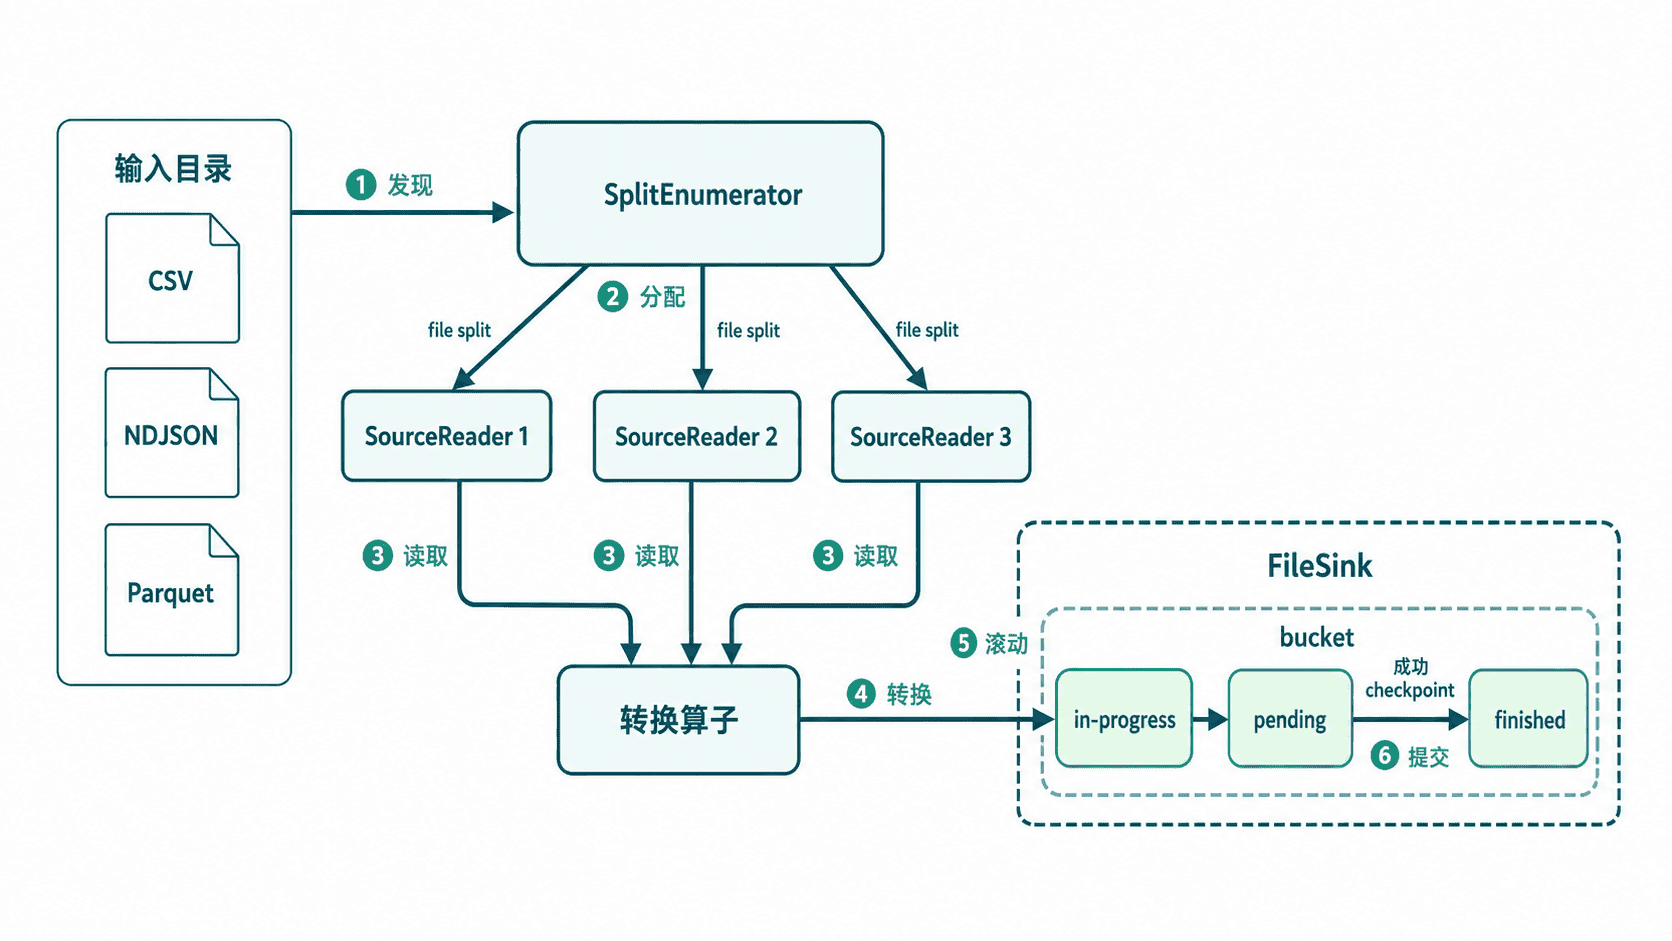
FileSource 默认是有界源:启动时枚举指定路径下的文件,全部读完后结束。调用 monitorContinuously(Duration) 才会周期发现新文件,并过滤已经发现过的路径。内部由 SplitEnumerator 负责发现和分配文件,SourceReader 负责实际读取。:contentReference[oaicite:4]{index=4}
格式接口决定“怎样把文件字节变成记录”。forRecordStreamFormat 适合逐条读取的 StreamFormat,例如文本行、CSV 或逐行 JSON;forBulkFileFormat 适合批量解码的 BulkFormat,例如 Parquet、ORC。前者实现简单,后者更容易利用列式读取和批处理优化。:contentReference[oaicite:5]{index=5}
| 数据格式 | 常见组织方式 | 推荐接口 | 关键注意点 |
|---|---|---|---|
| CSV | 一行一条记录 | StreamFormat 或 CsvReaderFormat | 明确列顺序、分隔符和转义规则 |
| JSON | 一行一个 JSON 对象 | StreamFormat 或 Table JSON Format | 文件系统 JSON 通常是 NDJSON,不是一个大数组 |
| Parquet | 列式文件、内部按行组组织 | BulkFormat | 需要匹配 schema,并引入兼容的 Parquet 依赖 |
主示例:读取 CSV 并写回清洗结果
下面程序读取输入目录中的 CSV 文本,跳过表头和空行,校验三列后写入输出目录。示例使用基础路径分桶,避免默认按小时创建子目录;流模式开启检查点,使 FileSink 能完成文件提交。
package demo;

import org.apache.flink.api.common.RuntimeExecutionMode;
import org.apache.flink.api.common.eventtime.WatermarkStrategy;
import org.apache.flink.api.common.serialization.SimpleStringEncoder;
import org.apache.flink.configuration.MemorySize;
import org.apache.flink.connector.file.sink.FileSink;
import org.apache.flink.connector.file.src.FileSource;
import org.apache.flink.connector.file.src.reader.TextLineInputFormat;
import org.apache.flink.core.fs.Path;
import org.apache.flink.streaming.api.datastream.DataStream;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.streaming.api.functions.sink.filesystem.bucketassigners.BasePathBucketAssigner;
import org.apache.flink.streaming.api.functions.sink.filesystem.rollingpolicies.DefaultRollingPolicy;

import java.time.Duration;

public class FileConnectorDemo {
    public static void main(String[] args) throws Exception {
        if (args.length != 2) {
            throw new IllegalArgumentException(
                    "参数: <input-uri> <output-uri>");
        }

        StreamExecutionEnvironment env =
                StreamExecutionEnvironment.getExecutionEnvironment();
        env.setRuntimeMode(RuntimeExecutionMode.STREAMING);
        env.enableCheckpointing(10_000);

        FileSource<String> source = FileSource
                .forRecordStreamFormat(
                        new TextLineInputFormat(),
                        new Path(args[0]))
                .build();

        DataStream<String> cleaned = env
                .fromSource(
                        source,
                        WatermarkStrategy.noWatermarks(),
                        "csv-file-source")
                .filter(line -> !line.isBlank() && !line.startsWith("id,"))
                .map(line -> normalize(line));

        FileSink<String> sink = FileSink
                .forRowFormat(
                        new Path(args[1]),
                        new SimpleStringEncoder<String>("UTF-8"))
                .withBucketAssigner(new BasePathBucketAssigner<>())
                .withRollingPolicy(
                        DefaultRollingPolicy.builder()
                                .withMaxPartSize(
                                        MemorySize.ofMebiBytes(128))
                                .withRolloverInterval(
                                        Duration.ofMinutes(15))
                                .withInactivityInterval(
                                        Duration.ofMinutes(5))
                                .build())
                .build();

        cleaned.sinkTo(sink);
        env.execute("file-source-sink-demo");
    }

    private static String normalize(String line) {
        String[] fields = line.split(",", -1);
        if (fields.length != 3) {
            throw new IllegalArgumentException("非法 CSV: " + line);
        }
        return fields[0].trim() + ","
                + fields[1].trim() + ","
                + fields[2].trim();
    }
}准备输入并提交作业。<PATH>、<ID> 等占位符需要替换为实际路径或运行时生成值。
mkdir -p /tmp/flink-file/input /tmp/flink-file/output
cat > /tmp/flink-file/input/orders.csv <<'EOF'
id,customer,amount
1,Alice,12.50
2, Bob , 8.00
EOF

flink run -c demo.FileConnectorDemo \
  <PATH>/file-connector-demo.jar \
  file:///tmp/flink-file/input \
  file:///tmp/flink-file/output

find /tmp/flink-file/output -type f -name 'part-*' -exec cat {} \;
预期输出
1,Alice,12.50
2,Bob,8.00
实际 part 文件名和输出顺序可能不同。生产环境不要让多个作业写入同一个输出目录,否则文件命名、恢复状态和下游消费边界会变得难以管理。
FileSink 为什么依赖检查点
FileSink 先写 in-progress part 文件,满足滚动条件后进入 pending,成功检查点再把文件提交为可安全读取的 finished 状态。流模式未启用检查点时,part 文件可能长期停留在未完成状态;Flink 官方文档明确要求流式 FileSink 开启检查点。:contentReference[oaicite:6]{index=6}
滚动策略控制单文件大小和打开时长,检查点间隔控制 pending 文件多久变为 finished。间隔太短会产生大量小文件和元数据压力;间隔太长则增加下游看到结果的延迟。Sink 并行度、分桶数量和滚动频率会共同决定最终文件数量。
对于 Parquet 等 Bulk Format,通常使用 FileSink.forBulkFormat,并由与 schema 匹配的 BulkWriter.Factory 编码。Bulk Format 只能使用基于检查点的滚动策略;这与列式文件必须完整封闭后才能可靠读取有关。:contentReference[oaicite:7]{index=7}
连续发现与常见失败
需要持续接收新文件时,可在前面示例的 FileSource 构建器上增加 monitorContinuously(Duration.ofSeconds(30))。这是片段示例,依赖主示例中的输入路径和 TextLineInputFormat;生产者应创建新文件后再原子移动到监听目录,不要持续追加已被发现的同一路径。
输出目录只有 .inprogress 或 .pending 文件时,先检查检查点是否启用并成功。小文件过多时,降低 Sink 并行度、减少分桶数量,或增大滚动阈值与检查点间隔。JSON 读取失败时,确认输入是“一行一个对象”的 NDJSON;Parquet 报 schema 错误时,核对字段类型、可空性和依赖版本。
本地 file:/// 适合开发验证。切换到 HDFS、S3 或其他对象存储时,还需安装与 Flink 版本兼容的文件系统插件,并验证凭证、端点、路径权限和对象存储提交能力,不能只替换 URI 就假定语义完全一致。