
大数据与流处理 / 系统课时
连接器体系
连接器体系
本课建立 Flink 连接器的整体心智模型,并给出从依赖加载到一致性验证的最小操作路径。完成后,你能够判断一个外部系统接入需要哪些 JAR、格式和运行配置,也能区分“连接成功”与“端到端数据一致”之间的差别。
学习目标
- 说明连接器、数据格式和运行时之间的职责边界
- 正确加载连接器依赖并验证工厂是否可发现
- 根据 Source、Sink 与外部系统能力判断一致性上限
连接器位于哪里
连接器负责把外部系统的数据模型转换为 Flink 可处理的记录,并把计算结果写回目标系统。SQL 作业通常还需要独立的格式组件,例如 JSON、CSV 或 Avro;连接器解决“从哪里读、写到哪里”,格式解决“字节如何解析和编码”。
在运行时,Source 需要保存消费位置或分片进度,Sink 需要在故障恢复时避免丢失或重复提交。Checkpoint 将算子状态、Source 进度和支持事务的 Sink 提交点协调起来,但最终一致性仍受外部系统事务、幂等写入和连接器实现能力限制。
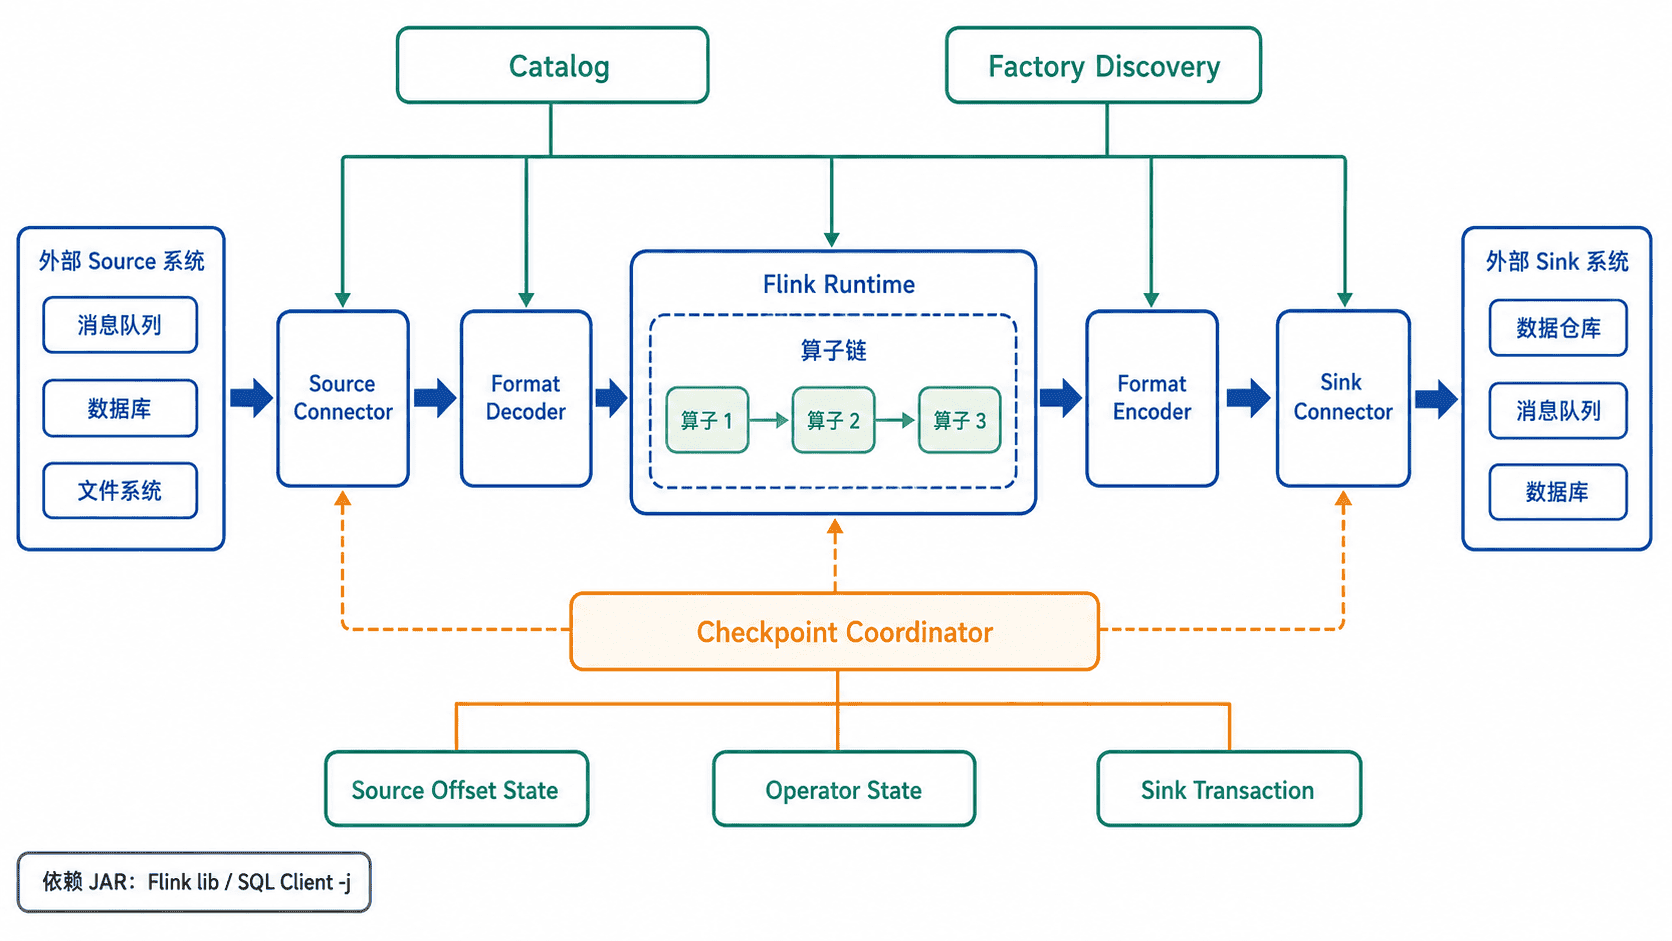
依赖加载与工厂发现
内置连接器可以直接使用,独立发布的连接器必须把与运行时兼容的 JAR 放入集群类路径,或在 SQL Client 启动时通过 -j 加载。<VERSION> 表示连接器发行版本,<PATH> 表示本机实际目录;两者必须按目标 Flink 版本和连接器文档替换。
./bin/sql-client.sh embedded -j /<PATH>/flink-sql-connector-kafka-<VERSION>.jar预期输出
Flink SQL>进入 SQL Client 后执行 SHOW JARS,确认当前会话确实加载了目标文件,而不是仅把 JAR 放在了错误目录。
SHOW JARS;预期结果
file:/<PATH>/flink-sql-connector-kafka-<VERSION>.jar若创建表时报 Could not find any factory for identifier,先检查连接器 JAR 是否被 JobManager 与 TaskManager 同时加载,再检查连接器版本、重复依赖和 shading 后是否丢失 META-INF/services。只在本地 SQL Client 可见而集群节点不可见,也会导致提交后失败。
用 Kafka 表验证读写链路
下面的 SQL 需要已运行的 Kafka、已创建的 order-events 与 order-audit 主题,以及已加载的 Kafka SQL Connector。它启用周期 Checkpoint,并要求 Sink 使用事务实现 exactly-once;transactional-id-prefix 在同一 Kafka 集群中应保持唯一。
SET 'execution.checkpointing.interval' = '10 s';

CREATE TABLE order_source (
  order_id STRING,
  amount DECIMAL(12, 2),
  event_time TIMESTAMP(3),
  WATERMARK FOR event_time AS event_time - INTERVAL '5' SECOND
) WITH (
  'connector' = 'kafka',
  'topic' = 'order-events',
  'properties.bootstrap.servers' = 'localhost:9092',
  'properties.group.id' = 'flink-order-reader',
  'scan.startup.mode' = 'group-offsets',
  'format' = 'json'
);

CREATE TABLE order_sink (
  order_id STRING,
  amount DECIMAL(12, 2),
  event_time TIMESTAMP(3)
) WITH (
  'connector' = 'kafka',
  'topic' = 'order-audit',
  'properties.bootstrap.servers' = 'localhost:9092',
  'format' = 'json',
  'sink.delivery-guarantee' = 'exactly-once',
  'sink.transactional-id-prefix' = 'order-audit-'
);

INSERT INTO order_sink
SELECT order_id, amount, event_time
FROM order_source;
预期结果
流式作业提交成功,返回作业标识 <ID>;作业持续运行并等待 order-events 中的新消息。验证时不要只看作业是否为 RUNNING。应向源主题写入带唯一 order_id 的测试消息,确认目标主题收到相同字段;随后触发一次 Checkpoint 并重启作业,检查恢复后是否出现丢失或重复。
一致性能力如何判断
| 环节 | 需要确认的能力 | 不能满足时的结果 |
|---|---|---|
| Source | 消费位置进入 Checkpoint 并可恢复 | 故障后可能跳过或重复读取 |
| Flink 状态 | Checkpoint 成功且状态后端可恢复 | 算子状态回退或丢失 |
| Sink | 事务提交、两阶段提交或幂等写入 | 可能产生重复或部分写入 |
| 外部系统 | 事务隔离、唯一键或幂等键 | 连接器无法单独保证端到端 exactly-once |
“Exactly-once 连接器”不等于所有业务都天然 exactly-once。若 Sink 外部系统只支持普通追加写,最多只能依靠至少一次投递加业务去重;若写入包含多个外部系统,即使各自支持事务,也需要额外的跨系统一致性设计。
选型与排查顺序
选择连接器时先确认目标 Flink 版本是否有兼容发行包,再确认 Source 与 Sink 支持的 changelog 模式、并行度和一致性语义。接着检查格式是否支持目标字段类型、时间类型和空值,最后用故障恢复测试验证文档中的保证是否在当前配置下成立。
排查连接器问题应按“依赖可见性、工厂发现、网络与权限、数据格式、Checkpoint 与事务”顺序进行。这样可以先排除启动阶段错误,再处理运行期的数据质量和一致性问题。