
大数据与流处理 / 系统课时
流处理与批处理
流处理与批处理
流处理与批处理的核心差异,不在于是否使用不同框架,而在于数据是否存在明确边界。本课将从有界数据与无界数据出发,解释两种处理方式的执行特点,并建立 Flink 统一处理批、流任务的基本认知。
学习目标
- 从数据边界角度区分流处理与批处理
- 理解两种处理方式在结果、延迟和状态上的差异
- 说明 Flink 如何使用统一模型处理有界流与无界流
从数据边界理解批与流
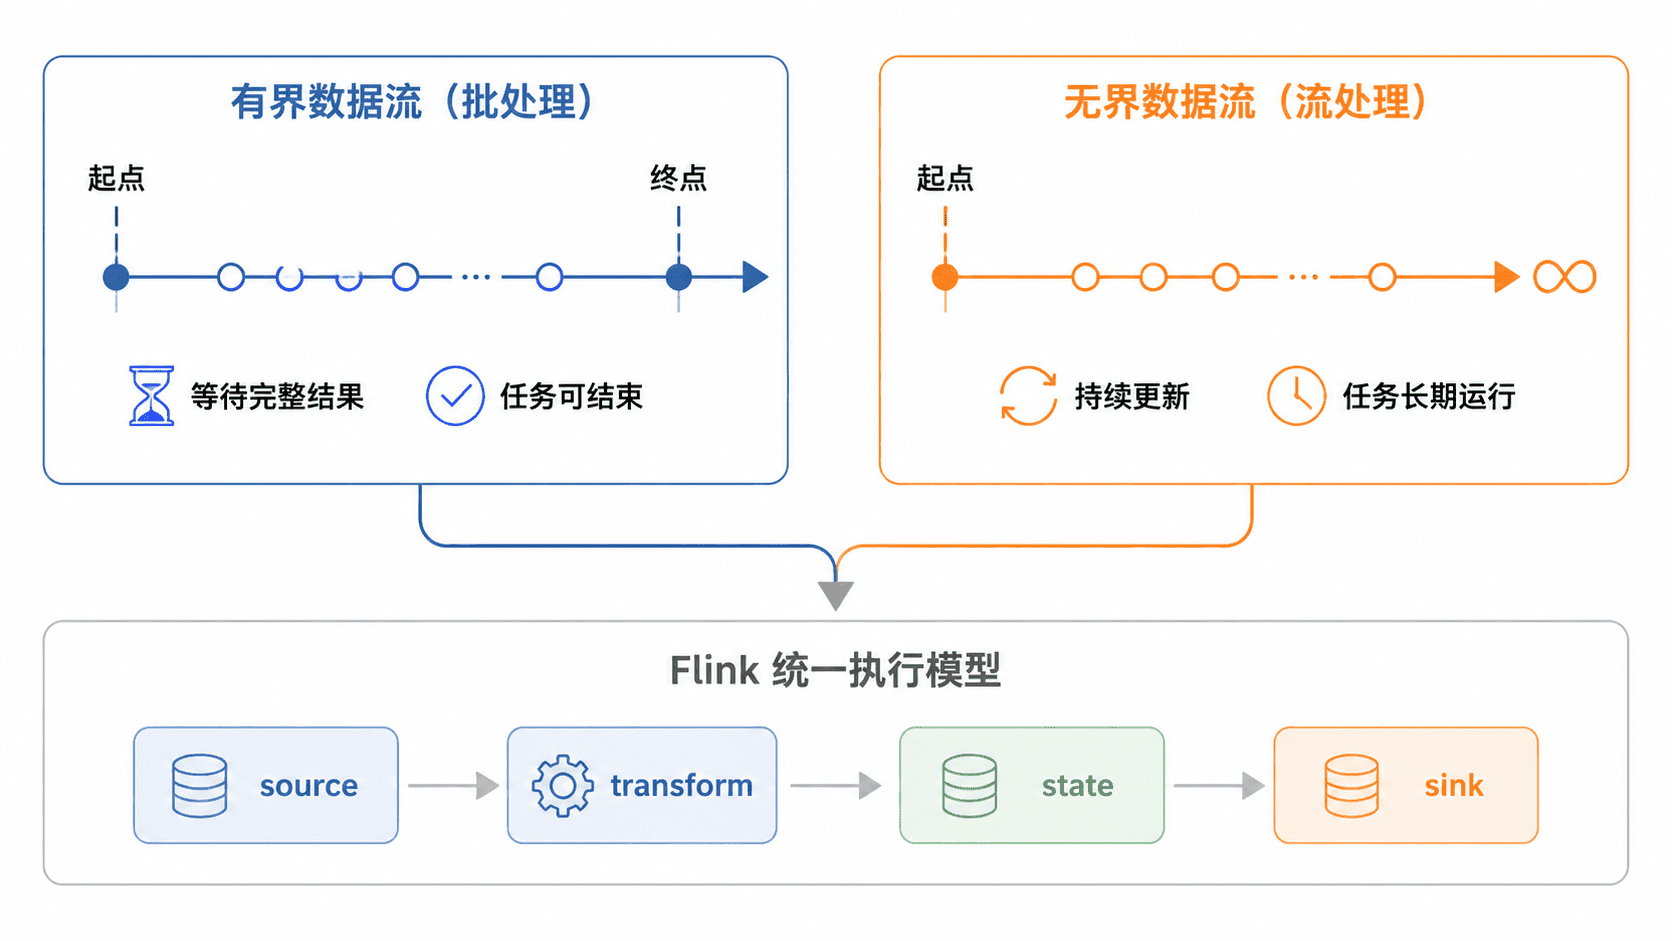
批处理面对的是有界数据。任务启动时,数据集可能已经完整存在;即使数据从文件或数据库逐步读入,系统也能够判断何时读取结束。例如,分析昨天生成的访问日志、统计某月订单总额,都属于典型批处理。
流处理面对的是无界数据。数据会持续到达,处理程序通常长期运行,无法等待“全部数据到齐”再开始计算。例如,实时接收支付事件、设备指标或用户点击记录,都属于典型流处理。
因此,批与流并不是由文件、消息队列等存储介质决定,而是由数据源是否能够发出结束信号决定。同一份历史消息可以作为有界数据重放,持续接入的新消息则构成无界数据流。
两种处理方式的关键差异
批处理通常追求数据集处理完成后的最终结果。系统可以扫描全部记录,再执行全局排序、完整聚合或多轮迭代。其延迟往往以分钟或小时衡量,但更容易获得完整且稳定的结果。
流处理强调数据到达后的快速响应。结果可能随着新事件持续更新,例如某商品最近五分钟的订单数会不断变化。系统不能无限保存所有历史数据,因此常借助窗口、状态和过期策略限制计算范围。
| 观察维度 | 批处理 | 流处理 |
|---|---|---|
| 数据边界 | 有明确结束位置 | 持续到达,通常没有结束位置 |
| 结果形态 | 数据处理完成后输出最终结果 | 持续输出或更新中间结果 |
| 延迟目标 | 分钟级、小时级或更长 | 秒级、毫秒级或近实时 |
| 状态管理 | 可依赖完整数据重新计算 | 需要长期维护并清理运行状态 |
| 常见场景 | 离线报表、历史回算、数据迁移 | 实时监控、风控、告警、在线指标 |
无界数据如何得到可计算结果
无界数据没有自然终点,但业务通常只关心有限范围。例如,“每分钟订单数”只需要处理一分钟内的数据,“截至当前的累计销售额”只需要维护一个不断更新的聚合状态。
窗口把无限数据划分为有限片段,使排序、聚合和关联等操作能够阶段性地产生结果。状态则保存跨事件所需的信息,例如当前累计值、已经出现的用户或尚未匹配的订单。时间语义与水位线用于判断事件属于哪个时间范围,以及系统何时可以认为某个窗口大致收齐。
这意味着流处理并不是简单地逐条读取并立即丢弃数据,而是在持续输入、有限状态和阶段性结果之间取得平衡。
Flink 的统一执行模型
Flink 将批处理视为有界流处理,将实时处理视为无界流处理。两类任务都可以抽象为数据从 Source 进入,经过转换、分区、状态计算,再写入 Sink 的执行图。
统一模型的价值在于,开发者不必为同一种业务逻辑维护完全独立的批处理和流处理实现。例如,一套清洗与聚合逻辑既可以消费实时消息,也可以读取历史文件进行回放或补算。
统一并不代表执行方式完全相同。对于有界数据,运行时可以在确认输入结束后采用更适合批任务的调度、排序和资源释放策略;对于无界数据,运行时需要持续调度任务,并通过检查点保护长期状态。数据边界相同的算子逻辑,可以由运行时选择不同的执行优化。
选择处理方式的判断方法
当业务必须等待全部数据才能得出有意义的结论,或者只需要周期性产出历史报表时,优先采用有界批处理。当业务需要在事件到达后快速作出判断,并且结果允许持续更新时,应采用无界流处理。
实际系统常同时包含两者。例如,实时链路计算当日指标,批处理链路负责历史回算、数据修正和周期报表。使用 Flink 的统一模型后,两条链路可以共享数据结构、转换逻辑和测试方法,但仍需分别设计延迟目标、状态规模与结果一致性。