
大数据与流处理 / 系统课时
API 与生态组件
API 与生态组件
本课解决“面对实时计算需求该从哪个 Flink 入口开始”这一问题。你将区分 DataStream API、Table API、Flink SQL、CDC 与连接器的职责,并学会按控制粒度、开发方式和数据来源组合它们。
学习目标
- 区分 DataStream API、Table API 与 Flink SQL 的适用场景
- 理解 CDC 和连接器在数据接入链路中的位置
- 能为常见实时任务选择最短实现路径
三种开发入口如何分工
DataStream API 面向事件流和算子级控制,适合需要自定义状态、定时器、窗口、异步 I/O 或复杂分流的场景。它最灵活,但开发者需要更明确地处理类型、状态和执行语义。
Table API 使用 Java、Scala 或 Python 表达关系运算。它保留编程语言的组合能力,同时交给优化器决定连接、聚合和执行计划,适合结构化数据处理和需要动态拼装查询的应用。
Flink SQL 直接使用 SQL 描述结果,最适合字段映射、过滤、聚合、维表关联和实时数仓分层。Table API 与 Flink SQL 共用表生态和优化器,二者可以互相转换,不是两套独立运行时。
| 入口 | 主要优势 | 典型任务 |
|---|---|---|
| DataStream API | 控制粒度最高 | 自定义状态、复杂事件处理、低层算子编排 |
| Table API | 编程组合与优化器兼顾 | 动态查询、结构化流批处理 |
| Flink SQL | 声明式、交付速度快 | 实时 ETL、聚合、关联、数仓分层 |
CDC 与连接器处在什么位置
连接器负责让 Flink 与外部系统交换数据,包括读取消息队列、数据库、文件和对象存储,以及写入下游系统。它解决的是“数据从哪里来、到哪里去”,不替代 DataStream、Table API 或 SQL 的计算逻辑。
CDC 是变化数据捕获能力,通常通过数据库日志持续获得插入、更新和删除事件。Flink CDC 可以把数据库表变化转换为动态表或事件流,再交给 SQL、Table API 或 DataStream API 处理。
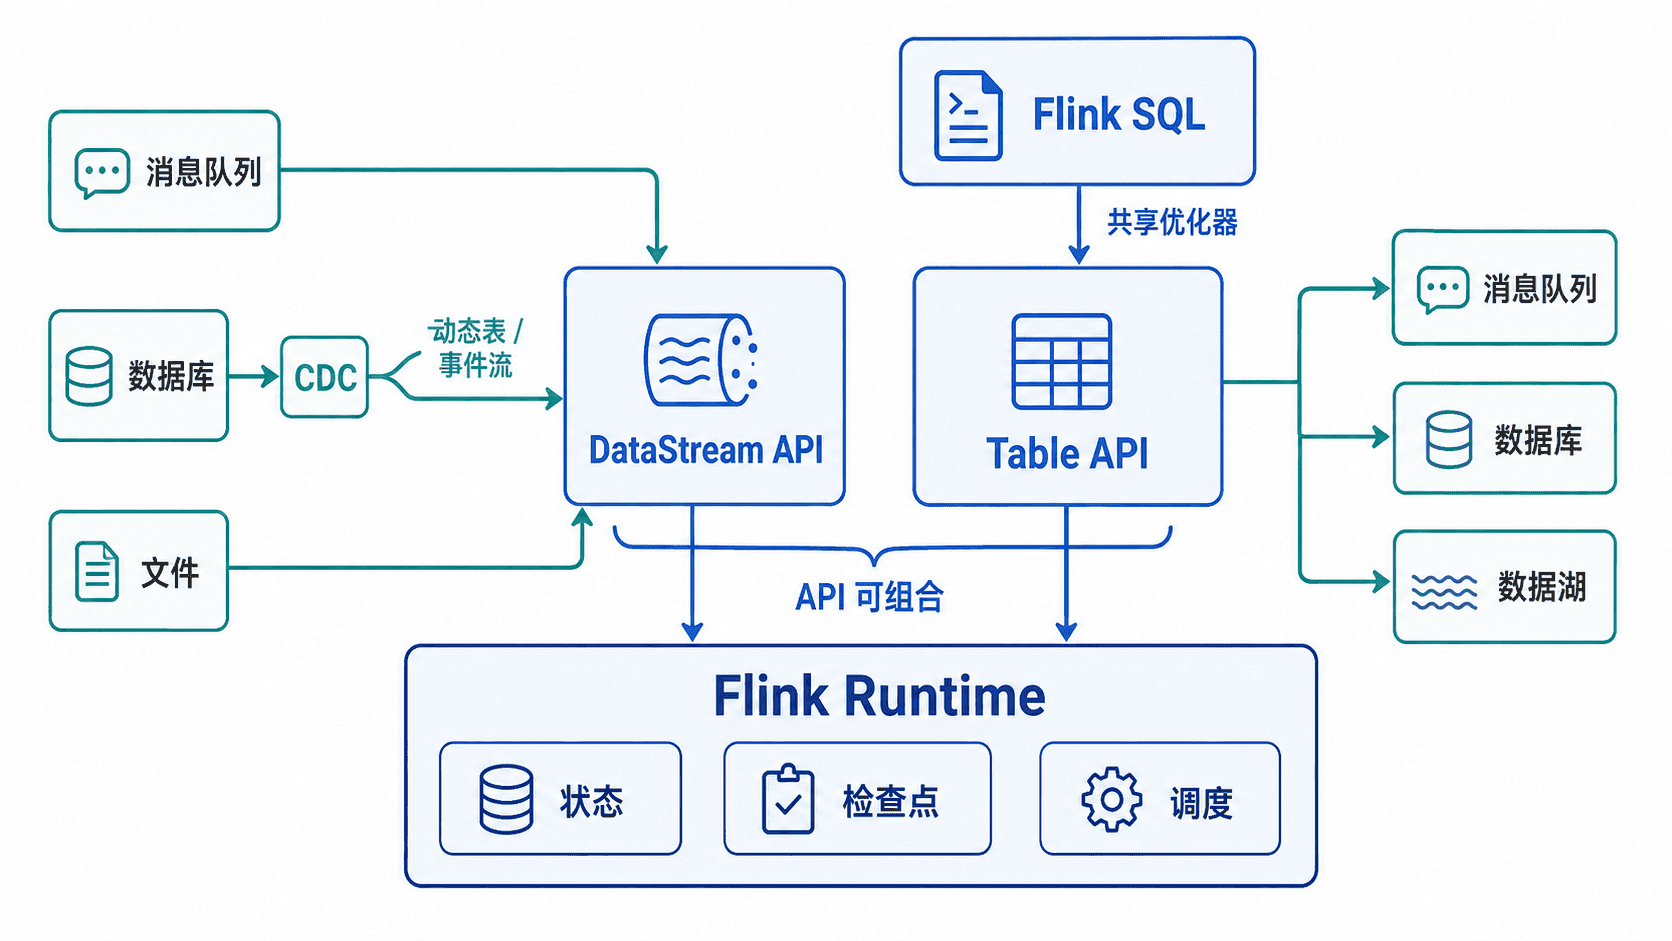
理解这层关系后,选型会更简单:先确定数据来源和去向,再选择连接器;再根据业务逻辑的表达方式,决定使用 SQL、Table API 还是 DataStream API。
用 Flink SQL 跑通最小链路
下面示例可在已启动的 Flink SQL Client 中执行。datagen 连接器持续生成测试数据,SQL 完成过滤与字段计算,print 连接器把结果写到终端。
CREATE TABLE source_orders (
  order_id BIGINT,
  amount INT
) WITH (
  'connector' = 'datagen',
  'rows-per-second' = '1',
  'fields.order_id.kind' = 'sequence',
  'fields.order_id.start' = '1',
  'fields.order_id.end' = '100',
  'fields.amount.min' = '10',
  'fields.amount.max' = '100'
);

CREATE TABLE sink_orders (
  order_id BIGINT,
  doubled_amount INT
) WITH (
  'connector' = 'print'
);

INSERT INTO sink_orders
SELECT order_id, amount * 2
FROM source_orders
WHERE amount >= 50;
预期结果
+I[<ID>, <AMOUNT>]输出会持续产生;<ID> 和 <AMOUNT> 是动态值。+I 表示插入记录,实际数值由 datagen 生成,只会保留 amount >= 50 的数据,且第二列等于原金额的两倍。
选择组合而不是只选一种 API
实时 ETL 和指标聚合通常优先使用 Flink SQL,因为规则直观、上线快。遇到 SQL 难以表达的自定义状态或事件时序,再把表转换为 DataStream,使用底层 API 完成特殊逻辑。
数据库变更同步一般采用 CDC 连接器接入,再用 SQL 做清洗和路由。消息队列消费则选择对应 Source 连接器,根据是否需要复杂状态决定使用 SQL 或 DataStream API。
不要把 CDC 当作计算 API,也不要把连接器当作业务逻辑。一个完整作业往往是“连接器接入 + API 处理 + 连接器输出”的组合,选择目标是降低复杂度,而不是统一技术入口。