
大数据与流处理 / 系统课时
保证同步一致性
保证同步一致性
实时同步的一致性不是“任务没有报错”,而是源端已确认的变更最终只在目标端生效一次,并且故障恢复后不丢失、不重复。本课用主键 Upsert、检查点恢复和分层核对组成一套可落地的闭环。
学习目标
- 解释检查点与端到端一致性的职责边界
- 使用目标表主键实现可重放的幂等写入
- 建立故障恢复后的数据核对与补偿流程
一致性的判定标准
CDC 任务通常至少经过源数据库、Flink 状态和目标数据库三个环节。检查点负责记录源端读取位置与算子状态,但故障可能发生在目标写入成功之后、检查点完成之前,因此恢复时同一批变更仍可能被重放。
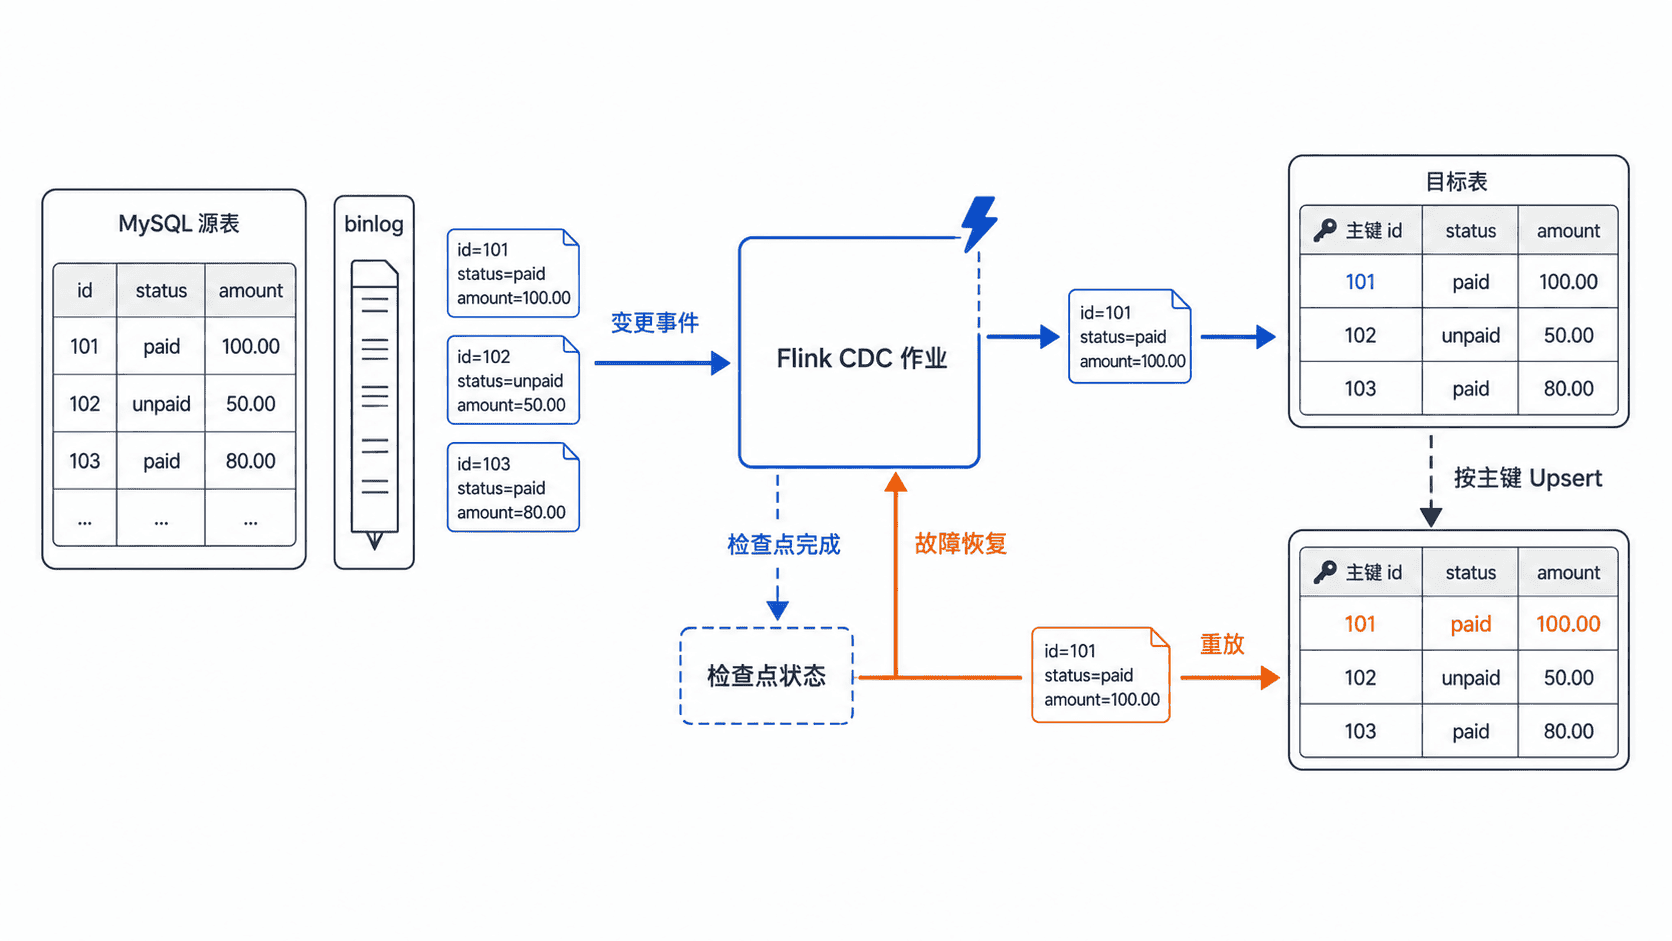
因此,工程上常用“检查点保证可恢复、主键写入吸收重放、数据核对发现偏差”的组合,把至少一次传输转化为业务效果上的一次生效。任何一环缺失,都不能只凭任务状态判断数据已经一致。
用主键把重放变成幂等更新
目标表必须存在真实的唯一主键。Flink DDL 中的 PRIMARY KEY ... NOT ENFORCED 只是向规划器声明键约束,并不会替你在 MySQL 中创建索引。先在目标库创建物理表:
CREATE TABLE IF NOT EXISTS orders_rt (
    id BIGINT NOT NULL,
    user_id BIGINT NOT NULL,
    status VARCHAR(32) NOT NULL,
    amount DECIMAL(18, 2) NOT NULL,
    updated_at DATETIME(3) NOT NULL,
    PRIMARY KEY (id)
);
预期结果:
Query OK, 0 rows affected再在 Flink SQL Client 中建立 CDC 源表与 JDBC 目标表。以下脚本假设 MySQL CDC 和 JDBC 连接器已经放入集群依赖目录,<HOST>、<PORT>、<USER>、<PASSWORD> 按实际环境替换。
SET 'execution.checkpointing.interval' = '10 s';
SET 'execution.checkpointing.mode' = 'EXACTLY_ONCE';

CREATE TABLE orders_cdc (
    id BIGINT,
    user_id BIGINT,
    status STRING,
    amount DECIMAL(18, 2),
    updated_at TIMESTAMP(3),
    PRIMARY KEY (id) NOT ENFORCED
) WITH (
    'connector' = 'mysql-cdc',
    'hostname' = '<HOST>',
    'port' = '<PORT>',
    'username' = '<USER>',
    'password' = '<PASSWORD>',
    'database-name' = 'trade_db',
    'table-name' = 'orders'
);

CREATE TABLE orders_sink (
    id BIGINT,
    user_id BIGINT,
    status STRING,
    amount DECIMAL(18, 2),
    updated_at TIMESTAMP(3),
    PRIMARY KEY (id) NOT ENFORCED
) WITH (
    'connector' = 'jdbc',
    'url' = 'jdbc:mysql://<HOST>:<PORT>/rt_db',
    'table-name' = 'orders_rt',
    'username' = '<USER>',
    'password' = '<PASSWORD>'
);

INSERT INTO orders_sink
SELECT id, user_id, status, amount, updated_at
FROM orders_cdc;
预期结果:
提交后作业进入 RUNNING,并按配置周期生成检查点。
源表同一 id 的 INSERT 或 UPDATE 最终对应目标表中的同一行。
发生恢复与重放时,相同主键会覆盖旧值,不会追加重复记录。
JDBC 写入并不因开启检查点就自动获得端到端严格一次语义。这里依赖目标表主键吸收重复事件;如果写入的是没有唯一键的明细表,恢复后的重放仍会生成重复行。
正确处理更新、删除与恢复
CDC 更新事件包含同一业务主键的新旧值。目标端采用 Upsert 时,新值覆盖旧行;若业务允许主键本身变化,应把它视为“删除旧键,再插入新键”,并确认下游连接器能够消费完整 Changelog。
删除事件也必须明确策略:需要镜像一致时就让删除传播到目标表;只保留历史时,应在进入 Sink 前转换成带删除标记的更新,而不是静默丢弃 DELETE。否则源表行数下降后,目标表会长期残留脏数据。
生产环境还应把检查点写入所有 TaskManager 都能访问的耐久存储,并配置合理的重启策略;只保存在故障节点本地,节点丢失后就无法恢复。恢复时依次检查四项:最近检查点是否完成、源端位点是否从该检查点恢复、目标表唯一键是否仍有效、是否有人手工跳过位点或清空状态。不要为了快速启动而改成最新位点,这会直接制造不可恢复的数据缺口。
用稳定边界进行数据核对
核对时不要查询仍在持续变化的“当前全表”。先选定一个已经停止变化的时间边界 <TIME>,分别在源表和目标表执行同一聚合;数量用于发现缺行,校验值用于发现内容差异。
SELECT
    COUNT(*) AS row_count,
    BIT_XOR(
        CAST(
            CRC32(
                CONCAT_WS(
                    '#',
                    id,
                    user_id,
                    status,
                    CAST(amount AS CHAR),
                    DATE_FORMAT(updated_at, '%Y-%m-%d %H:%i:%s.%f')
                )
            ) AS UNSIGNED
        )
    ) AS row_checksum
FROM orders
WHERE updated_at < '<TIME>';
预期结果:
源端:row_count=<COUNT>,row_checksum=<CHECKSUM>
目标端:row_count=<COUNT>,row_checksum=<CHECKSUM>
数量和校验值相同可作为快速核对结果,但哈希仍存在碰撞可能。发现不一致时,应按日期或主键区间二分缩小范围,再逐行比较并通过重放、补数任务或人工修复完成闭环。
常见破坏一致性的做法
- 目标表没有唯一键,却把检查点等同于“不会重复”
- 捕获重复键异常后直接忽略,导致较新的更新没有真正落库
- 作业恢复时重置到最新位点,跳过检查点之后尚未同步的变更
- 只比较总行数,不比较关键字段,也不固定核对时间边界