
大数据与流处理 / 系统课时
Kafka 分区与 Watermark
Kafka 分区与 Watermark
Kafka 分区决定读取任务能并行到什么程度,而分区级 Watermark 决定事件时间窗口何时推进。本课用一个可运行示例串起分区分配、最小 Watermark、空闲检测与对齐策略,帮助你定位“数据在进来但窗口迟迟不出结果”的问题。
学习目标
- 说明 Kafka 分区数与 Flink Source 并行度的映射关系
- 推导分区级 Watermark 合并后的整体计算进度
- 使用空闲检测和 Watermark 对齐处理快慢分区
从分区映射理解并行度
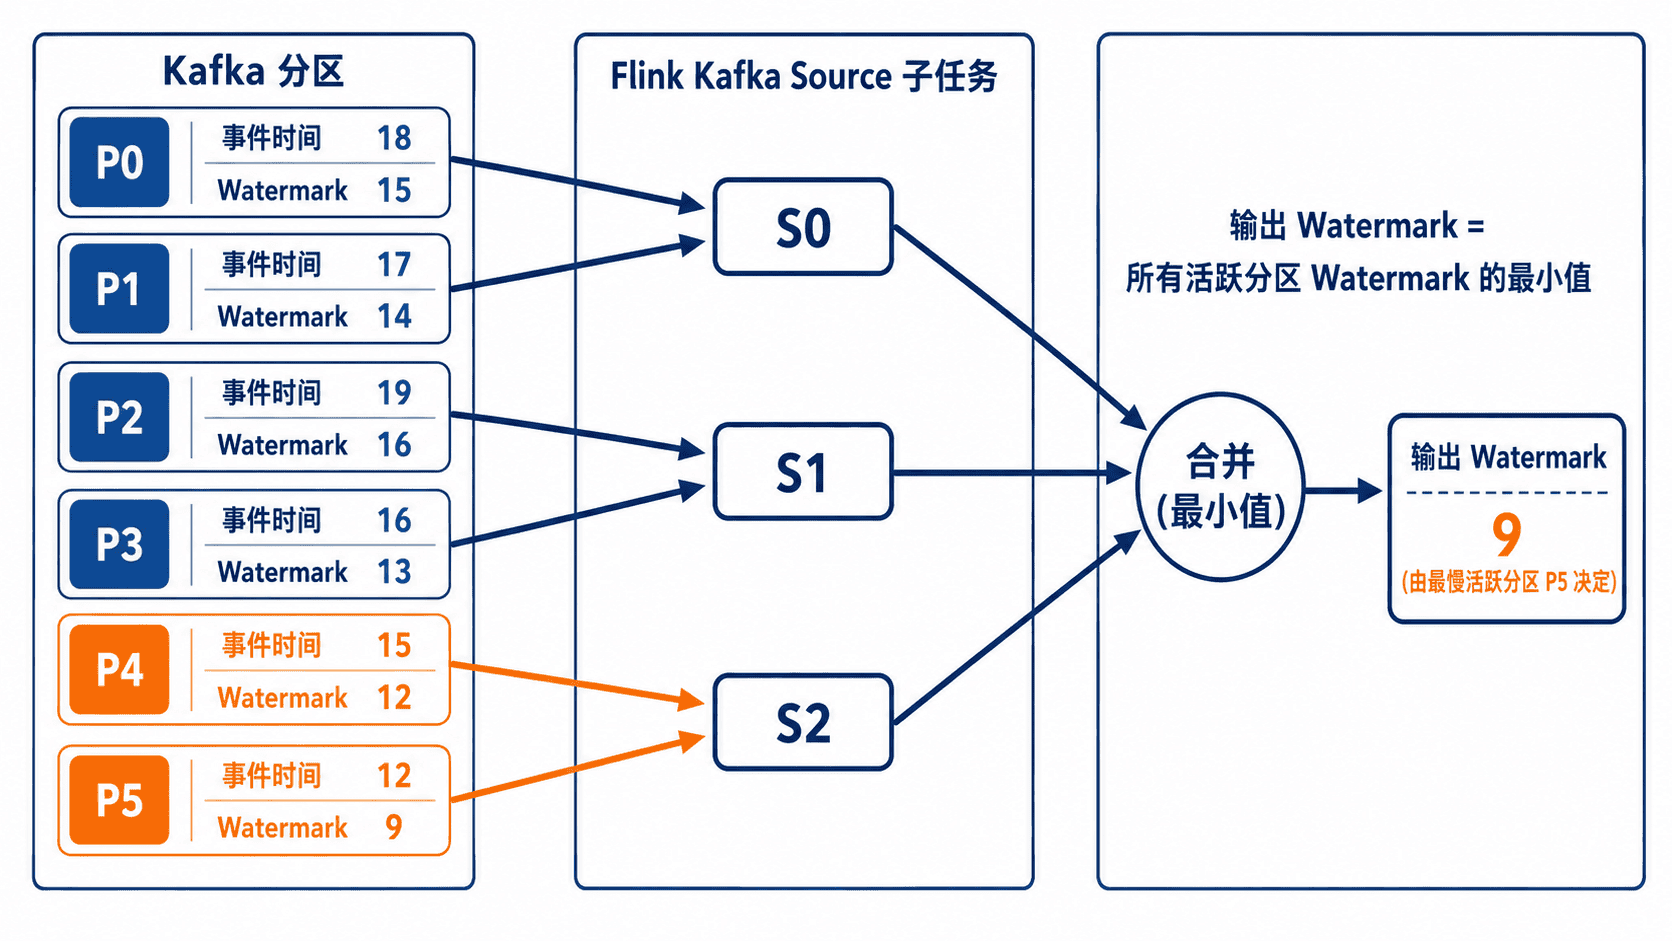
Kafka Source 把每个分区视为一个可分配的 split。假设主题有 6 个分区、Source 并行度为 3,通常每个 Source 子任务读取 2 个分区;并行度升到 8 时,最多仍只有 6 个子任务真正持有分区,其余子任务没有数据可读。
因此,Source 的有效读取并发上限近似为 min(分区数, Source 并行度)。分区数大于并行度时,一个子任务会同时管理多个分区;并行度大于分区数时,需要特别处理无分区或长期无数据的空闲读取器。Flink 官方文档明确指出,Kafka Source 不会仅因为并行度高于分区数就自动进入空闲状态。:contentReference[oaicite:0]{index=0}
Watermark 为什么由最慢分区决定
Kafka Source 可以在各分区内部依据事件时间生成 Watermark,再像流重分区一样合并。只要分区仍被视为活跃,Source 输出 Watermark 就不能越过其中最小的那个值,否则慢分区稍后到达的事件可能被错误判定为迟到数据。:contentReference[oaicite:1]{index=1}
设某个 Source 子任务读取三个活跃分区,其 Watermark 分别为 100 秒、96 秒和 40 秒,则该子任务只能向下游发送 40 秒。下游算子若还接收多个上游子任务,也会继续取最小值,因此一个冷分区能够拖住整条事件时间链路。
withIdleness 的作用不是提高慢分区速度,而是在指定时长内没有元素时,把该分区临时排除出最小值计算。超时时间过短会把正常低频分区误判为空闲,后续事件可能变成迟到数据;过长则会延迟窗口触发。
主示例:按事件时间汇总 Kafka 数据
下面程序读取格式为 传感器,事件时间毫秒,数值 的 Kafka 消息,允许 5 秒乱序,并在分区 30 秒无数据后标记为空闲。主题应至少提前创建,<PORT> 替换为 Kafka 实际端口。
package demo;

import org.apache.flink.api.common.eventtime.WatermarkStrategy;
import org.apache.flink.api.common.serialization.SimpleStringSchema;
import org.apache.flink.connector.kafka.source.KafkaSource;
import org.apache.flink.connector.kafka.source.enumerator.initializer.OffsetsInitializer;
import org.apache.flink.streaming.api.datastream.DataStream;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.streaming.api.windowing.assigners.TumblingEventTimeWindows;
import org.apache.flink.streaming.api.windowing.time.Time;

import java.time.Duration;

public class KafkaWatermarkDemo {
    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env =
                StreamExecutionEnvironment.getExecutionEnvironment();

        KafkaSource<String> source = KafkaSource.<String>builder()
                .setBootstrapServers("localhost:<PORT>")
                .setTopics("events")
                .setGroupId("flink-watermark-demo")
                .setStartingOffsets(OffsetsInitializer.earliest())
                .setValueOnlyDeserializer(new SimpleStringSchema())
                .build();

        WatermarkStrategy<String> watermarks = WatermarkStrategy
                .<String>forBoundedOutOfOrderness(Duration.ofSeconds(5))
                .withTimestampAssigner((line, previousTimestamp) ->
                        Long.parseLong(line.split(",", -1)[1]))
                // 低频或无分区子任务不再永久阻塞整体 Watermark
                .withIdleness(Duration.ofSeconds(30));

        DataStream<Event> events = env
                .fromSource(source, watermarks, "kafka-events")
                .setParallelism(3)
                .map(Event::parse);

        events.keyBy(event -> event.sensorId)
                .window(TumblingEventTimeWindows.of(Time.seconds(10)))
                .reduce((left, right) -> new Event(
                        left.sensorId,
                        Math.max(left.eventTime, right.eventTime),
                        left.value + right.value))
                .map(event -> event.sensorId + "," + event.value)
                .print();

        env.execute("kafka-partition-watermark-demo");
    }

    public static class Event {
        public String sensorId;
        public long eventTime;
        public int value;

        public Event() {
        }

        public Event(String sensorId, long eventTime, int value) {
            this.sensorId = sensorId;
            this.eventTime = eventTime;
            this.value = value;
        }

        public static Event parse(String line) {
            String[] fields = line.split(",", -1);
            if (fields.length != 3) {
                throw new IllegalArgumentException("非法消息: " + line);
            }
            return new Event(
                    fields[0],
                    Long.parseLong(fields[1]),
                    Integer.parseInt(fields[2]));
        }
    }
}
依次向 events 主题写入以下四行;前两条属于同一个 10 秒窗口,第四条会把最大事件时间推进到足以触发该窗口的位置。
sensor-a,1700000001000,3
sensor-a,1700000004000,2
sensor-a,1700000012000,1
sensor-a,1700000016000,4
预期输出
<ID>> sensor-a,5<ID> 是 print() 输出的并行子任务前缀,实际值可能不同。若其他 Kafka 分区没有消息,结果可能在空闲超时生效后才出现,这正是本示例要观察的现象。
空闲检测、对齐与并行度怎么选
当问题是“某些分区长期没数据,窗口不触发”时,优先使用合理的 withIdleness,并核对 Source 并行度是否无意义地高于分区数。若问题是“快分区推进太快,慢分区导致下游缓存大量未来数据”,可再使用 withWatermarkAlignment 限制 Watermark 漂移。
Watermark 对齐会暂停领先过多的 Source、split 或分区,让较慢输入追上,因此它以吞吐换取更稳定的状态规模。Flink 文档也提醒:同一读取器持有多个 split 时,连接器必须支持 split 级暂停与恢复,且分区数、并行度和分配关系会影响对齐效果。:contentReference[oaicite:2]{index=2}
排查时同时观察 pendingRecords、watermarkLag 和 sourceIdleTime:积压高说明读取跟不上,Watermark 延迟高但积压低通常说明事件时间或空闲策略有问题,空闲时间异常则应检查分区流量和超时配置。Kafka Source 官方监控指标包含这三类信息。:contentReference[oaicite:3]{index=3}