
大数据与流处理 / 系统课时
识别与处理背压
识别与处理背压
本课解决“作业吞吐下降但不知道卡在哪里”的问题。你将学会先从 Web UI 找到背压传播链,再用指标确认根因,最后针对算子、并行度或外部系统实施修复,并用吞吐、延迟和 Checkpoint 结果验证改动。
学习目标
- 理解背压的传播方向以及它与高负载的区别
- 使用 Web UI 和 REST 指标定位首个受压算子
- 根据 CPU、网络或外部 I/O 根因选择修复方式
背压如何形成
背压表示下游处理速度低于上游输入速度。下游缓冲区被占满后,上游无法继续发送数据,压力会沿数据流反向传播。因此,Web UI 中多个上游算子同时显示背压,并不代表它们都是根因;真正需要优先检查的是数据流方向上最靠下游、最先出现持续繁忙或阻塞的算子。
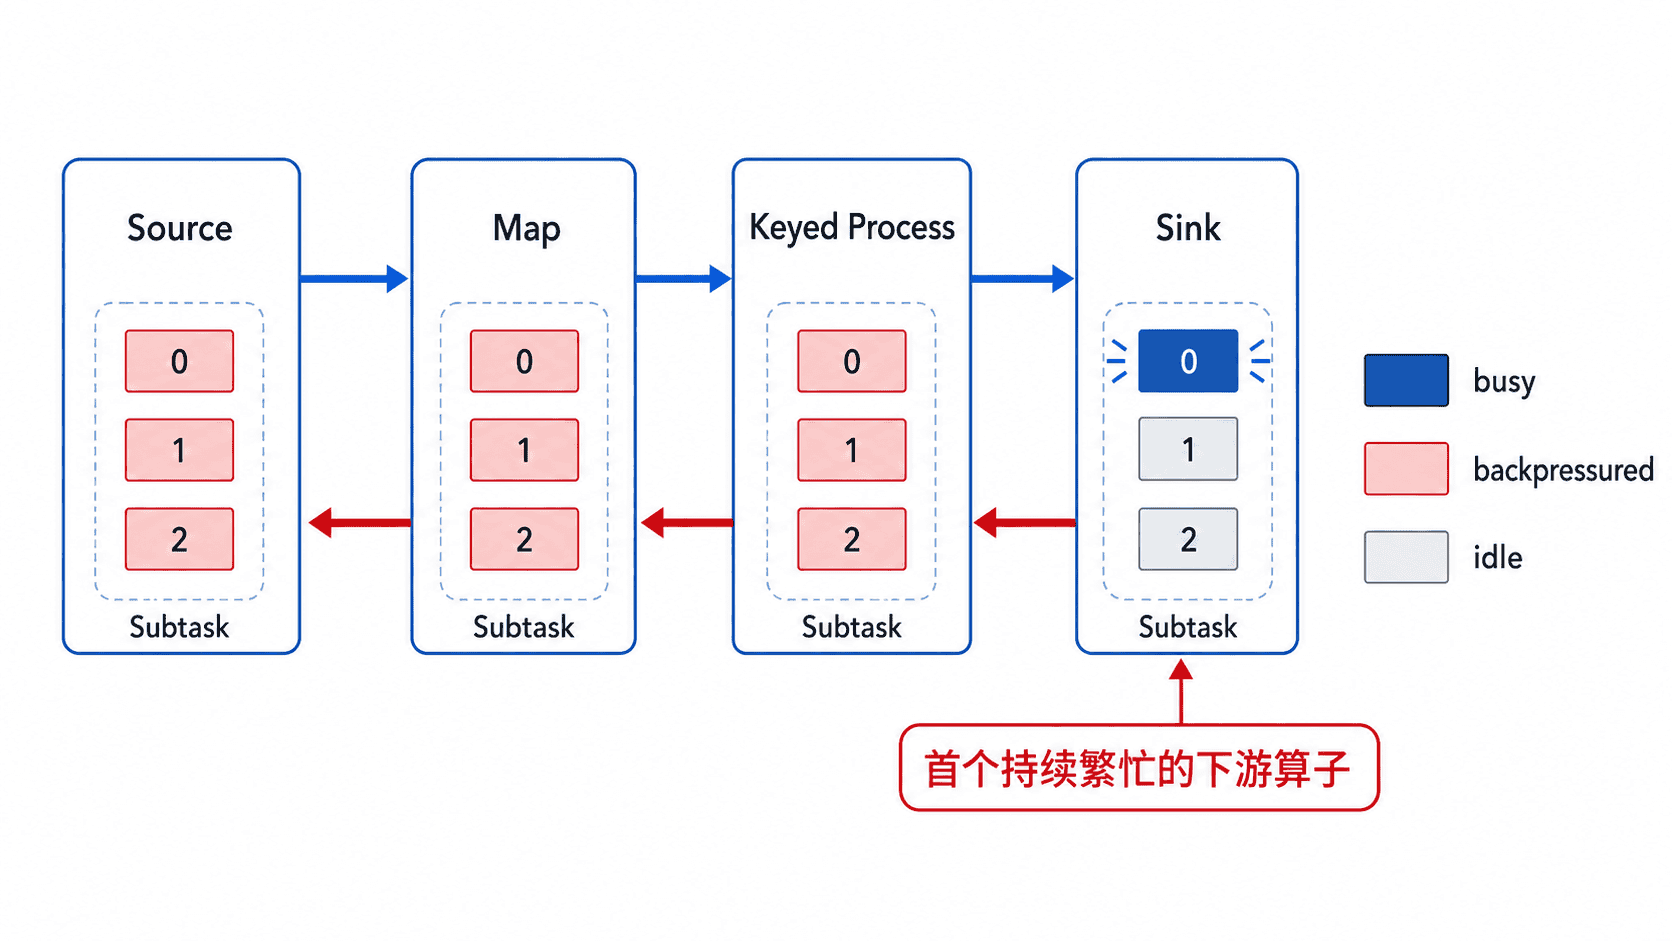
高 busy 只说明算子大部分时间在工作;高 backpressured 才表示它因下游无法接收而被阻塞。若某个算子自身 busy 很高,而其直接上游开始出现明显 backpressured,该算子通常就是重点排查对象。
按数据流方向定位
在 Flink Web UI 打开目标 Job,先查看 Job Graph,再从 Sink 向 Source 逆向检查各算子的 Back Pressure、Busy 和 Idle 状态。定位时遵循以下顺序:
- 找出持续背压而不是瞬时抖动的算子。
- 沿下游方向找到第一个不再背压、但长期繁忙的算子。
- 展开该算子的 Subtasks,判断是所有并行实例都慢,还是只有少数实例异常。
- 对照吞吐、延迟、Checkpoint 时长以及外部系统错误率,确认瓶颈类型。
所有 Subtask 都繁忙,通常说明整体容量不足;只有少数 Subtask 繁忙,则更像数据倾斜、节点资源异常或局部网络问题。若 Sink 最繁忙,还要同时检查数据库、Kafka、对象存储或远程接口的限流与响应时间。
使用 REST 指标交叉验证
下面的脚本读取指定算子各 Subtask 的背压、繁忙和空闲时间。运行前需要安装 curl 与 jq,并把 <ID> 替换为 Web UI 中的真实 Job ID 和 Vertex ID。
#!/usr/bin/env bash
set -euo pipefail

FLINK_REST_URL="${FLINK_REST_URL:-http://localhost:8081}"
JOB_ID="${JOB_ID:?请设置 JOB_ID}"
VERTEX_ID="${VERTEX_ID:?请设置 VERTEX_ID}"
METRICS="backPressuredTimeMsPerSecond,busyTimeMsPerSecond,idleTimeMsPerSecond"

curl -fsS \
  "${FLINK_REST_URL}/jobs/${JOB_ID}/vertices/${VERTEX_ID}/subtasks/metrics?get=${METRICS}" \
  | jq -r '.[] | "\(.id)=\(.value)"'
执行示例:
JOB_ID="<ID>" VERTEX_ID="<ID>" bash check-backpressure.sh预期输出:
backPressuredTimeMsPerSecond=<VALUE>
busyTimeMsPerSecond=<VALUE>
idleTimeMsPerSecond=<VALUE>
<VALUE> 会随负载变化。若背压时间长期接近每秒 1000 毫秒,说明该 Subtask 几乎一直无法向下游发送;若繁忙时间也接近 1000 毫秒,则应继续检查计算量、序列化、状态访问或外部调用。
根据根因实施修复
修复必须对准首个瓶颈,不能只在上游盲目增加并行度。
| 现象 | 常见根因 | 优先处理 |
|---|---|---|
| 所有 Subtask 都高 busy | CPU 计算、序列化或状态访问过重 | 优化热点逻辑,减少对象创建,适度提高并行度 |
| 少数 Subtask 高 busy | 热点 Key 或分区不均 | 统计 Key 分布,使用预聚合、拆分键或分层聚合 |
| Sink 高 busy 且外部延迟升高 | 数据库、接口或存储吞吐不足 | 批量写入、异步 I/O、连接池调优或扩容外部系统 |
| busy 不高但背压明显 | 网络缓冲、远端阻塞或线程等待 | 检查网络、阻塞调用、GC 与 TaskManager 资源 |
| Checkpoint 同时变慢 | 状态过大、反压导致 Barrier 对齐等待 | 缩小状态、优化后端,并评估非对齐 Checkpoint |
提高 Sink 并行度前必须确认外部系统能承受更多并发,否则只会把 Flink 内部背压转化为数据库连接耗尽、接口限流或写入失败。修改并行度后还要检查 maxParallelism、Keyed State 重分布成本以及恢复时间。
验证修复是否有效
修复后至少观察多个稳定负载周期和多个 Checkpoint 周期。有效改动应同时满足:首个瓶颈算子的 busy 或外部等待下降,上游背压明显减少,端到端吞吐恢复,延迟不再持续增长,Checkpoint 时长与失败率没有恶化。
不要只看背压颜色短暂变绿。若吞吐仍低、积压继续增长或外部错误率升高,说明瓶颈只是被移动到了其他位置,需要重新按数据流方向定位。