
大数据与流处理 / 系统课时
高可用配置
高可用配置
本课完成 Flink JobManager 高可用配置,避免单个协调节点故障导致集群失去调度和恢复能力。你将使用 ZooKeeper 完成领导者选举,把恢复元数据与 Checkpoint 放到共享存储,并通过一次受控切换验证备用 JobManager 能否接管。
学习目标
- 说明 JobManager 高可用保护的对象以及 ZooKeeper、共享存储各自的职责
- 配置独立集群的 ZooKeeper HA、集群标识和持久化目录
- 按正确顺序验证领导者切换与作业恢复结果
高可用究竟保护什么
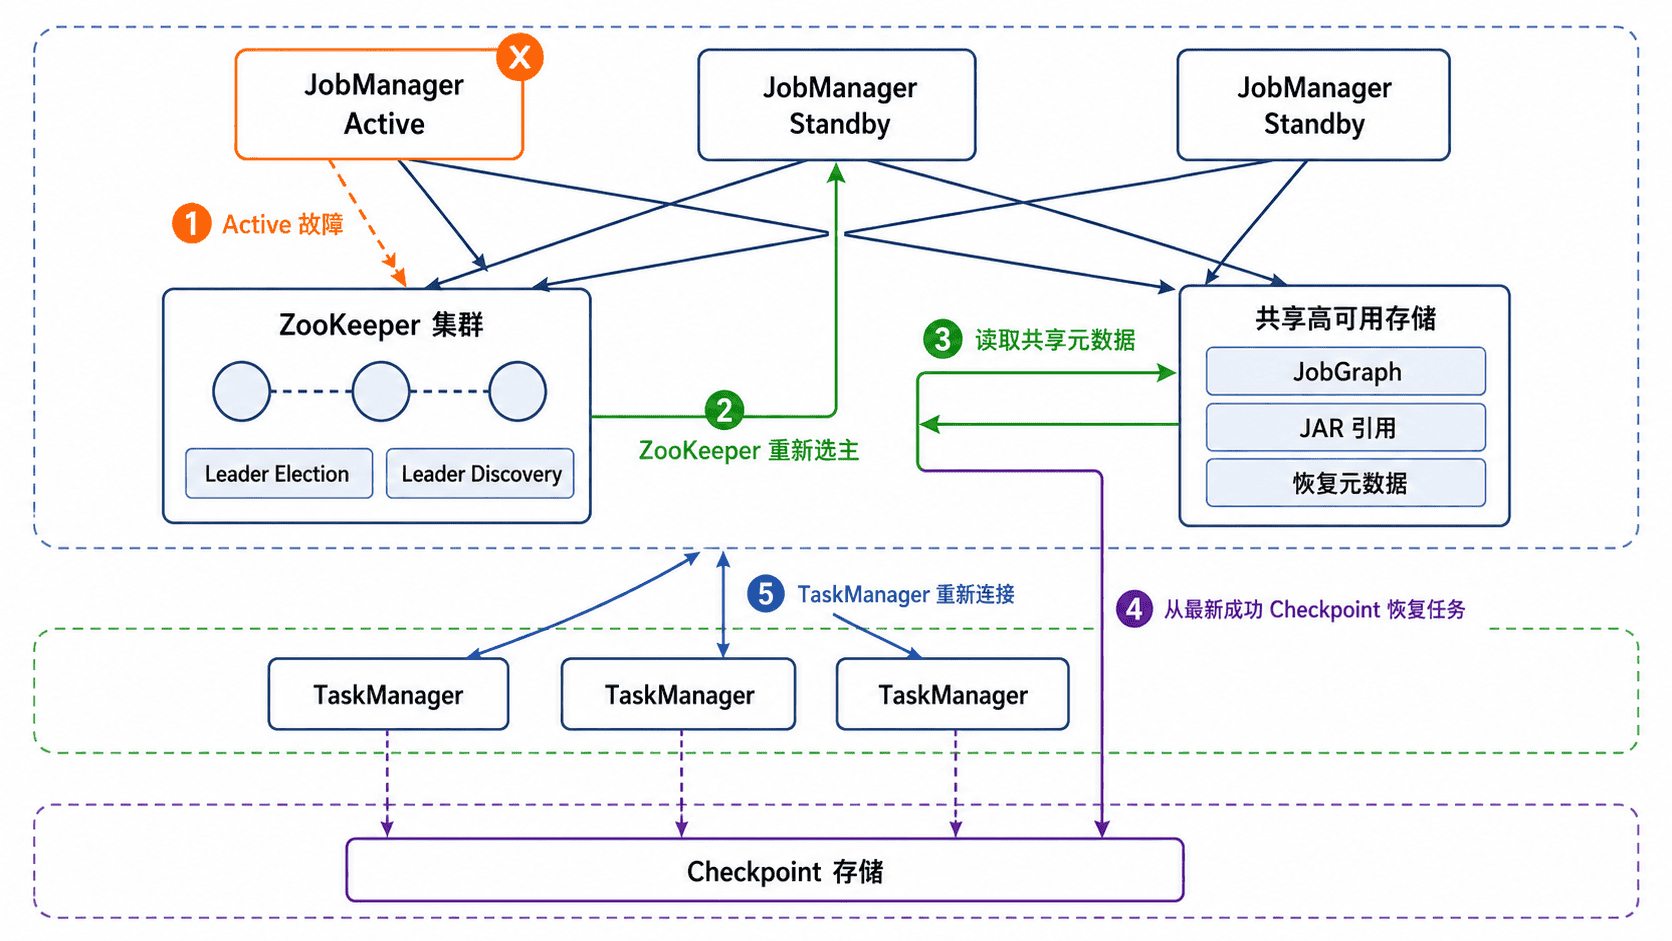
高可用集群会运行多个 JobManager 候选实例,但任意时刻只有一个领导者负责调度、资源协调和作业控制。ZooKeeper 负责领导者选举与服务发现;共享文件系统保存恢复 JobManager 所需的较大元数据;Checkpoint 保存算子状态和 Source 消费位置。
这三类能力不能互相替代。只有多个 JobManager 而没有选举服务,会出现多个节点争用或无法定位领导者;只有 ZooKeeper 而把恢复目录放在本地磁盘,备用节点仍然读不到元数据;只有 Checkpoint 而没有集群 HA,作业状态可恢复,但协调节点故障后缺少自动接管机制。
配置前置条件
生产环境至少需要可用的 ZooKeeper 复制组、所有 JobManager 都能访问的高可靠共享存储,以及两个或更多 JobManager 实例。high-availability.storageDir 与 Checkpoint 目录必须使用 HDFS、对象存储或其他具备持久性和多节点访问能力的文件系统,不能使用某台机器独有的本地目录。
同一 ZooKeeper 和存储后端可承载多个 Flink 集群,但独立部署必须使用不同的集群标识和目录,防止领导者节点、恢复元数据或清理操作相互干扰。在 YARN 或原生 Kubernetes 模式中,集群标识通常由资源管理平台生成,不应照搬独立集群的手工值。
配置 ZooKeeper HA
下面以独立部署的生产 Session 集群为例。主机名和存储 URI 需要替换为实际环境,并确保所有 JobManager 使用完全一致的配置。
high-availability.type: zookeeper
high-availability.zookeeper.quorum: zk1:2181,zk2:2181,zk3:2181
high-availability.zookeeper.path.root: /flink
high-availability.cluster-id: /prod-session-a
high-availability.storageDir: hdfs://nameservice1/flink/ha/prod-session-a

execution.checkpointing.dir: hdfs://nameservice1/flink/checkpoints/prod-session-a
execution.checkpointing.savepoint-dir: hdfs://nameservice1/flink/savepoints/prod-session-a
high-availability.storageDir 保存 JobManager 恢复元数据,ZooKeeper 中主要保存协调信息及其指针;execution.checkpointing.dir 保存运行中作业的状态快照,两者用途不同,建议使用相互独立的目录并设置合适的访问权限和生命周期策略。
Standalone HA 还需要在集群的 masters 配置中列出多个 JobManager 地址。片段示例依赖已经安装好的 Flink 集群:
jm1.example.com:8081
jm2.example.com:8081
jm3.example.com:8081
配置完成后,应从各节点确认 ZooKeeper 地址可达、共享目录可读写,并确保 JobManager 进程使用相同版本、插件和作业依赖。若对象存储或 HDFS 插件未安装,即使 URI 正确,启动或恢复阶段仍会因文件系统实现不可用而失败。
理解故障后的恢复顺序
领导者 JobManager 失联后,ZooKeeper 会从候选者中选出新的领导者。新领导者读取共享 HA 元数据,重新建立作业控制面,并让 TaskManager 重新注册或重连。对于启用了 Checkpoint 的流作业,任务会从最近一次成功 Checkpoint 恢复状态和输入位置;最近一次 Checkpoint 之后尚未固化的数据会按 Source 与一致性语义重新处理。
恢复时间主要由故障检测、重新选主、JobManager 初始化、状态下载和任务重新调度组成。HA 只能消除 JobManager 单点故障,不会自动解决 ZooKeeper 整体不可用、共享存储故障、Checkpoint 长期失败或外部 Sink 不具备幂等性等问题。
执行受控切换验证
先提交一个已启用 Checkpoint 的测试作业并确认至少存在一次成功 Checkpoint,再在测试环境或维护窗口停止当前领导者 JobManager。该操作会触发控制面切换,可能造成短暂不可用;不要在没有回滚方案和监控的生产高峰期直接执行。更保守的替代方案是在计划内滚动重启中观察同样的接管过程。
systemctl stop <JOBMANAGER_SERVICE>
sleep 10
bin/flink list -r
预期输出:
------------------ Running/Restarting Jobs -------------------
<TIME> : <ID> : <JOB_NAME> (RUNNING)
--------------------------------------------------------------
实际时间、作业 ID、作业名和接管耗时会不同。若命令无法连接集群,依次检查 ZooKeeper 是否完成选主、备用 JobManager 日志是否成功读取 storageDir、共享文件系统凭证是否一致,以及 REST 地址是否仍指向已停止的单机而不是负载均衡或稳定服务地址。
验证不能只看作业重新出现。还应确认最新成功 Checkpoint 被采用、Source 消费位置连续、业务指标恢复、Sink 没有非预期重复写入,并在原领导者重新加入后确认它成为候选或备用节点,而不是形成第二个独立集群。