
大数据与流处理 / 系统课时
部署项目到集群
部署项目到集群
本课把实时交易分析项目整理成可部署 JAR,配置集群资源、共享状态目录和日志目录,再以分离模式提交作业并完成运行验收,最终形成可重复执行的部署流程。
学习目标
- 生成依赖边界清晰的可部署 JAR
- 配置 JobManager、TaskManager、状态目录和日志目录
- 提交作业并通过命令、日志和检查点完成验收
规划部署拓扑与交付物
一次可控部署至少包含应用 JAR、Flink 集群配置、外部连接参数和持久化目录。客户端只负责提交作业;JobManager 负责调度与检查点协调;TaskManager 执行算子;状态存储必须独立于计算节点;日志应写入统一挂载目录并由采集系统读取。
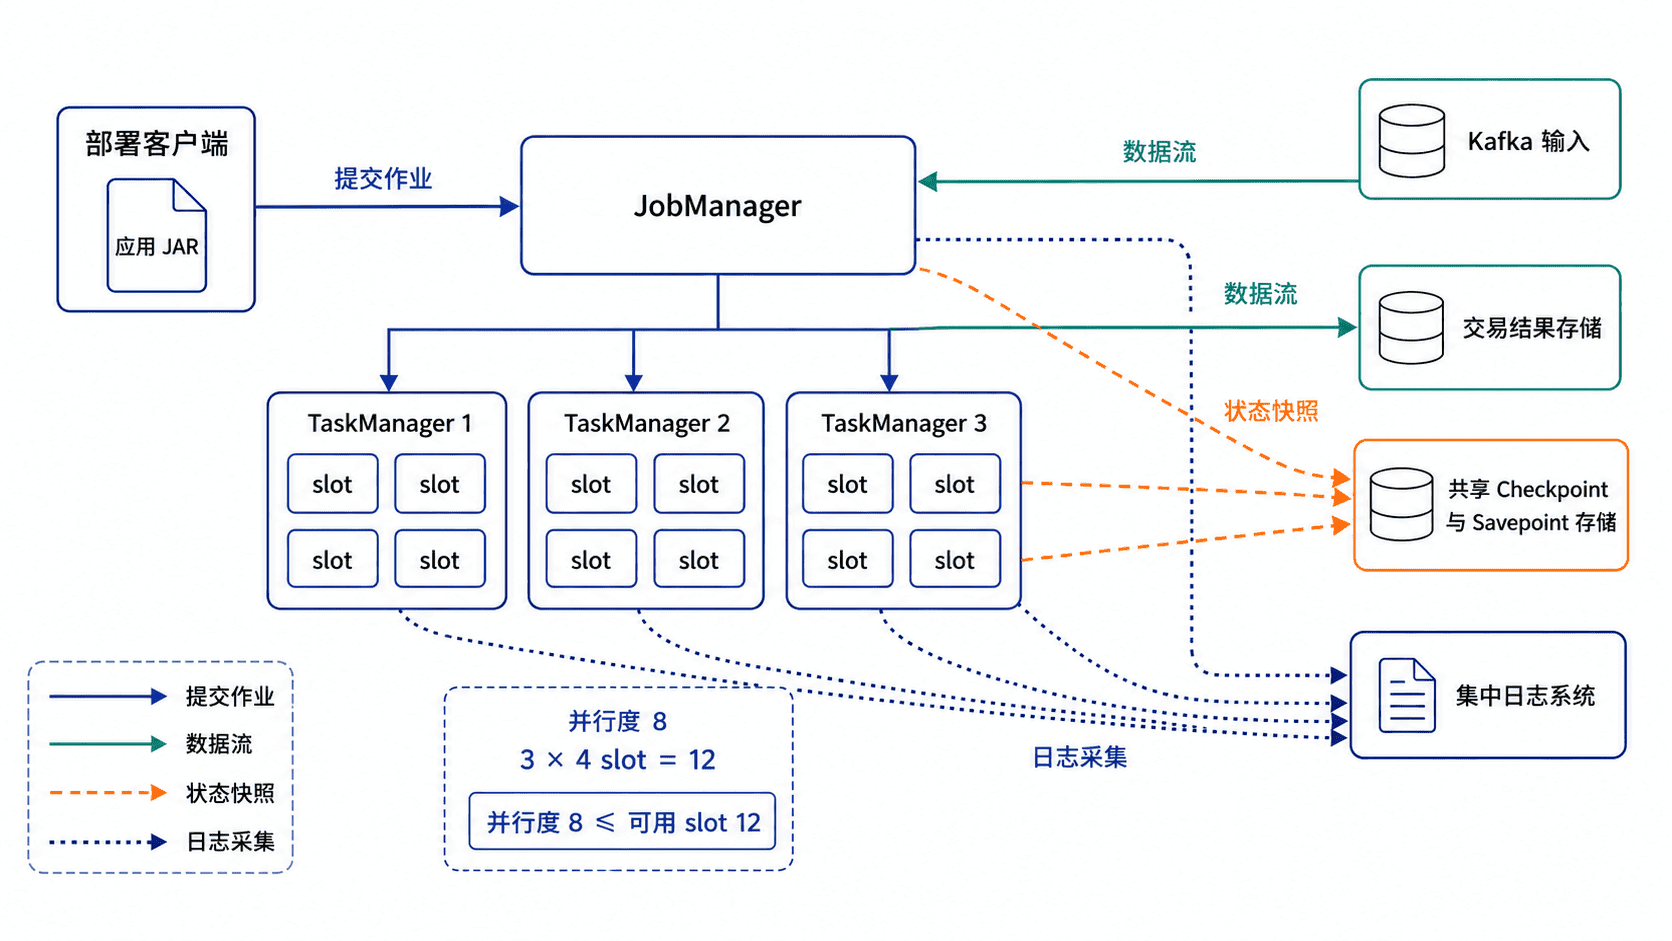
建议按版本保存交付物,例如 <PATH>/releases/1.0.0/flink-trade-analysis.jar,不要直接覆盖正在运行版本。配置文件和密钥应由部署环境注入,不要打进 JAR。
打包可部署 JAR
Flink 核心依赖通常由集群提供,应在 Maven 中使用 provided;业务依赖和集群未预装的连接器需要进入应用包。下面是 pom.xml 中的片段示例,用 Shade 插件生成带主类清单的 JAR;它依赖现有项目已声明 Flink 与业务依赖。
<build>
    <plugins>
        <plugin>
            <groupId>org.apache.maven.plugins</groupId>
            <artifactId>maven-shade-plugin</artifactId>
            <version>3.5.3</version>
            <executions>
                <execution>
                    <phase>package</phase>
                    <goals>
                        <goal>shade</goal>
                    </goals>
                    <configuration>
                        <createDependencyReducedPom>false</createDependencyReducedPom>
                        <transformers>
                            <transformer implementation="org.apache.maven.plugins.shade.resource.ManifestResourceTransformer">
                                <mainClass>com.anystack.flink.TradeAnalysisJob</mainClass>
                            </transformer>
                        </transformers>
                        <filters>
                            <filter>
                                <artifact>*:*</artifact>
                                <excludes>
                                    <exclude>META-INF/*.SF</exclude>
                                    <exclude>META-INF/*.DSA</exclude>
                                    <exclude>META-INF/*.RSA</exclude>
                                </excludes>
                            </filter>
                        </filters>
                    </configuration>
                </execution>
            </executions>
        </plugin>
    </plugins>
</build>
执行打包并检查主类是否进入 JAR。命令中的路径和版本号应替换为项目实际值。
set -euo pipefail

mvn -DskipTests clean package

JAR="target/flink-trade-analysis-1.0.0.jar"
test -f "$JAR"
jar tf "$JAR" | grep -q \
  'com/anystack/flink/TradeAnalysisJob.class'

printf 'deployable jar: %s\n' "$JAR"
预期输出
[INFO] BUILD SUCCESS
deployable jar: target/flink-trade-analysis-1.0.0.jar
若提交时出现 ClassNotFoundException,先确认业务类和连接器是否被打包;若出现 Flink 核心类冲突,则检查是否误把集群已提供的 Flink 依赖打入 JAR。
配置资源与持久化目录
以下是 conf/flink-conf.yaml 的核心片段。示例假设使用 HDFS 保存状态;实际环境也可以使用兼容的对象存储,但所有 JobManager 和 TaskManager 必须访问同一地址。
jobmanager.rpc.address: flink-jobmanager

jobmanager.memory.process.size: 2048m
taskmanager.memory.process.size: 4096m
taskmanager.numberOfTaskSlots: 4
parallelism.default: 4

state.checkpoints.dir: hdfs:///flink/checkpoints
state.savepoints.dir: hdfs:///flink/savepoints

restart-strategy.type: fixed-delay
restart-strategy.fixed-delay.attempts: 3
restart-strategy.fixed-delay.delay: 10s
配置生效后,每个 TaskManager 提供 4 个 slot,默认并行度为 4;检查点和保存点写入共享目录。资源配置不能只看总内存,还要给网络缓冲、托管内存和 JVM 开销留空间,避免把 taskmanager.memory.process.size 全部当作算子堆内存。
日志目录可在启动集群前通过环境变量统一指定,并确保运行用户拥有写权限。
set -euo pipefail

export FLINK_HOME=<PATH>
export FLINK_LOG_DIR=/var/log/flink

install -d -m 0755 "$FLINK_LOG_DIR"
"$FLINK_HOME/bin/start-cluster.sh"
"$FLINK_HOME/bin/flink" list
预期输出
Starting cluster.
No running jobs.
No scheduled jobs.
输出内容会因集群模式略有不同。验收时还应确认 /var/log/flink 中产生 JobManager 和 TaskManager 日志,并由日志采集器设置合理的轮转与保留周期。
提交作业与固定运行参数
把已验证的 JAR 复制到版本目录,再用分离模式提交。-p 4 将本次作业并行度固定为 4,避免完全依赖集群默认值;主类和 JAR 路径必须与打包结果一致。
set -euo pipefail

export FLINK_HOME=<PATH>
RELEASE_DIR=<PATH>/releases/1.0.0
JAR="$RELEASE_DIR/flink-trade-analysis.jar"

test -r "$JAR"

SUBMIT_OUTPUT="$(
  "$FLINK_HOME/bin/flink" run -d \
    -p 4 \
    -c com.anystack.flink.TradeAnalysisJob \
    "$JAR"
)"

printf '%s\n' "$SUBMIT_OUTPUT"
JOB_ID="$(printf '%s\n' "$SUBMIT_OUTPUT" \
  | awk '/JobID/{print $NF; exit}')"
test -n "$JOB_ID"

printf 'submitted job: %s\n' "$JOB_ID"
预期输出
Job has been submitted with JobID <ID>
submitted job: <ID>
若集群总 slot 少于并行度,作业会停留在等待资源状态。此时应增加 TaskManager、增加每个 TaskManager 的 slot,或降低并行度;不要通过无限提高 slot 数掩盖内存不足。
完成部署验收
提交后从运行状态、异常日志和检查点三个维度验收。命令只读取当前集群信息,不会修改作业。
set -euo pipefail

export FLINK_HOME=<PATH>

"$FLINK_HOME/bin/flink" list -r

grep -R -E "OutOfMemoryError|Checkpoint.*failed|Restarting job" \
  /var/log/flink | tail -n 20 || true

grep -R -E "Completed checkpoint" \
  /var/log/flink | tail -n 5
预期输出
<TIME> : <ID> : trade-analysis (RUNNING)
...
Completed checkpoint <ID> for job <ID>
最终还要核对输入消费速率、交易指标输出是否持续更新、失败检查点是否连续增长,以及日志目录是否具备轮转策略。只有“作业已提交”不能证明部署成功。