
大数据与流处理 / 系统课时
Watermark 对齐
Watermark 对齐
本课解决多输入或多分区事件时间推进速度不一致时,快数据导致下游窗口状态持续膨胀的问题。你将学会配置 Watermark 对齐、理解三个关键参数,并用指标判断对齐是否真正生效。
学习目标
- 说明 Watermark 漂移为何会放大窗口状态。
- 正确配置对齐组、最大漂移和更新间隔。
- 判断 Watermark 对齐的适用边界与验证方法。
对齐要解决的问题
一个窗口算子只有在输入 Watermark 越过窗口结束时间后才能清理状态。若 Kafka 的一个分区持续高速产生日志,另一个分区长期缓慢,快速分区会不断把未来窗口的数据送入下游,而慢分区的 Watermark 又阻止这些窗口关闭,结果是状态、检查点和反压压力一起增长。
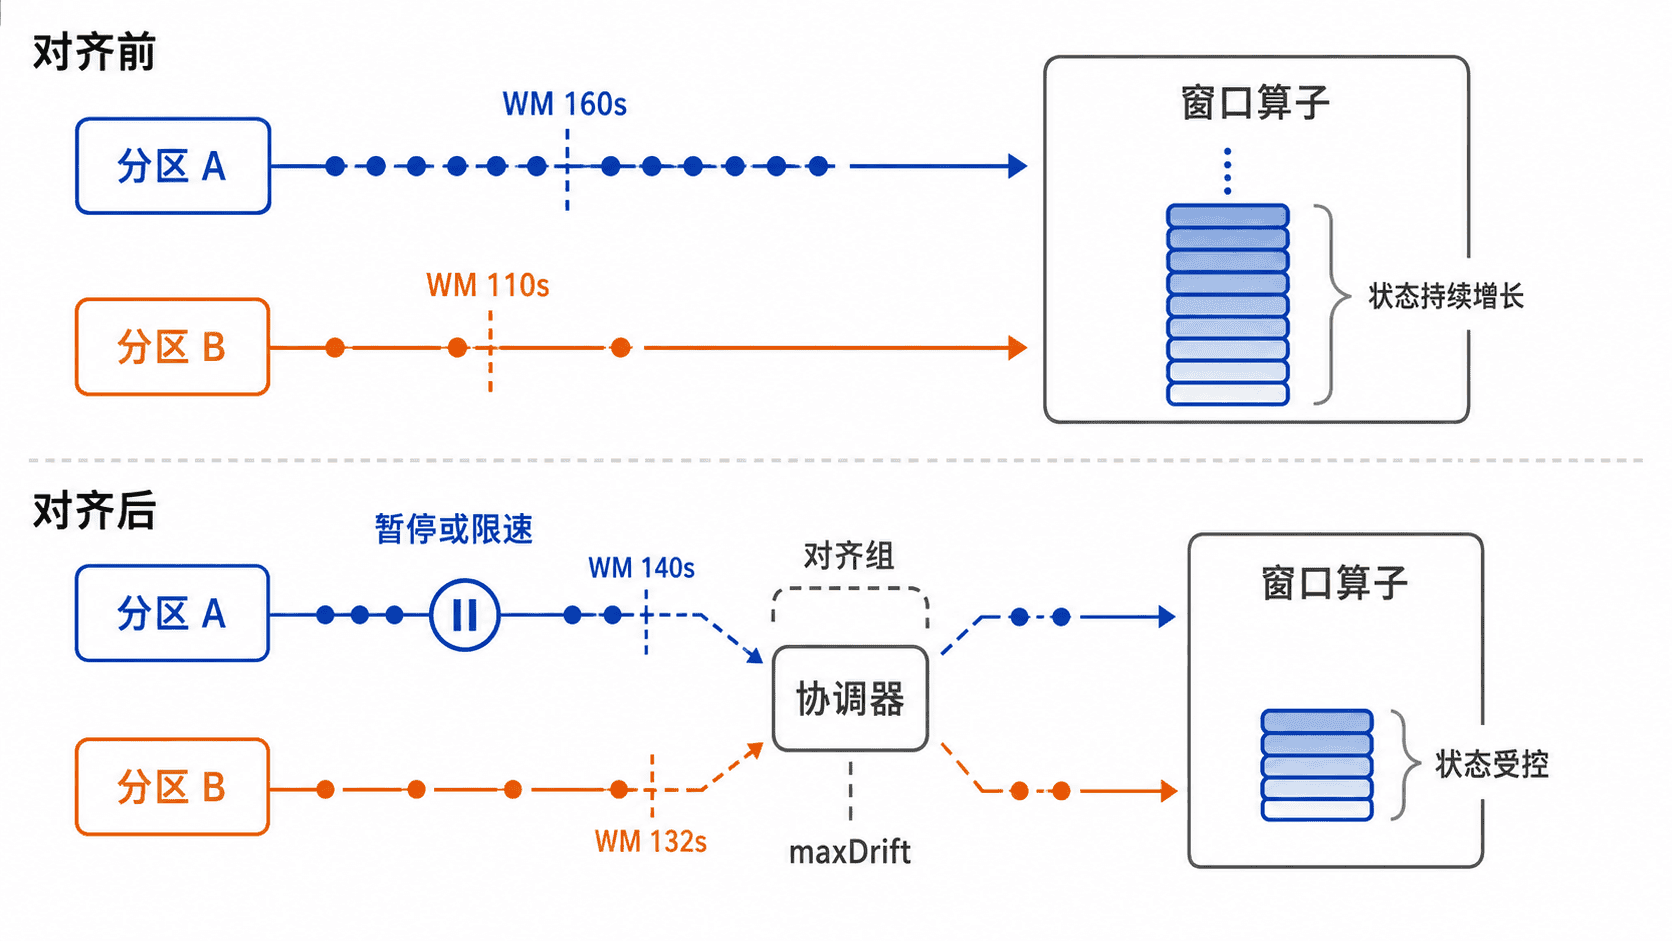
Watermark 对齐不会让慢分区变快,而是限制快分区领先的距离。它用吞吐换取有界状态,适合各输入速率差异大、窗口跨度长且状态成本高的事件时间作业。
对齐机制与参数
同一对齐组中的源会周期性汇报 Watermark。协调器以组内较慢进度为基准;当某个源领先超过允许漂移时,运行时会暂缓该源继续读取,待整体差距回到阈值内再恢复。
| 参数 | 作用 | 调整原则 |
|---|---|---|
groupName |
标识需要共同对齐的源 | 只有存在下游关联关系的源才放入同一组 |
maxDrift |
允许最快与最慢 Watermark 的最大差距 | 越小越省状态,但越容易限制吞吐 |
updateInterval |
汇报和重新计算对齐状态的周期 | 越小响应越快,但协调开销更高 |
Java 配置示例
下面是片段示例,依赖已创建的 StreamExecutionEnvironment env、KafkaSource<OrderEvent> kafkaSource,以及包含 eventTimeMillis() 方法的事件类型。核心是把乱序容忍、空闲检测和对齐放在同一个 WatermarkStrategy 中。
import java.time.Duration;
import org.apache.flink.api.common.eventtime.WatermarkStrategy;
import org.apache.flink.connector.kafka.source.KafkaSource;
import org.apache.flink.streaming.api.datastream.DataStream;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;

WatermarkStrategy<OrderEvent> watermarkStrategy =
        WatermarkStrategy.<OrderEvent>forBoundedOutOfOrderness(Duration.ofSeconds(5))
                .withTimestampAssigner((event, recordTimestamp) -> event.eventTimeMillis())
                .withIdleness(Duration.ofSeconds(30))
                .withWatermarkAlignment(
                        "orders-alignment",
                        Duration.ofSeconds(20),
                        Duration.ofSeconds(1));

DataStream<OrderEvent> orders = env.fromSource(
        kafkaSource,
        watermarkStrategy,
        "orders-source");
生效结果:同一 orders-alignment 组内,任一源的 Watermark 最多领先组内最慢进度约 20 秒;每 1 秒重新协调一次。空闲超过 30 秒的分区不会无限拖住全局 Watermark。
验证与边界
先观察窗口算子的 currentInputWatermark、currentOutputWatermark、状态大小和反压。开启对齐后,输入 Watermark 的差距应受控,状态增长速度应下降;若吞吐同步下降,说明快源正在被主动限速,这是预期代价。
还要注意三点:连接器必须支持源分片的暂停与恢复;所有需要对齐的源必须使用相同组名;对齐不能替代乱序容忍和空闲分区检测。若真正问题是时间戳单位错误或某分区永久没有数据,应先修复时间语义,而不是继续收紧 maxDrift。