
大数据与流处理 / 系统课时
CDC 工作原理
CDC 工作原理
本课建立 CDC 的整体心智模型:数据变化如何被捕获、排序并传入实时管道,以及日志型 CDC、轮询同步和应用双写在实时性、完整性与一致性上的根本差异。
学习目标
- 说明日志型 CDC 从全量快照切换到增量日志的过程
- 比较日志型、轮询型和双写方案的适用边界
- 识别删除丢失、顺序错乱和双写不一致等风险
CDC 捕获的不是最终表,而是变化
CDC 是 Change Data Capture,即捕获数据的新增、修改和删除。实时管道真正需要的通常不是周期性复制整张表,而是把每次变化表示成带主键、操作类型、变更前后值和顺序位置的事件。
典型日志型 CDC 会先读取当前表的快照,再从与快照一致的位置持续消费事务日志。快照解决“已有数据从哪里来”,增量日志解决“之后发生了什么”;二者必须在同一个一致性边界上衔接,否则会遗漏或重复。
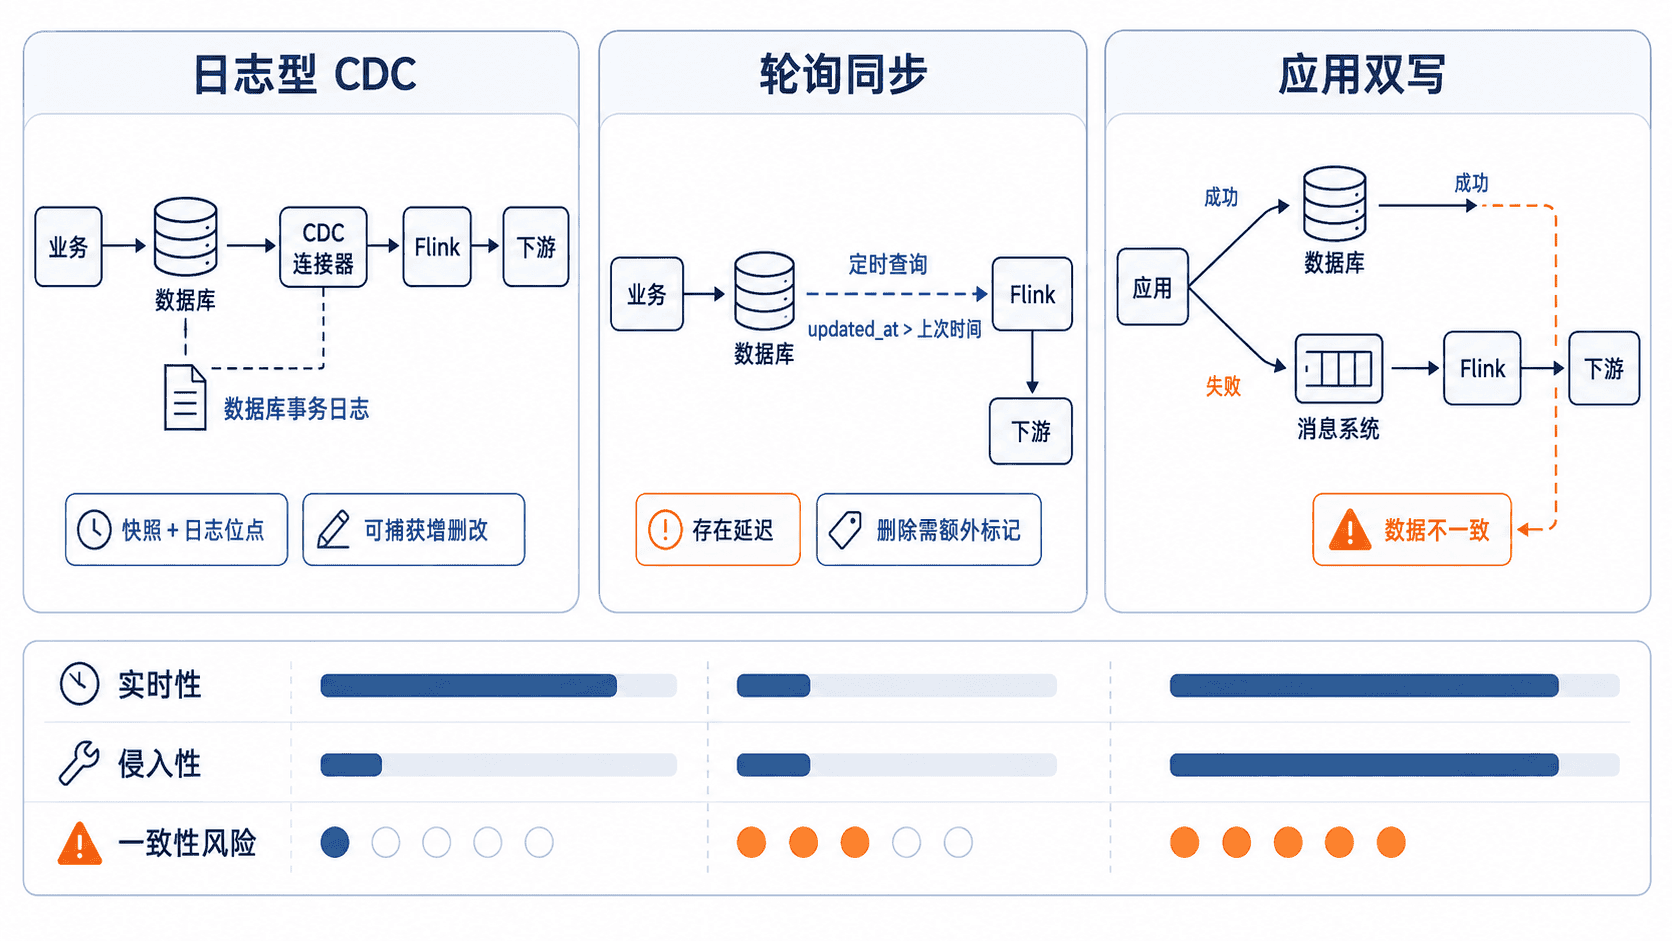
日志型 CDC 如何工作
以关系型数据库为例,事务提交时会生成有序的变更日志。CDC 连接器解析日志,将 INSERT、UPDATE、DELETE 转换为变更事件,并保存当前读取位置。任务失败后可从已确认的位置继续读取,因此不会依赖业务表中的更新时间字段。
首次启动通常包含两个阶段:先按主键范围读取一致性快照,再消费快照期间及之后产生的日志。增量快照会把大表拆成多个块并行读取,同时利用日志事件修正快照期间发生的修改,从而减少长时间锁表和单线程全表扫描。
日志型方案的优势是延迟低、能捕获删除、对业务代码侵入小。代价是需要数据库日志权限、日志保留时间和连接器兼容性;如果日志被清理而任务仍停留在旧位点,只能重新做快照或从其他备份恢复。
三种方案的本质差异
| 方案 | 捕获位置 | 主要优点 | 关键风险 |
|---|---|---|---|
| 日志型 CDC | 数据库事务日志 | 低延迟,可捕获增删改,业务无须双写 | 依赖日志权限、保留周期和格式兼容 |
| 轮询型同步 | 业务表查询 | 实现简单,适合低频小表 | 延迟较高,删除难捕获,时间字段可能漏读 |
| 应用双写 | 业务代码写两个系统 | 事件结构可由业务直接定义 | 两次写入难以原子提交,失败补偿复杂 |
轮询常使用 updated_at > 上次时间 作为条件,但相同时间戳、时钟精度、事务提交顺序和回填数据都可能造成漏读。更稳妥的做法是使用单调递增游标,并为删除增加软删除标记,但它仍不能天然还原完整事务顺序。
双写把变化捕获放进业务应用:一次请求同时写数据库和消息系统。只要两次写不在同一原子事务内,就会出现数据库成功而消息失败,或消息成功而数据库回滚。生产系统通常使用事务消息、Outbox 表加 CDC 等方式缩小这个一致性缺口,而不是直接裸双写。
变更事件进入 Flink 后
Flink 接收到的 CDC 流不仅包含新增记录,还可能包含更新前、更新后和删除。下游若是支持主键更新的数据库或表格式,可以按主键应用变更;若下游只是追加文件或普通消息队列,则必须明确如何表达撤回与删除,否则最终结果会不断累积旧版本。
检查点保存的是 Flink 已处理到的位置及算子状态,但端到端一致性还取决于 Source 位点提交方式和 Sink 的提交语义。Source 能恢复并不代表下游一定没有重复,目标端仍需幂等主键、事务提交或去重逻辑。
方案选择
需要秒级同步、完整捕获删除并且数据库开放日志权限时,优先使用日志型 CDC。数据量小、允许分钟级延迟且无法读取日志时,可使用轮询,但必须设计可靠游标和删除标记。只有业务事件本身比数据库行变化更重要时,才考虑由应用直接发布事件,并配合 Outbox 或事务消息保证一致性。