
大数据与流处理 / 系统课时
处理数据倾斜
处理数据倾斜
本课解决“整体资源充足,但少数 Subtask 长期满载”的问题。你将学会区分数据倾斜与普通容量不足,定位热点 Key,并通过本地预聚合、拆分键和两阶段聚合分散负载,同时避免重复计数与状态膨胀。
学习目标
- 根据 Subtask 指标和 Key 频率识别数据倾斜
- 理解预聚合、加盐拆分和分层聚合的适用条件
- 使用 Flink SQL 完成可验证的两阶段热点 Key 聚合
先确认是否真的倾斜
数据倾斜的典型特征是:同一算子只有少数 Subtask 的 busy、背压、输入记录数或状态大小显著高于其他实例,而其余 Subtask 长期空闲。若所有 Subtask 都接近满载,更可能是整体并行度不足或单条记录处理成本过高。
定位时先比较同一算子的 Subtask 指标,再从业务字段统计 Key 频率。热点可能来自固定大客户、默认值、空值归一化、异常设备或时间窗口内的突发事件。只看平均吞吐会掩盖这种局部失衡。
选择合适的缓解方式
本地预聚合适合可结合的统计,例如计数、求和、最小值和最大值。它先在上游减少记录数量,再执行网络 Shuffle,可以直接降低热点 Key 的传输压力。
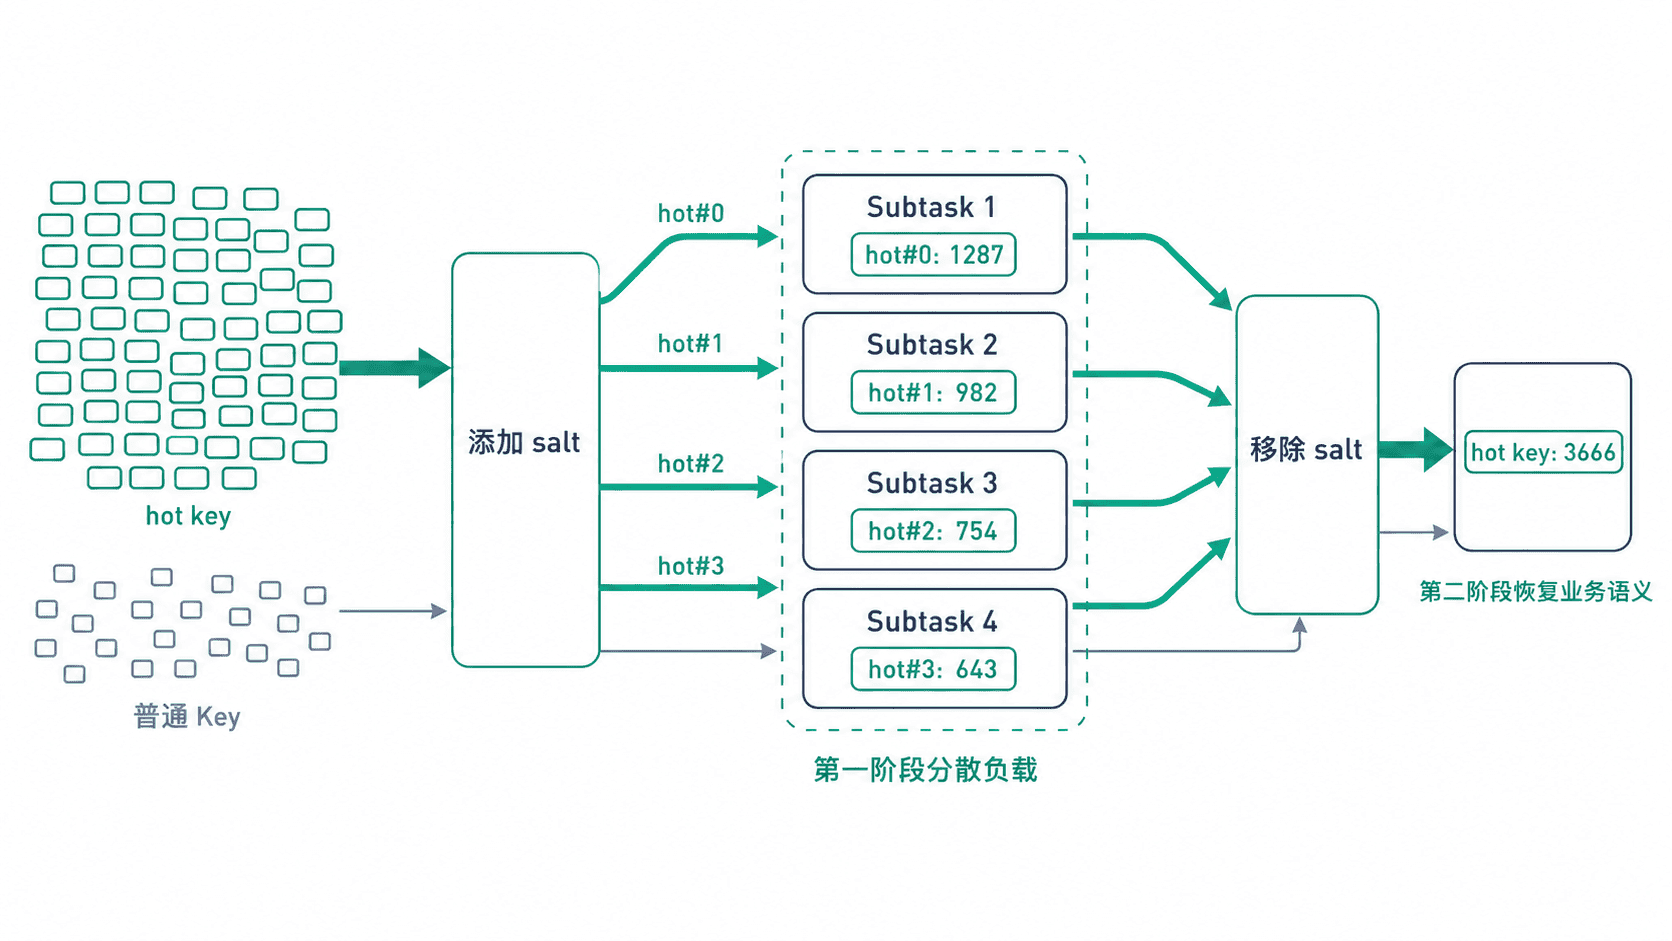
拆分键也称加盐。做法是在原始 Key 后附加有限范围的 salt,把一个热点 Key 分散到多个逻辑分区。第一阶段按“原始 Key + salt”聚合,第二阶段移除 salt 后按原始 Key 合并结果。
分层聚合适合超大热点或多级拓扑。可以先在 Source 邻近位置聚合,再在区域层、全局层继续合并。层级越多,网络流量越小,但状态、延迟和实现复杂度也会增加。
两阶段聚合主示例
下面的 Java 程序在批模式下创建 8 条事件,其中 hot 出现 6 次。SQL 先按 user_key 和 4 个 salt 桶聚合,再按原始 user_key 汇总,最终结果与直接聚合一致,但第一阶段可以把热点分散到多个分区。
import org.apache.flink.table.api.DataTypes;
import org.apache.flink.table.api.EnvironmentSettings;
import org.apache.flink.table.api.Table;
import org.apache.flink.table.api.TableEnvironment;
import org.apache.flink.types.Row;

import java.util.List;

public class HotKeyTwoStageAggregation {
    public static void main(String[] args) {
        EnvironmentSettings settings = EnvironmentSettings.inBatchMode();
        TableEnvironment tableEnv = TableEnvironment.create(settings);

        List<Row> rows = List.of(
                Row.of(1, "hot"),
                Row.of(2, "hot"),
                Row.of(3, "hot"),
                Row.of(4, "hot"),
                Row.of(5, "hot"),
                Row.of(6, "hot"),
                Row.of(7, "cold-a"),
                Row.of(8, "cold-b")
        );

        Table events = tableEnv.fromValues(
                DataTypes.ROW(
                        DataTypes.FIELD("event_id", DataTypes.INT()),
                        DataTypes.FIELD("user_key", DataTypes.STRING())
                ),
                rows.toArray()
        );
        tableEnv.createTemporaryView("events", events);

        Table result = tableEnv.sqlQuery(
                "WITH partial AS (" +
                "  SELECT user_key, MOD(event_id, 4) AS salt, COUNT(*) AS partial_count" +
                "  FROM events" +
                "  GROUP BY user_key, MOD(event_id, 4)" +
                ")" +
                " SELECT user_key, SUM(partial_count) AS total_count" +
                " FROM partial" +
                " GROUP BY user_key"
        );

        result.execute().print();
    }
}
预期结果:
user_key | total_count
hot      | 6
cold-a   | 1
cold-b   | 1
结果行顺序可能不同。示例中的 event_id 用于稳定地产生 salt;生产环境可以使用事件 ID、订单 ID 或其他分布较均匀的字段。若直接对随机数取 salt,重放时分区可能变化,但只要最终按原始 Key 合并,普通计数语义仍可保持正确。
关键边界与常见错误
salt 桶数量不是越大越好。桶太少无法摊平热点,桶太多会增加第一阶段状态、第二次 Shuffle 和聚合开销。通常先根据热点 Key 的吞吐与目标单 Subtask 容量估算,再通过压测调整。
连续流中不能把“不断更新的局部累计值”直接当增量再次求和,否则同一局部结果的 1、2、3 等更新可能被重复累计。应使用窗口终值、支持更新语义的 Table/SQL 聚合,或设计带撤回、Upsert 的结果协议。
拆分键只适用于允许二次合并的计算。精确去重、Top N、复杂会话窗口或顺序敏感逻辑,需要额外保存集合、排序状态或业务约束,不能简单套用求和方案。
验证调优结果
调整后要比较同一算子各 Subtask 的输入记录数、busy 时间、背压时间和状态大小。理想结果是最大值与中位数差距明显缩小,同时总吞吐上升、端到端延迟下降,且最终聚合结果与基准结果一致。
还要检查第二阶段是否成为新热点。若所有拆分结果最终仍集中到一个全局 Key,可以增加聚合层级、缩短窗口、使用近似算法,或从业务上拆分统计口径。