
大数据与流处理 / 系统课时
全量窗口函数
全量窗口函数
本课使用 ProcessWindowFunction 在窗口触发时读取全部订单事件,同时取得窗口边界并计算中位数。完成后,你能判断哪些需求必须查看完整窗口数据,以及如何避免由此带来的状态膨胀。
学习目标
- 理解全量窗口函数的触发与数据访问方式
- 能从上下文读取窗口起止时间
- 能评估完整缓存窗口数据的内存代价
全量计算何时必要
ProcessWindowFunction 会在窗口触发时接收当前 key、窗口上下文和窗口内元素迭代器。它既能访问全部数据,也能读取窗口边界、当前水位线以及窗口状态,适合中位数、排序、Top N、首尾事件对比等无法仅靠固定大小累加器完成的需求。
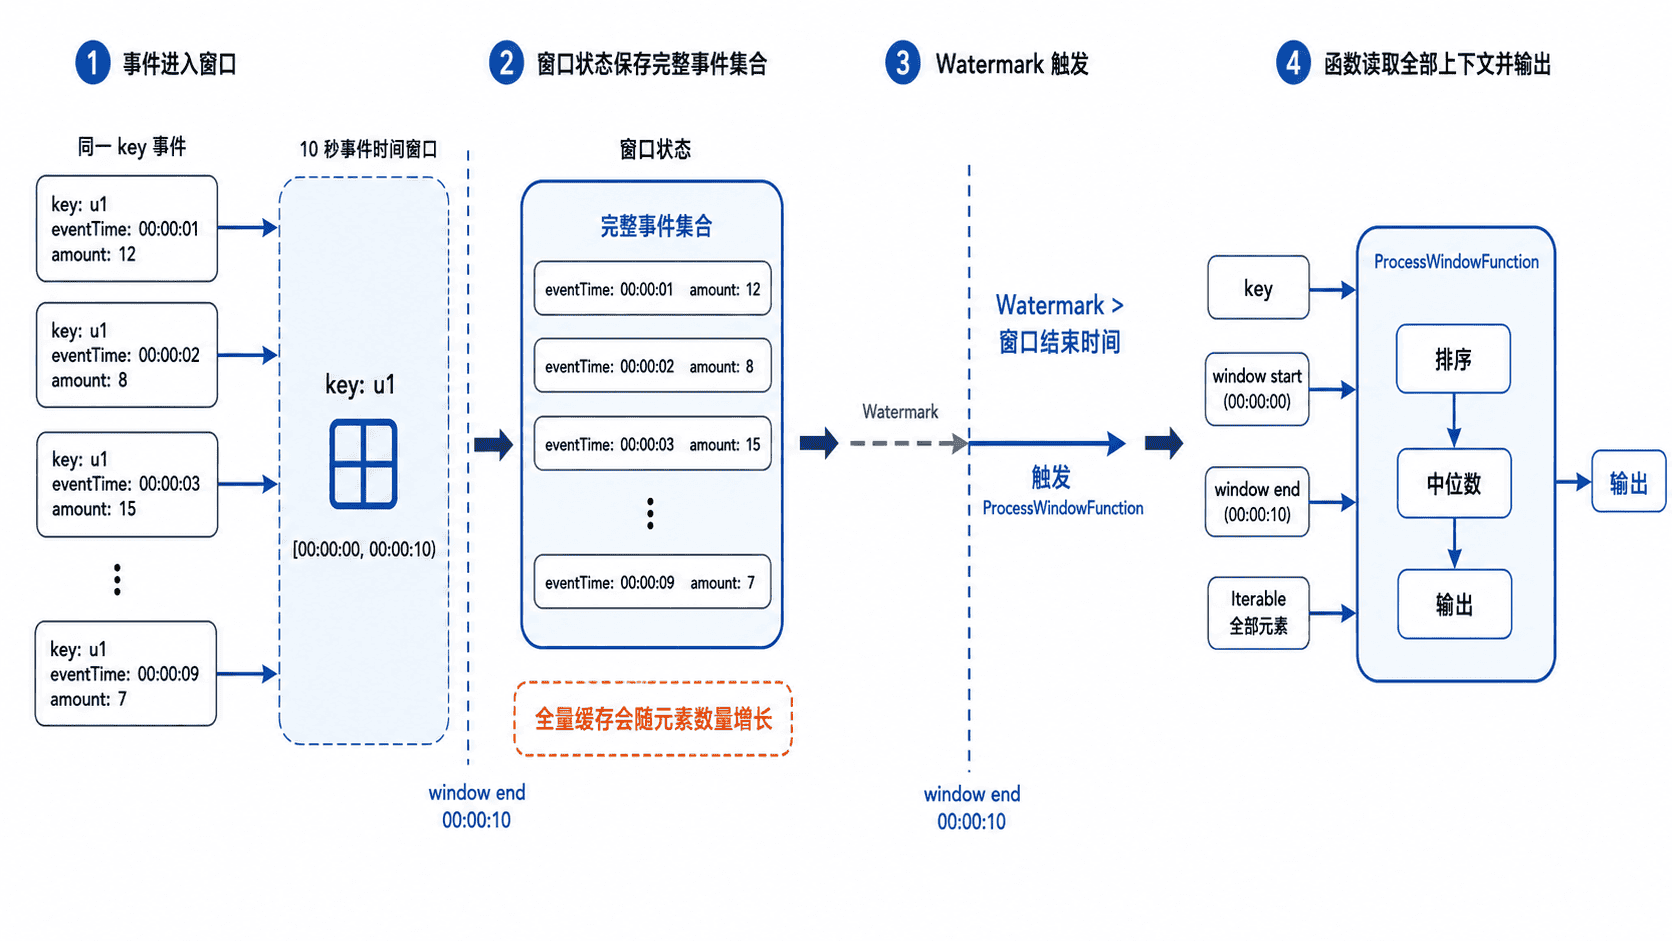
它与增量函数最大的区别是状态形态:增量函数通常只保留一个归约值或累加器,而全量函数需要保存窗口内全部元素,固定 key-window 的空间复杂度约为 。窗口越长、流量越大或允许迟到时间越久,内存与状态后端压力越明显。
完整示例
下面按用户划分 10 秒滚动窗口,在 process() 中复制并排序金额列表,计算每个窗口的事件数、总金额和中位数。中位数需要观察排序后的完整数据,因此能体现全量窗口函数的使用价值。
import org.apache.flink.api.common.eventtime.WatermarkStrategy;
import org.apache.flink.streaming.api.datastream.DataStream;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.streaming.api.functions.windowing.ProcessWindowFunction;
import org.apache.flink.streaming.api.windowing.assigners.TumblingEventTimeWindows;
import org.apache.flink.streaming.api.windowing.windows.TimeWindow;
import org.apache.flink.util.Collector;

import java.time.Duration;
import java.util.ArrayList;
import java.util.Collections;
import java.util.List;
import java.util.Locale;

public class FullWindowFunctionDemo {

    public static class OrderEvent {
        public String userId;
        public long amount;
        public long eventTime;

        public OrderEvent() {
        }

        public OrderEvent(String userId, long amount, long eventTime) {
            this.userId = userId;
            this.amount = amount;
            this.eventTime = eventTime;
        }
    }

    public static class WindowStatistics
            extends ProcessWindowFunction<
                    OrderEvent,
                    String,
                    String,
                    TimeWindow> {

        @Override
        public void process(
                String key,
                Context context,
                Iterable<OrderEvent> elements,
                Collector<String> out) {

            List<Long> amounts = new ArrayList<>();
            long total = 0L;

            // elements 包含当前 key-window 的全部事件。
            for (OrderEvent event : elements) {
                amounts.add(event.amount);
                total += event.amount;
            }

            Collections.sort(amounts);
            double median = calculateMedian(amounts);

            out.collect(String.format(
                    Locale.ROOT,
                    "user=%s, window=[%d,%d), count=%d, total=%d, median=%.1f",
                    key,
                    context.window().getStart(),
                    context.window().getEnd(),
                    amounts.size(),
                    total,
                    median));
        }

        private static double calculateMedian(List<Long> sortedAmounts) {
            int size = sortedAmounts.size();
            int middle = size / 2;

            if (size % 2 == 1) {
                return sortedAmounts.get(middle);
            }

            // 偶数个元素时取中间两个值的平均数。
            return (sortedAmounts.get(middle - 1)
                    + sortedAmounts.get(middle)) / 2.0;
        }
    }

    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env =
                StreamExecutionEnvironment.getExecutionEnvironment();
        env.setParallelism(1);

        DataStream<OrderEvent> events = env
                .fromElements(
                        new OrderEvent("alice", 20L, 1_000L),
                        new OrderEvent("bob", 10L, 2_000L),
                        new OrderEvent("alice", 30L, 4_000L),
                        new OrderEvent("bob", 50L, 9_000L),
                        new OrderEvent("alice", 40L, 12_000L))
                .assignTimestampsAndWatermarks(
                        WatermarkStrategy
                                .<OrderEvent>forMonotonousTimestamps()
                                .withTimestampAssigner(
                                        (event, previousTimestamp) ->
                                                event.eventTime));

        events
                .keyBy(event -> event.userId)
                .window(TumblingEventTimeWindows.of(Duration.ofSeconds(10)))
                .process(new WindowStatistics())
                .print("process-window");

        env.execute("full-window-function-demo");
    }
}
预期输出如下;不同 key 的输出顺序可能变化。
process-window> user=alice, window=[0,10000), count=2, total=50, median=25.0
process-window> user=bob, window=[0,10000), count=2, total=60, median=30.0
process-window> user=alice, window=[10000,20000), count=1, total=40, median=40.0
context.window().getStart() 和 getEnd() 返回毫秒时间戳,窗口采用左闭右开区间。事件时间等于 10000 的数据会进入 [10000, 20000),不会进入前一个窗口。
上下文与状态边界
窗口上下文提供 window()、currentWatermark()、windowState() 和 globalState() 等能力。windowState() 的生命周期跟随当前窗口,窗口清理后相应状态会被删除;globalState() 面向当前 key,可跨多个窗口存在,因此必须自行设计清理策略。
Iterable<OrderEvent> 不应被长期保存到成员变量或外部容器。它只用于本次调用期间遍历;若确实需要排序,应像示例一样复制所需字段,并控制窗口大小和最大元素数。
成本与优化策略
全量窗口的状态量会随元素数增加。高吞吐场景中,大窗口、热点 key 和较长允许迟到时间叠加后,可能造成 checkpoint 变大、反压加重,甚至状态后端内存不足。应先缩短窗口、拆分热点 key 或限制单窗口数据量。
若需求只需总和、计数、平均值、最大值等可增量指标,不应使用纯 ProcessWindowFunction。如果既要低状态开销又要窗口边界,可以组合 AggregateFunction 与 ProcessWindowFunction:前者先把窗口压缩成一个结果,后者只读取该结果和上下文。