
大数据与流处理 / 系统课时
构建多表同步管道
构建多表同步管道
本课把单表 CDC 扩展为可维护的多表同步管道:一次捕获订单、订单明细和客户表,分别执行字段转换,再通过路由规则写入不同 Kafka 主题,并用清晰的验收步骤防止漏表、错投和错误合并。
学习目标
- 设计多表捕获范围与排除规则
- 为不同表配置独立的转换和过滤逻辑
- 区分路由合并与仅分发到不同主题的映射方式
先设计表级规则
多表管道至少要回答四个问题:哪些表被捕获、每张表保留哪些字段、逻辑表名如何变化、最终进入哪个主题。Flink CDC Pipeline 的必需部分是 source、sink 和 pipeline,transform 与 route 用于扩展转换和路由。:contentReference[oaicite:3]{index=3}
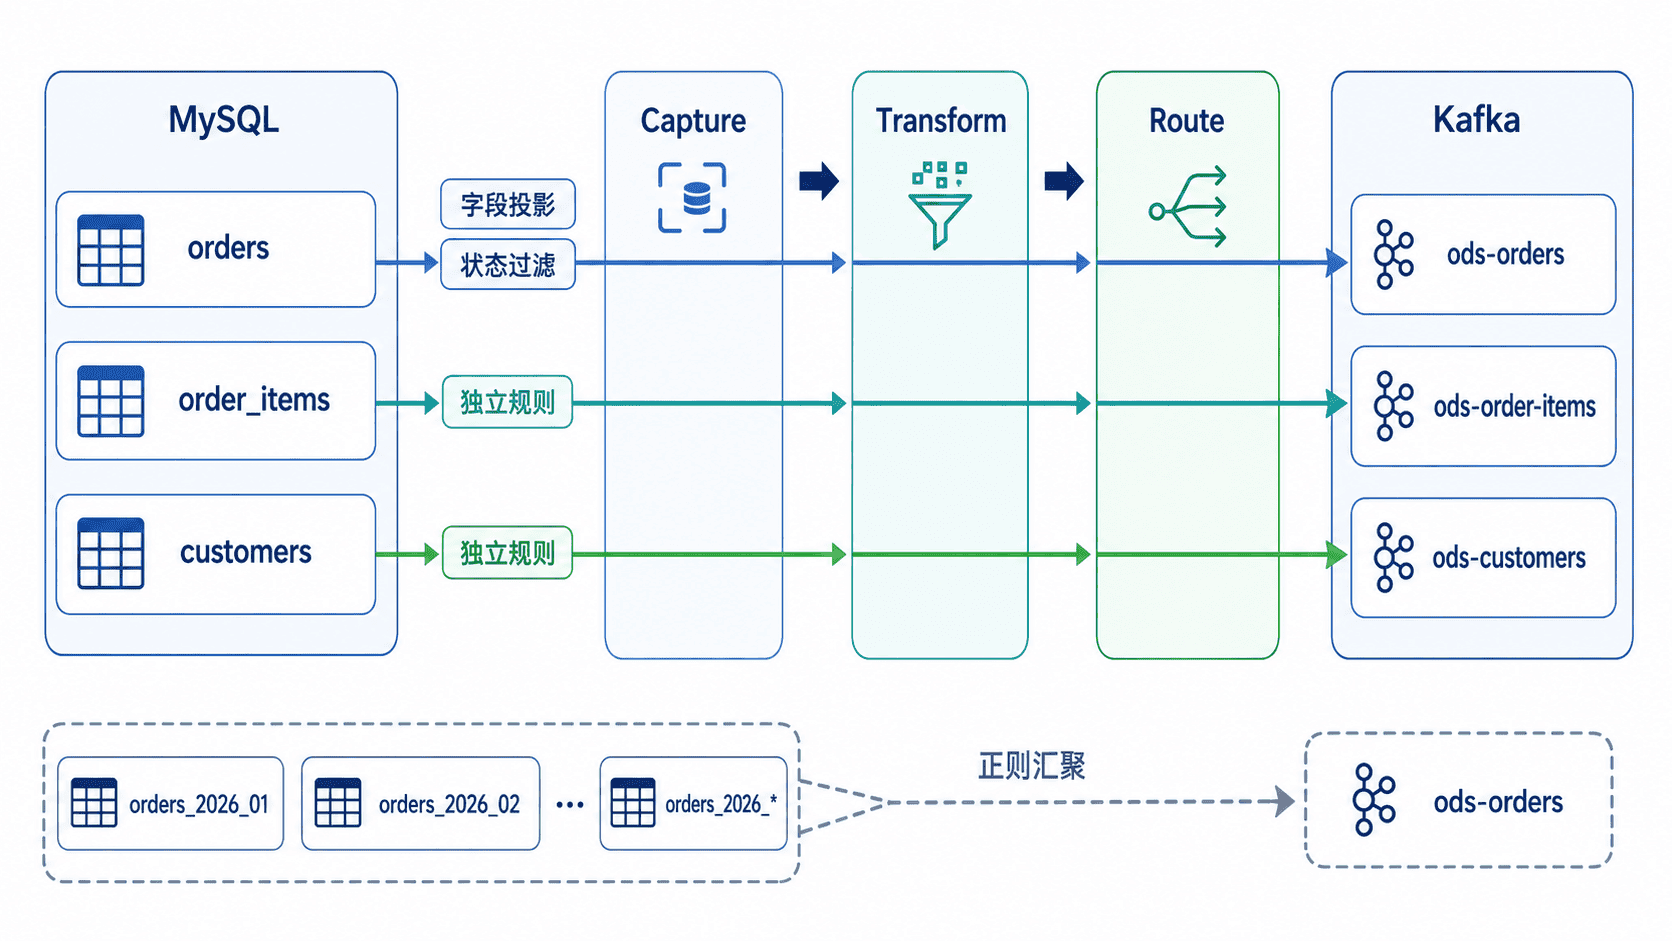
捕获范围应尽量显式。全库正则适合表结构和治理规则高度一致的场景;业务边界复杂时,建议列出表名或使用受控正则,并通过 tables.exclude 排除临时表、备份表和审计表。这样新增表不会在未经评审的情况下自动进入下游。
编写多表 Pipeline
下面的配置捕获三张表。orders 只保留核心字段,把状态转成大写,并过滤测试订单;另外两张表保持原字段。route 将源表映射成三个目标逻辑表。对 Kafka Sink 而言,这些目标名会成为对应主题。路由的 source-table 支持正则,也能把多个分表汇聚到一个目标,但汇聚前必须确认主键和字段结构可兼容。:contentReference[oaicite:4]{index=4}
source:
  type: mysql
  name: MySQL Commerce Source
  hostname: mysql
  port: 3306
  username: cdc_user
  password: cdc_password
  tables: app_db.orders, app_db.order_items, app_db.customers
  server-id: 5500-5508
  server-time-zone: UTC

transform:
  - source-table: app_db.orders
    projection: id, customer_id, amount, UPPER(status) AS status, updated_at
    filter: status <> 'TEST'
    description: normalize production orders
  - source-table: app_db.order_items
    projection: id, order_id, product_id, quantity, price
    description: keep order item business fields
  - source-table: app_db.customers
    projection: id, name, level, updated_at
    description: remove fields not needed downstream

route:
  - source-table: app_db.orders
    sink-table: ods-orders
  - source-table: app_db.order_items
    sink-table: ods-order-items
  - source-table: app_db.customers
    sink-table: ods-customers

sink:
  type: kafka
  name: Kafka Multi-table Sink
  properties.bootstrap.servers: kafka:9092
  value.format: debezium-json
  partition.strategy: hash-by-key

pipeline:
  name: Commerce Multi-table CDC
  parallelism: 3
这是完整的声明式配置,生效后应产生三个目标主题。转换规则按 source-table 匹配;没有匹配转换规则的表仍会按原结构继续流转。过滤条件会丢弃不满足条件的数据事件,因此上线前必须用样本数据核对,避免把合法业务状态误判为测试数据。
理解两种目标映射
route 会改变下游看到的逻辑表标识,并允许多个源表匹配同一目标,适合分库分表合并。Kafka Sink 还提供 sink.tableId-to-topic.mapping:它只把不同 TableId 分发到指定主题,不尝试合并源表结构,适合保留源表身份但调整主题命名。:contentReference[oaicite:5]{index=5}
| 需求 | 推荐机制 | 关键风险 |
|---|---|---|
| 表重命名或分表合并 | route |
字段类型、主键和语义必须兼容 |
| 保留表身份,仅改变 Kafka 主题 | sink.tableId-to-topic.mapping |
正则过宽可能把表投递到错误主题 |
| 字段裁剪、派生或行过滤 | transform |
过滤条件错误会造成业务数据缺失 |
同一条规则应只承担一种职责。捕获范围放在 source,字段治理放在 transform,逻辑归并放在 route,Kafka 物理主题分发才使用 TableId 映射。这样排查时可以快速判断问题发生在哪一层。
提交与验收
提交多表作业:
bash bin/flink-cdc.sh "<PATH>/commerce-multi-table.yaml"预期输出:
Pipeline has been submitted to cluster.
Job ID: <ID>
Job Description: Commerce Multi-table CDC
检查主题是否创建:
kafka-topics.sh --bootstrap-server kafka:9092 --list预期输出:
ods-customers
ods-order-items
ods-orders最后分别对三张源表执行一次插入或更新,并消费对应主题。验收必须确认订单状态已转为大写、TEST 订单未输出、订单明细没有进入客户主题,以及所有事件的 source 或目标逻辑标识符合路由设计。
上线前边界
多表作业的 server-id 范围要覆盖快照并行度且不能与其他复制客户端重叠。分表合并时,应先统一主键、字段类型和删除语义;如果下游不能承受字段变更,应明确 Schema Evolution 策略,而不是默认接受所有上游 DDL。新增表进入捕获范围前,也应同步更新数据分级、脱敏和主题权限。