
大数据与流处理 / 系统课时
表结构与数据类型
表结构与数据类型
本课解决建表时最容易混淆的四个问题:字段类型如何选择,计算列何时求值,元数据列从哪里来,以及 Flink 为什么只声明而不强制执行主键。完成后,你可以写出语义清晰且可被规划器正确解析的表结构。
学习目标
- 为常见业务字段选择合适的 Flink SQL 数据类型
- 区分物理列、计算列和元数据列
- 正确声明
PRIMARY KEY NOT ENFORCED
选择数据类型
字符串通常使用 STRING 或定长的 CHAR(n);金额、费率等需要精确计算的值应使用 DECIMAL(p, s),不要使用浮点类型代替。业务时间常用 TIMESTAMP(3),带时区语义的事件时间可使用 TIMESTAMP_LTZ(3)。
复杂数据可以使用 ARRAY、MAP 和 ROW。类型选择不仅影响存储和函数匹配,也会影响表达式推导、连接器序列化以及状态大小。字段精度应覆盖真实范围,但不必无限放大。
三类列的关系
物理列直接对应输入或输出数据中的字段;计算列由同一行其他列的表达式动态计算;元数据列来自连接器暴露的信息,例如 Kafka 的主题、分区和偏移量。主键约束描述一组唯一且非空的业务键,但 Flink 不负责在运行时检查唯一性。
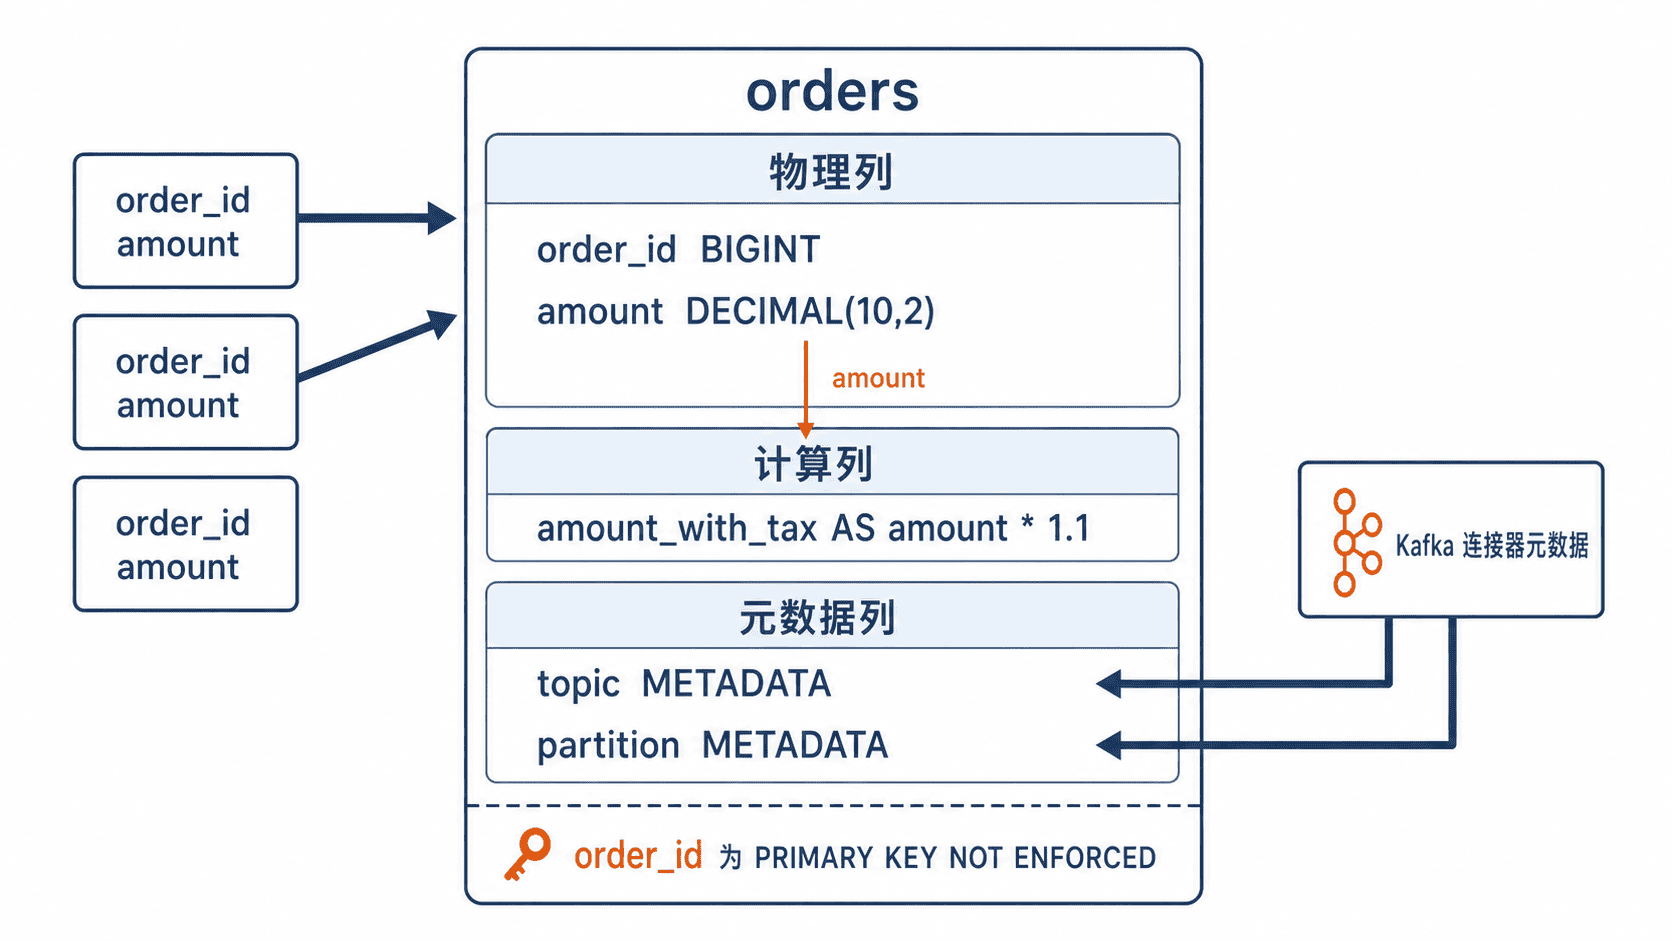
创建包含计算列和主键的表
下面的程序使用 datagen 连接器创建临时表,并通过解析后的 Schema 检查列类型和主键声明。计算列 amount_with_tax 不从数据源读取,而是在查询时根据 amount 计算。
import org.apache.flink.table.api.EnvironmentSettings;
import org.apache.flink.table.api.TableEnvironment;
import org.apache.flink.table.catalog.ResolvedSchema;

public class TableSchemaDemo {

    public static void main(String[] args) {
        TableEnvironment tableEnv = TableEnvironment.create(
                EnvironmentSettings.newInstance().inStreamingMode().build());

        tableEnv.executeSql(
                "CREATE TEMPORARY TABLE orders ("
                        + "order_id STRING NOT NULL,"
                        + "amount DECIMAL(10, 2),"
                        + "created_at TIMESTAMP(3),"
                        + "amount_with_tax AS amount * CAST(1.06 AS DECIMAL(3, 2)),"
                        + "PRIMARY KEY (order_id) NOT ENFORCED"
                        + ") WITH ("
                        + "'connector' = 'datagen',"
                        + "'rows-per-second' = '1',"
                        + "'fields.order_id.length' = '8',"
                        + "'fields.amount.min' = '1',"
                        + "'fields.amount.max' = '100'"
                        + ")");

        ResolvedSchema schema = tableEnv.from("orders").getResolvedSchema();

        schema.getColumns().forEach(column ->
                System.out.println(column.getName() + " | "
                        + column.getClass().getSimpleName()));

        schema.getPrimaryKey().ifPresent(primaryKey ->
                System.out.println("pk=" + String.join(",", primaryKey.getColumns())));
    }
}
预期输出:
order_id | PhysicalColumn
amount | PhysicalColumn
created_at | PhysicalColumn
amount_with_tax | ComputedColumn
pk=order_id
不同 Flink 版本的内部列类名展示可能略有差异,但列顺序和主键字段应保持一致。
计算列的边界
计算列使用 AS 表达式 声明,不占用源数据字段。它可以参与过滤、聚合和下游写入,但表达式必须能由规划器解析。修改依赖列的类型后,要重新检查计算结果的精度和空值传播。
计算列通常不能作为连接器直接读取的物理字段。若表达式包含非确定性函数,同一行在不同阶段重新计算时可能得到不同结果,因此关键业务值更适合在上游固化。
元数据列
元数据列依赖连接器能力,不能假设所有连接器都支持。下面是 Kafka 表的片段示例,需要 Kafka 连接器依赖、可访问的集群和真实主题才能执行。
CREATE TABLE kafka_orders (
  order_id STRING,
  amount DECIMAL(10, 2),
  kafka_topic STRING METADATA FROM 'topic' VIRTUAL,
  kafka_partition INT METADATA FROM 'partition' VIRTUAL,
  kafka_offset BIGINT METADATA FROM 'offset' VIRTUAL
) WITH (
  'connector' = 'kafka',
  'topic' = 'orders',
  'properties.bootstrap.servers' = '<HOST>:<PORT>',
  'format' = 'json'
);
VIRTUAL 表示该列用于读取或查询,但写出数据时不会作为普通字段传给连接器。验证时可执行 DESCRIBE kafka_orders,并对照所用 Kafka 连接器版本支持的 metadata key。
主键声明
Flink SQL 的主键必须由非空列组成,因此示例中的 order_id 声明为 NOT NULL。约束后必须写 NOT ENFORCED,表示规划器相信上游数据满足唯一性,但运行时不会主动检查重复值。
主键会影响更新流语义、优化计划以及 Upsert 连接器的键选择。若上游实际产生重复主键,结果可能被覆盖或出现错误更新,因此唯一性必须由业务系统、CDC 来源或预处理逻辑保证。