
NoSQL 与搜索 / 系统课时
压测、调优与故障演练
压测、调优与故障演练
本课建立一套可重复的搜索验收流程:用读写压测量化吞吐和延迟,用固定测试集检查结果相关性,再按监控证据调优,并在隔离环境中验证节点故障后的恢复能力。
学习目标
- 设计可复现的搜索读写压测与验收指标
- 使用固定测试集检测相关性回退
- 按监控证据调优并完成节点故障演练
先定义可验收的指标
压测前先冻结索引版本、数据量、查询集合和机器规格,否则不同轮次无法比较。性能指标至少包括吞吐量、p95 延迟、错误率和资源利用率;质量指标至少包括核心查询命中率、零结果率和人工确认的前几名结果。
不要一开始就追求极限 QPS。先用接近日常流量的基线场景验证稳定性,再逐步提高并发,直到延迟或错误率越过目标。每轮只改变一个变量,例如分片数、刷新间隔或查询结构,才能判断收益来自哪里。
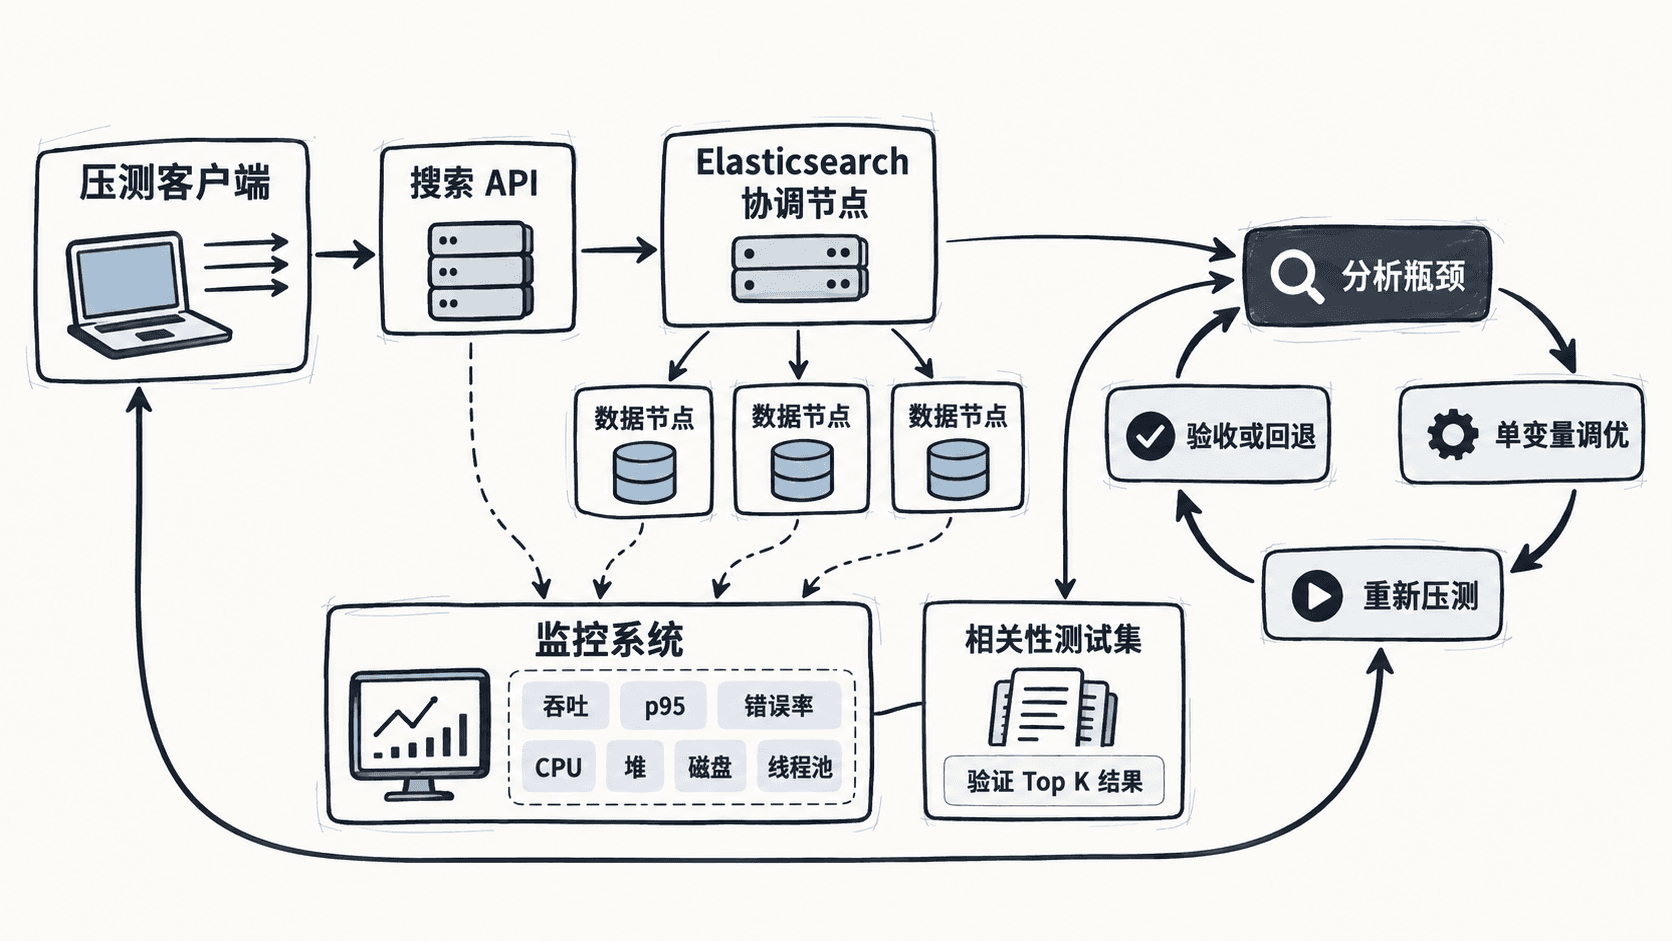
执行读写压测
读压测应覆盖真实关键词分布、分页大小和筛选条件。下面的完整 Bash 示例会生成 k6 脚本并对 POST /api/search 执行阶梯式压测。运行前需安装 k6,并把 BASE_URL 改为隔离测试环境地址。
#!/usr/bin/env bash
set -euo pipefail

cat > /tmp/search-test.js <<'EOF'
import http from 'k6/http';
import { check, sleep } from 'k6';
import { Trend } from 'k6/metrics';

// 单独记录业务搜索耗时,便于与通用 HTTP 指标对照
const searchLatency = new Trend('search_latency');

export const options = {
  // 逐步升压可以观察系统从稳定到越过阈值的拐点
  stages: [
    { duration: '30s', target: 20 },
    { duration: '60s', target: 50 },
    { duration: '30s', target: 0 },
  ],
  thresholds: {
    http_req_failed: ['rate<0.01'],
    http_req_duration: ['p(95)<300'],
    search_latency: ['p(95)<300'],
  },
};

const baseUrl = __ENV.BASE_URL || 'http://localhost:8080';

export default function () {
  // 所有虚拟用户使用同一请求结构,保证不同轮次可比较
  const response = http.post(
    `${baseUrl}/api/search`,
    JSON.stringify({ keyword: '无线鼠标', page: 1, size: 20 }),
    { headers: { 'Content-Type': 'application/json' } },
  );

  searchLatency.add(response.timings.duration);
  check(response, {
    'status is 200': (r) => r.status === 200,
    'response has body': (r) => Boolean(r.body),
  });
  sleep(0.2);
}
EOF

BASE_URL="http://<HOST>:<PORT>" k6 run /tmp/search-test.js
预期输出
checks.........................: <PASS_RATE>% ✓ <PASS_COUNT> ✗ <FAIL_COUNT>
http_req_failed................: <ERROR_RATE>%
http_req_duration..............: avg=<AVG_MS> p(95)=<P95_MS>
search_latency.................: avg=<AVG_MS> p(95)=<P95_MS><HOST>、<PORT> 和各项数值由实际环境决定。若阈值失败,k6 会以非零状态退出,可直接作为发布门禁。
写压测必须使用独立索引和可清理数据。下面生成 1000 条商品并通过 Bulk API 写入,随后输出是否存在单条失败以及总耗时。
#!/usr/bin/env bash
set -euo pipefail

ES_URL="${ES_URL:-http://localhost:9200}"
INDEX_NAME="products_write_pressure"

# 每轮重建独立索引,避免历史数据影响写入结果
curl -sS -w '\n' -X DELETE "${ES_URL}/${INDEX_NAME}" >/dev/null || true
curl -sS -w '\n' -X PUT "${ES_URL}/${INDEX_NAME}"   -H 'Content-Type: application/json'   -d '{"settings":{"index":{"number_of_replicas":0,"refresh_interval":"30s"}}}' >/dev/null

# 生成固定规模的 NDJSON,便于多轮测试横向比较
python3 - <<'PY' > /tmp/products-write.ndjson
import json

for product_id in range(1, 1001):
    print(json.dumps({"index": {"_index": "products_write_pressure", "_id": product_id}}))
    print(json.dumps({
        "name": f"压测商品-{product_id}",
        "category": "pressure-test",
        "price": product_id / 10
    }, ensure_ascii=False))
PY

# 计时范围只覆盖 Bulk 请求,不包含测试数据生成
start_ms=$(date +%s%3N)
response=$(curl -sS -w '\n' -X POST "${ES_URL}/_bulk"   -H 'Content-Type: application/x-ndjson'   --data-binary @/tmp/products-write.ndjson)
end_ms=$(date +%s%3N)

# HTTP 200 不代表每个文档都成功,必须读取 errors 字段
errors=$(printf '%s' "${response}" | python3 -c   'import json,sys; print(str(json.load(sys.stdin)["errors"]).lower())')
printf 'errors=%s documents=1000 duration_ms=%s\n'   "${errors}" "$((end_ms - start_ms))"
预期输出
errors=false documents=1000 duration_ms=<TIME><TIME> 取决于节点规格、网络和磁盘。若 errors=true,应检查 Bulk 响应中失败的 items,不能只依据 HTTP 状态码判断写入成功。完成后删除测试索引,避免压测数据占用磁盘。
检查搜索相关性
性能达标不代表结果正确。应维护固定查询及其期望商品,把它作为每次索引发布和调优后的回归测试。下面的完整示例检查期望商品是否出现在前五条结果中。
#!/usr/bin/env bash
set -euo pipefail

python3 -m pip install requests >/dev/null

cat > /tmp/relevance_test.py <<'PY'
import os
import sys
import requests

base_url = os.getenv("BASE_URL", "http://localhost:8080")
# 固定测试集应进入版本控制,避免临时修改期望结果
cases = [
    {"keyword": "无线鼠标", "expectedId": "1002"},
    {"keyword": "机械键盘", "expectedId": "1001"},
]

failed = 0

for case in cases:
    # 使用与线上相同的搜索接口,而不是直接绕过应用查询 ES
    response = requests.post(
        f"{base_url}/api/search",
        json={"keyword": case["keyword"], "page": 1, "size": 5},
        timeout=5,
    )
    response.raise_for_status()

    # 这里只检查 Hit@5;需要排序质量时可扩展为 MRR 或 NDCG
    product_ids = [str(item["id"]) for item in response.json()["items"]]
    passed = case["expectedId"] in product_ids
    print(f'{case["keyword"]}: {"PASS" if passed else "FAIL"}')
    failed += 0 if passed else 1

print(f"summary: {len(cases) - failed}/{len(cases)} passed")
sys.exit(1 if failed else 0)
PY

BASE_URL="http://<HOST>:<PORT>" python3 /tmp/relevance_test.py
预期输出
无线鼠标: PASS
机械键盘: PASS
summary: 2/2 passed
如果接口字段不是 items[].id,应按实际响应修改解析逻辑。测试集应覆盖品牌词、类目词、型号词、同义词、错别字和无结果查询,避免只验证最容易命中的样例。
按证据定位并调优
先判断瓶颈位于应用、网络还是 Elasticsearch。应用线程池耗尽时,增加分片通常无效;数据节点 CPU 高且查询线程池排队时,应先检查查询复杂度和分片数量;磁盘延迟高时,应检查段合并、刷新频率和存储性能。
常见调优顺序是:删除不必要的聚合与高亮、限制返回字段、避免深分页、修正分片数量、在批量写入阶段临时调大 refresh_interval,稳定后再恢复。每项改动都要用同一脚本复测,并记录吞吐、p95、错误率和相关性结果。
下面的配置片段依赖目标索引已经存在,只用于展示批量导入前后如何调整刷新间隔。
ES_URL="${ES_URL:-http://localhost:9200}"
INDEX_NAME="products_v20260803"

# 批量写入前降低刷新频率,减少小段生成
curl -sS -w '\n' -X PUT "${ES_URL}/${INDEX_NAME}/_settings"   -H 'Content-Type: application/json'   -d '{"index":{"refresh_interval":"30s"}}'

# 导入完成后恢复查询侧需要的近实时可见性
curl -sS -w '\n' -X PUT "${ES_URL}/${INDEX_NAME}/_settings"   -H 'Content-Type: application/json'   -d '{"index":{"refresh_interval":"1s"}}'
预期输出
{"acknowledged":true}
{"acknowledged":true}
第一条命令降低批量导入期间的刷新频率,第二条恢复近实时可见性。具体值必须结合写入量、搜索实时性和磁盘能力复测,不能机械套用。
演练节点故障与恢复
故障演练必须在隔离测试集群中进行,并提前确认副本数大于零。下面假设节点运行在名为 es-data-2 的 Docker 容器中:先记录健康状态,再停止节点;同时在另一个终端持续运行前面的读压测,最后启动节点并等待恢复。
#!/usr/bin/env bash
set -euo pipefail

ES_URL="${ES_URL:-http://localhost:9200}"
FAILED_NODE="es-data-2"

# 故障前记录基线,停止一个数据节点后观察副本接管
curl -sS -w '\n' "${ES_URL}/_cluster/health?pretty"
docker stop "${FAILED_NODE}"
curl -sS -w '\n' "${ES_URL}/_cluster/health?wait_for_status=yellow&timeout=60s&pretty"
# 节点恢复后等待分片重新分配完成
docker start "${FAILED_NODE}"
curl -sS -w '\n' "${ES_URL}/_cluster/health?wait_for_status=green&timeout=120s&pretty"
预期输出
{
  "cluster_name" : "<CLUSTER_NAME>",
  "status" : "green",
  <OTHER_FIELDS>
}
es-data-2
{
  "status" : "<STATUS_AFTER_FAILURE>",
  "timed_out" : false,
  <OTHER_FIELDS>
}
es-data-2
{
  "status" : "green",
  "timed_out" : false,
  <OTHER_FIELDS>
}
<STATUS_AFTER_FAILURE> 可能是 green 或 yellow,取决于副本位置和重新分配速度。演练期间应持续执行核心查询,并记录错误率和恢复时间;若出现 red,优先检查是否存在没有可用副本的主分片。
验收与留档
一次完整验收应保存测试脚本、索引版本、数据量、集群规格、参数变更、性能结果、相关性结果和故障恢复时间。只有所有门槛同时通过,才能把调优配置和索引版本发布到生产。
不要只保留“最快的一轮”。基线、变更项、结果和结论应成组记录,失败结果同样有价值,因为它能阻止团队重复尝试无效方案。
本课总结
- 压测必须固定环境和查询集,并同时观察吞吐、延迟、错误率与资源指标
- 任何性能调优都要通过相关性回归,防止速度提升却损害搜索质量
- 节点故障演练应在有副本的隔离集群中执行,并量化恢复过程
下一课预告
下一课可以把索引发布、性能门禁、相关性回归和故障验收串成自动化流水线,让商品搜索系统具备持续交付能力。