
NoSQL 与搜索 / 系统课时
节点角色规划
节点角色规划
本课解决 Elasticsearch 集群“哪些节点负责什么”的规划问题。你将能区分主节点、数据节点、预处理节点和协调节点,并根据集群规模设计一个既避免角色争抢资源、又不过度拆分的最小可用布局。
学习目标
- 说清四类节点职责及其资源特点
- 为小型、中型和大型集群选择合理布局
- 使用节点接口核对实际角色是否符合规划
四类节点分别负责什么
主节点候选节点参与选主并维护集群状态,包括索引元数据、分片分配和节点变更。真正执行这些管理动作的是当前当选的主节点,因此生产环境通常准备 3 个主节点候选节点,避免只有 2 个节点时出现多数派不足或维护困难。
数据节点保存分片并执行文档写入、查询、聚合和合并段。它通常最消耗磁盘、文件缓存、CPU 和堆内存,是容量规划的核心。数据量增长时,优先横向扩展数据节点,而不是让主节点承担更多业务请求。
预处理节点执行 ingest pipeline,例如字段重命名、日期解析和内容清洗。只有写入链路确实使用 pipeline,且处理逻辑明显消耗 CPU 时,才值得拆成专用预处理节点。
所有节点默认都能接收请求并完成协调工作。所谓专用协调节点并不是一个独立角色,而是把 node.roles 设为空,使它只负责解析请求、向相关分片分发任务、汇总结果并返回客户端。
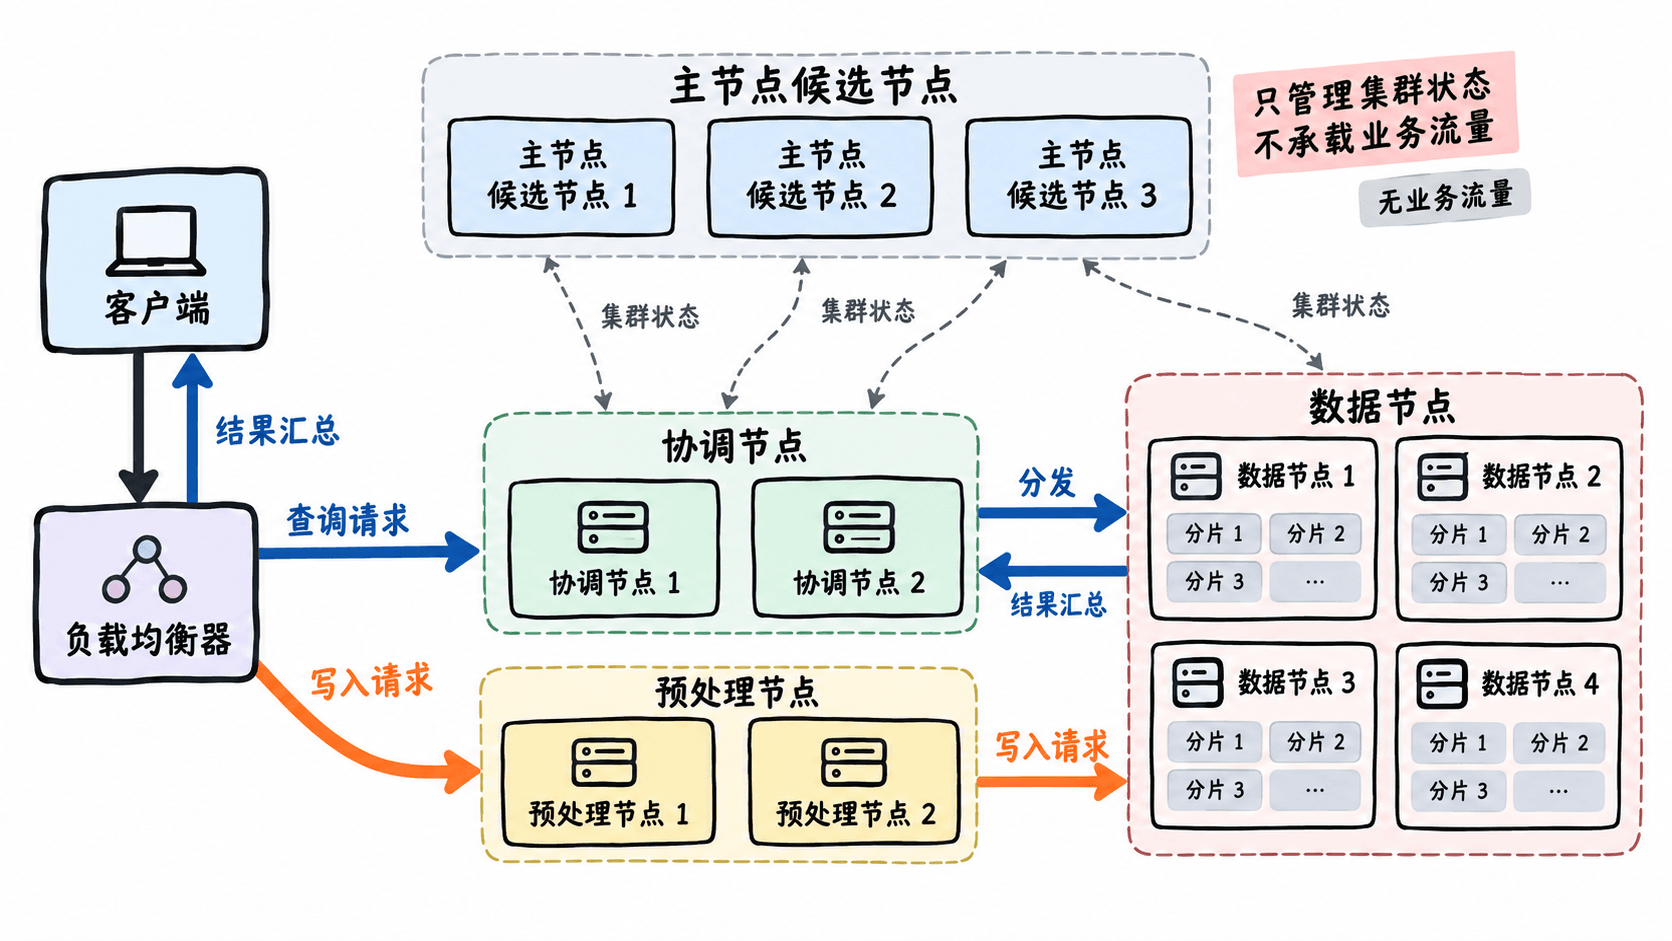
按集群规模选择布局
小型集群资源有限时,可以让 3 个节点同时承担主节点候选、数据和预处理角色。这样成本最低,但节点故障、复杂聚合或大量 pipeline 会相互影响,因此更适合开发、测试或低负载生产环境。
中型集群通常拆出 3 个专用主节点候选节点,业务节点专注保存数据和执行搜索。若写入 pipeline 较轻,可继续由数据节点兼任 ingest;只有协调压力明显时再增加专用协调节点。
大型集群应按瓶颈拆分角色:主节点候选节点保持稳定,数据节点按热、温等数据层扩容,预处理节点按写入吞吐扩容,协调节点按并发查询和聚合结果规模扩容。角色拆分的依据是资源冲突,而不是节点数量本身。
| 集群阶段 | 推荐起点 | 主要考虑 |
|---|---|---|
| 开发或低负载 | 3 个混合角色节点 | 成本低、部署简单 |
| 中等生产规模 | 3 个专用主节点候选 + 3 个以上数据节点 | 隔离集群管理与业务负载 |
| 高并发或大数据量 | 在中等布局上按瓶颈增加 ingest、协调或数据层节点 | 分别扩展写入、查询与存储能力 |
配置角色并验证
下面是 elasticsearch.yml 的片段示例。每个配置片段应放到对应节点自己的配置文件中,节点名称和网络参数需要按实际环境补齐。
主节点候选节点片段:
node.name: master-1
node.roles: [ master ] # 只参与集群管理
数据节点片段:
node.name: data-1
node.roles: [ data, ingest ] # 保存分片,并兼任预处理
专用协调节点片段:
node.name: coord-1
node.roles: [] # 不保存数据,也不参与选主
这些配置生效后,重启对应节点,并通过节点接口检查角色。以下请求可在 Kibana Dev Tools 中执行。
GET /_nodes?filter_path=nodes.*.name,nodes.*.roles预期结果为 HTTP 200,响应体类似:
{
  "nodes": {
    "<ID-1>": {
      "name": "master-1",
      "roles": ["master"]
    },
    "<ID-2>": {
      "name": "data-1",
      "roles": ["data", "ingest"]
    },
    "<ID-3>": {
      "name": "coord-1",
      "roles": []
    }
  }
}
实际节点 ID 和返回顺序可能不同,但角色数组应与配置一致。若某个节点仍显示旧角色,优先检查是否修改了正确的配置目录,以及节点是否真正完成重启并重新加入集群。
常见规划错误
不要把客户端请求直接长期压到专用主节点候选节点,否则大量连接、序列化和聚合结果会干扰集群状态发布。主节点稳定性通常比其吞吐量更重要。
也不要在节点很少时过早拆出大量专用角色。只有 4 个节点却分别设置主、数据、ingest 和协调角色,会造成资源闲置和单点瓶颈。先使用混合角色,再根据监控到的 CPU、堆内存、磁盘和线程池压力拆分,通常更稳妥。
本课总结
- 主节点候选负责集群管理,数据节点承担主要存储与计算
- ingest 和专用协调节点应在对应链路出现明确瓶颈后再拆分
- 节点布局应随规模和资源冲突演进,而不是机械地一角色一节点
下一课预告
下一课将进入分片路由与副本机制,跟踪一条文档从路由定位、主分片写入到副本同步和查询分发的完整过程。