
NoSQL 与搜索 / 系统课时
自动补全
自动补全
本课将完成一个可运行的商品词自动补全索引:用户输入前缀后,Elasticsearch 按补全词权重返回候选项,并通过分类与区域上下文限制结果范围。
学习目标
- 使用
completion字段建立低延迟前缀补全。 - 设计补全词、权重与上下文数据。
- 验证补全结果并识别内存、分片和去重成本。
自动补全解决什么问题
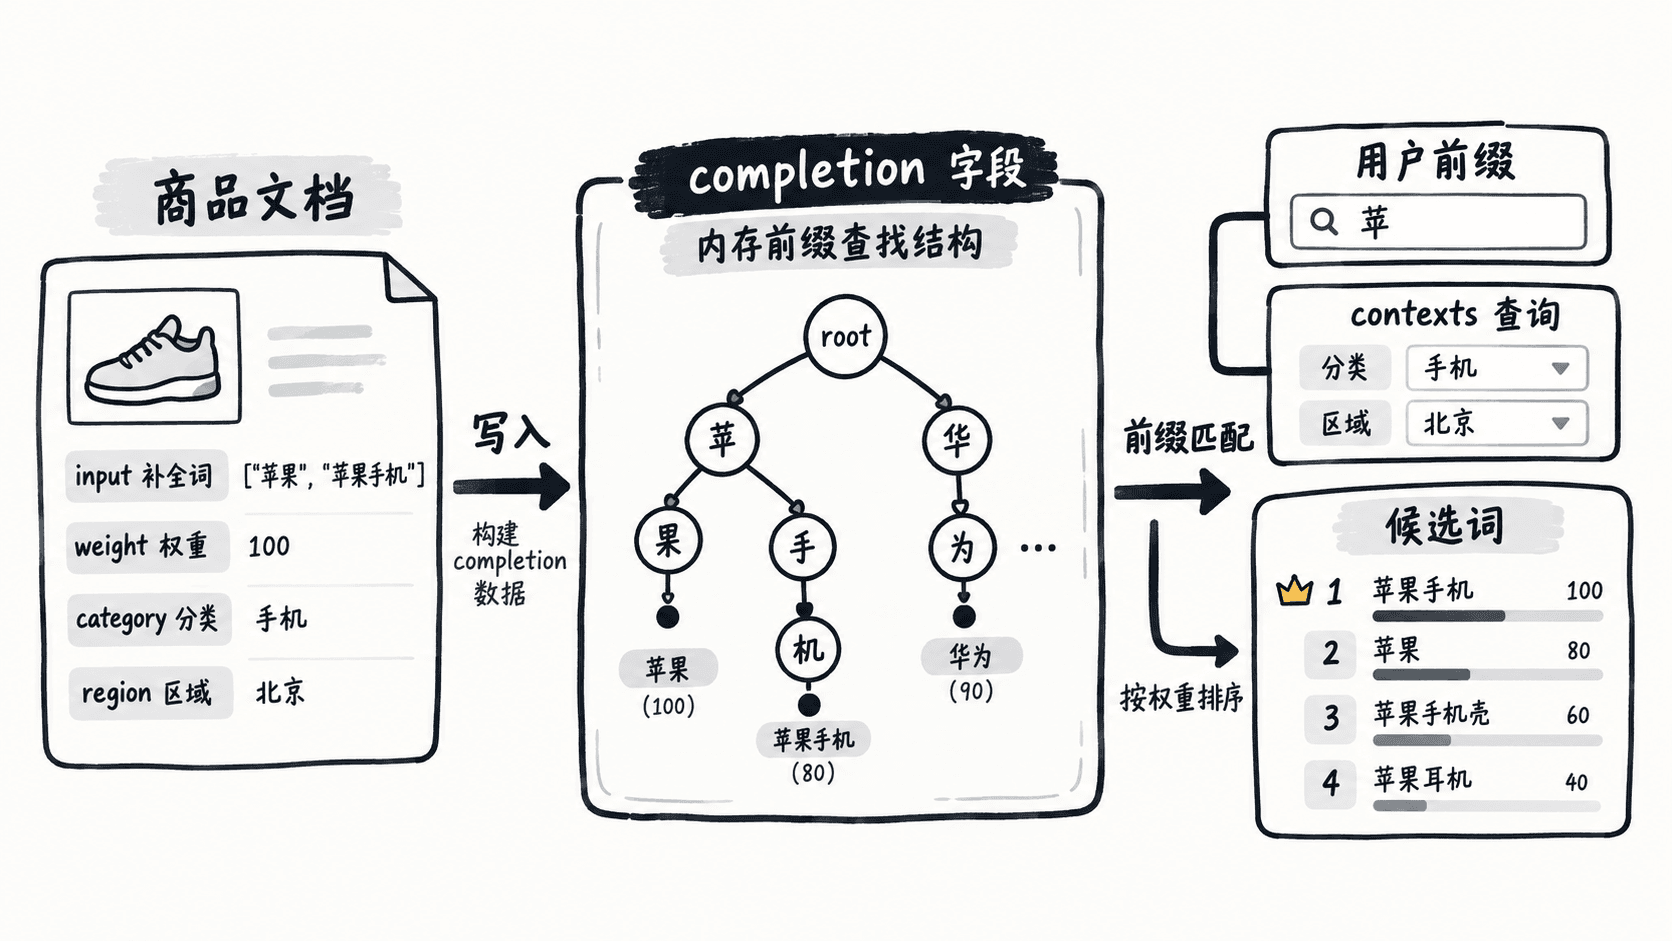
自动补全的目标不是搜索完整文档,而是在用户尚未输完时给出可点击的导航词,例如输入“无线”后返回“无线耳机”和“无线充电器”。completion suggester 为前缀查找优化,适合热门查询词、商品名、品牌名和固定入口;它不等同于拼写纠错,也不能替代最终的全文检索。:contentReference[oaicite:0]{index=0}
补全数据通常由三个部分组成:input 保存可匹配的词形,weight 决定基础排序,contexts 按业务维度过滤或加权。上下文可使用分类或地理类型;本例使用分类上下文表达商品分类和服务区域。:contentReference[oaicite:1]{index=1}
建立补全索引
下面的命令可直接在已启动的 Elasticsearch 环境中执行。示例把上下文绑定到文档中的 category 和 region 字段,因此写入文档时必须同时提供这两个值。
curl -X PUT "http://localhost:9200/products-completion?filter_path=acknowledged,shards_acknowledged,index" \
  -H "Content-Type: application/json" \
  -d '{
    "settings": {
      "number_of_shards": 1
    },
    "mappings": {
      "properties": {
        "name": { "type": "keyword" },
        "category": { "type": "keyword" },
        "region": { "type": "keyword" },
        "suggest": {
          "type": "completion",
          "contexts": [
            { "name": "category", "type": "category", "path": "category" },
            { "name": "region", "type": "category", "path": "region" }
          ]
        }
      }
    }
  }'

curl -X PUT "http://localhost:9200/products-completion/_doc/1?refresh=true&filter_path=_index,_id,_version,result" \
  -H "Content-Type: application/json" \
  -d '{
    "name": "无线耳机",
    "category": "electronics",
    "region": "MY",
    "suggest": {
      "input": ["无线耳机", "蓝牙耳机"],
      "weight": 100
    }
  }'

curl -X PUT "http://localhost:9200/products-completion/_doc/2?refresh=true&filter_path=_index,_id,_version,result" \
  -H "Content-Type: application/json" \
  -d '{
    "name": "无线充电器",
    "category": "electronics",
    "region": "MY",
    "suggest": {
      "input": ["无线充电器"],
      "weight": 80
    }
  }'
预期结果:三个请求都返回成功状态;创建索引响应包含 acknowledged: true,两次写入响应的 result 为 created。首次运行时 _version、分片信息等动态字段可能不同。
{"acknowledged":true,"shards_acknowledged":true,"index":"products-completion"}
{"_index":"products-completion","_id":"1","_version":1,"result":"created"}
{"_index":"products-completion","_id":"2","_version":1,"result":"created"}
input 可以放同一业务对象的多个别名,但不要把整段商品描述塞入补全字段。weight 应来自稳定的业务信号,例如人工优先级、有效搜索量或转化率,并设置合理上限,避免短期热点长期压制其他候选。
查询前缀与上下文
启用上下文映射后,查询时也要提供上下文。下面只返回马来西亚电子商品中的“无线”前缀,并过滤重复文本。
curl -X POST "http://localhost:9200/products-completion/_search?filter_path=suggest.product-suggest.options.text,suggest.product-suggest.options._score" \
  -H "Content-Type: application/json" \
  -d '{
    "suggest": {
      "product-suggest": {
        "prefix": "无线",
        "completion": {
          "field": "suggest",
          "size": 5,
          "skip_duplicates": true,
          "contexts": {
            "category": ["electronics"],
            "region": ["MY"]
          }
        }
      }
    }
  }'
预期输出如下。候选项先受上下文约束,再按补全权重排序。
{
  "suggest": {
    "product-suggest": [
      {
        "options": [
          { "text": "无线耳机", "_score": 100.0 },
          { "text": "无线充电器", "_score": 80.0 }
        ]
      }
    ]
  }
}
size 控制返回数量,skip_duplicates 可去除来自不同文档的同名候选,但开启后可能需要访问更多候选才能凑足结果,因此会增加查询成本。:contentReference[oaicite:2]{index=2}
设计权重与上下文
权重应表达“同一上下文中的推荐顺序”,而不是把所有业务规则都塞进一个整数。常见做法是定期离线计算热度分,再由运营优先级做小幅修正;库存、权限和区域等硬条件则放进上下文或业务层过滤。
上下文会增加补全索引体积,并占用更多堆内存。补全查询跨多个分片时还需要额外阶段汇总候选,因此小型补全词库通常优先使用单分片;数据量过大或堆压力明显时,再按容量进行拆分。:contentReference[oaicite:3]{index=3}
提示:补全词变更依赖重新索引对应文档。高频统计不宜在每次用户输入后直接改权重,可按小时或按天批量更新,避免写入放大。
验收与常见问题
验收时至少检查相同前缀的排序、不同上下文的隔离、别名命中和空结果处理。若查询没有候选,依次确认字段类型是否为 completion、文档是否已刷新、前缀是否匹配 input、索引与查询是否都提供了必需上下文。
若同名候选仍重复,检查是否设置 skip_duplicates: true;若响应变慢,则减少候选数量、控制重复数据,并观察索引统计中的 completion 大小。自动补全接口还应由前端增加约 150~300 毫秒防抖,避免每次按键都立即发起请求。
本课总结
completion适合低延迟前缀导航,不负责完整全文检索或通用拼写纠错。input决定可匹配词形,weight决定基础顺序,contexts负责业务范围过滤或提升。- 补全速度以额外索引和堆内存为代价,应控制词量、重复项与分片数量。
下一课预告
下一课将实现真正的边输入边搜索,比较 search_as_you_type 与自定义边缘分词在召回、索引体积和维护成本上的差异。