
NoSQL 与搜索 / 系统课时
构建搜索请求
构建搜索请求
本课把页面上的关键词、筛选项、排序、分页和高亮要求转换成一个可执行的 Java 搜索请求。完成后,你能够用官方 Java API Client 的查询构建器生成结构清晰、边界可控的 SearchRequest。
学习目标
- 区分全文查询、精确过滤、排序和分页各自的职责
- 使用 Java API Client 组合
bool、高亮与总数统计 - 处理页码、字段映射和深度分页等关键边界
从业务条件拆分查询职责
构建请求时,不要把所有条件都塞进同一种查询。关键词需要参与相关性计算,应放入 must;分类、状态和价格区间只负责缩小结果集,适合放入 filter。排序、分页和高亮属于搜索请求的独立部分,不应混入查询表达式。
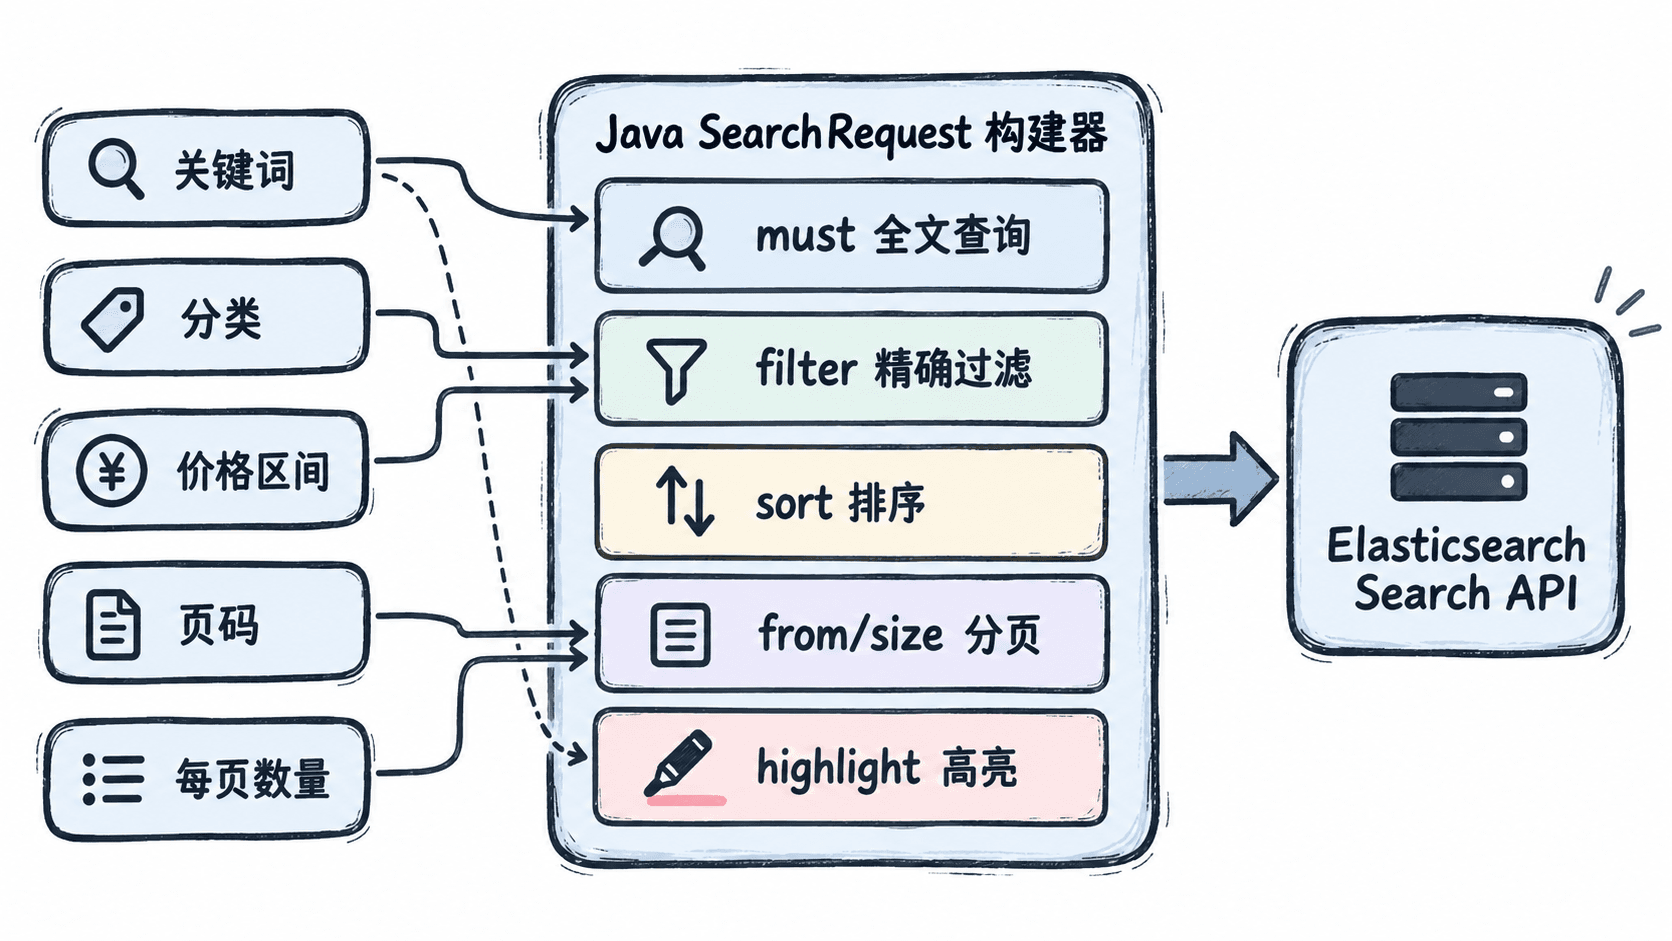
这种拆分让请求更容易扩展。以后增加品牌或库存状态时,只需追加过滤条件;调整排序或高亮时,也不会破坏原有查询逻辑。
使用 Java API Client 组合请求
下面示例假设索引名为 products,name 和 description 是全文字段,category.keyword 是精确值字段,price 与 sales 是数值字段。示例使用 co.elastic.clients.elasticsearch 包下的官方 Java API Client。
package example.search;

import co.elastic.clients.elasticsearch._types.SortOrder;
import co.elastic.clients.elasticsearch._types.query_dsl.MultiMatchQuery;
import co.elastic.clients.elasticsearch._types.query_dsl.Operator;
import co.elastic.clients.elasticsearch._types.query_dsl.Query;
import co.elastic.clients.elasticsearch._types.query_dsl.RangeQuery;
import co.elastic.clients.elasticsearch._types.query_dsl.TermQuery;
import co.elastic.clients.elasticsearch.core.SearchRequest;

public final class SearchRequestFactory {

    public record Criteria(
            String keyword,
            String category,
            double minPrice,
            double maxPrice,
            int pageNo,
            int pageSize) {
    }

    public SearchRequest build(Criteria criteria) {
        if (criteria.pageNo() < 1 || criteria.pageSize() < 1 || criteria.pageSize() > 100) {
            throw new IllegalArgumentException("pageNo must be >= 1 and pageSize must be 1..100");
        }

        Query textQuery = MultiMatchQuery.of(m -> m
                .fields("name^2", "description")
                .query(criteria.keyword())
                .operator(Operator.And)
        )._toQuery();

        Query categoryFilter = TermQuery.of(t -> t
                .field("category.keyword")
                .value(criteria.category())
        )._toQuery();

        Query priceFilter = RangeQuery.of(r -> r
                .number(n -> n
                        .field("price")
                        .gte(criteria.minPrice())
                        .lte(criteria.maxPrice()))
        )._toQuery();

        return SearchRequest.of(s -> s
                .index("products")
                .query(q -> q.bool(b -> b
                        .must(textQuery)
                        .filter(categoryFilter, priceFilter)))
                .from((criteria.pageNo() - 1) * criteria.pageSize())
                .size(criteria.pageSize())
                .sort(so -> so.field(f -> f
                        .field("sales")
                        .order(SortOrder.Desc)))
                .highlight(h -> h
                        .preTags("<mark>")
                        .postTags("</mark>")
                        .fields("name", f -> f.numberOfFragments(0))
                        .fields("description", f -> f
                                .fragmentSize(80)
                                .numberOfFragments(1)))
                .trackTotalHits(t -> t.enabled(true)));
    }

    public static void main(String[] args) {
        Criteria criteria = new Criteria("Java 搜索", "book", 20, 200, 1, 10);
        SearchRequest request = new SearchRequestFactory().build(criteria);

        System.out.println("index=" + request.index().get(0));
        System.out.println("page=" + request.from() + "," + request.size());
        System.out.println("sortCount=" + request.sort().size());
        System.out.println("hasHighlight=" + (request.highlight() != null));
    }
}
预期输出如下。这里验证的是请求对象的关键组成,实际命中文档需要连接已有 Elasticsearch 集群后调用 client.search(request, ProductDocument.class)。
index=products
page=0,10
sortCount=1
hasHighlight=true
name^2 表示标题字段获得更高权重;Operator.And 要求分词后的查询词全部满足。分类与价格使用 filter,不会参与评分,且更符合精确筛选的语义。
处理排序、分页与高亮边界
字段排序会覆盖默认的纯相关性顺序,因此应先确认业务究竟要“最相关”还是“销量最高”。需要保留评分时,可以增加 _score 作为次级排序;对没有文档值的 text 字段直接排序会失败,应改用对应的 keyword 子字段。
from 与 size 适合普通页码分页,但默认结果窗口通常只允许访问前 10000 条。面向持续滚动或大结果集时,应改用 search_after,并提供稳定且唯一的排序组合,例如业务时间加文档 ID。
高亮字段必须与查询字段和映射匹配。前后标签只负责标记片段,Web 层仍需按安全策略渲染,不能因为内容来自 Elasticsearch 就直接信任其中的 HTML。
验证请求是否符合预期
联调前先检查页码换算、字段名和排序方向,再在测试索引执行请求。需要精确总数时启用 trackTotalHits;只展示“超过某数量”时可使用阈值统计,避免无条件计算全部命中数。
还应为非法价格区间、空关键词和超大页长定义明确策略。示例选择直接拒绝非法页码,实际项目也可以在控制器层完成校验,让请求工厂只处理已经合法的条件。
本课总结
- 全文条件放入
must,精确筛选放入filter,排序和分页保持独立 - Java 查询构建器应同时完成字段权重、高亮、页码换算和总数策略
- 深度分页、字段类型与高亮渲染是上线前必须验证的边界
下一课预告
下一课将读取 SearchResponse,把命中、总数、评分、高亮片段和聚合桶转换成稳定的应用层响应对象。