
NoSQL 与搜索 / 系统课时
Elasticsearch 核心能力
Elasticsearch 核心能力
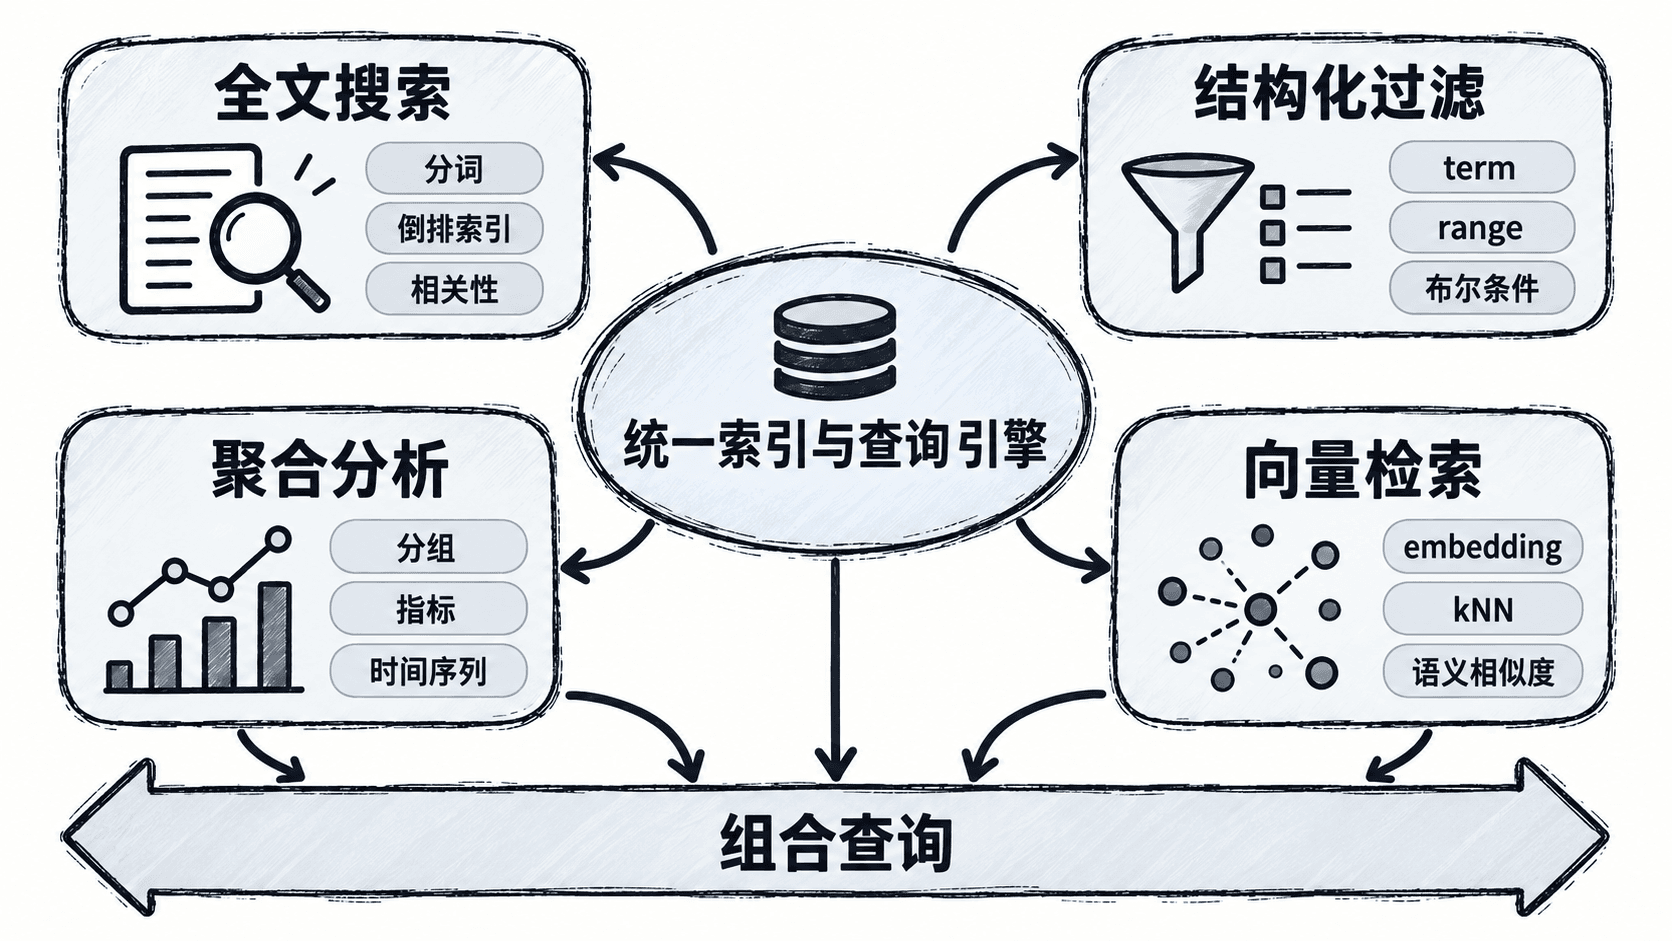
Elasticsearch 将文本搜索、精确过滤、聚合统计和向量相似度检索统一在一套查询体系中。理解这四类能力及其边界,可以帮助你判断一个需求应使用关键词匹配、条件过滤、指标聚合,还是语义检索,并为后续设计索引和查询语句建立清晰框架。
学习目标
- 说明 Elasticsearch 四类核心能力各自解决的问题
- 理解全文搜索、过滤与聚合在一次查询中的协作方式
- 区分关键词检索、向量检索和混合搜索的适用场景
四类能力如何协作
全文搜索负责理解和匹配文本,结构化过滤负责限定精确范围,聚合分析负责从命中文档中计算指标,向量检索负责寻找语义相近的内容。它们可以单独使用,也可以组合在一次请求中。
全文搜索与相关性
全文搜索不是简单判断字段是否包含某个字符串。Elasticsearch 会先通过分析器把文本拆成词项,再利用倒排索引寻找候选文档,并根据 BM25 等相关性算法计算 _score。标题、正文等字段还可以设置不同权重,使核心字段对排序产生更大影响。
下面是片段示例,依赖已经存在的 products 索引,且索引中包含 name、category 和 price 字段:
{
  "query": {
    "bool": {
      "must": [
        {
          "match": {
            "name": "无线耳机"
          }
        }
      ],
      "filter": [
        {
          "term": {
            "category.keyword": "audio"
          }
        },
        {
          "range": {
            "price": {
              "lte": 500
            }
          }
        }
      ]
    }
  },
  "aggs": {
    "brands": {
      "terms": {
        "field": "brand.keyword"
      }
    }
  }
}
该查询会先用 match 计算“无线耳机”的文本相关性,再用 term 和 range 排除不符合分类与价格条件的文档,最后按品牌生成分组统计。验证时可将请求体提交到 POST /products/_search,检查 hits.hits 的排序和 aggregations.brands.buckets 的分组结果。
结构化过滤与聚合分析
结构化过滤适合状态、类型、时间、数值范围和标识符等明确条件。过滤条件通常不参与相关性评分,结果可以被缓存,因此比把所有条件都放入评分查询更稳定。
聚合分析建立在匹配结果之上,可以完成分组计数、最大值、平均值、百分位和日期直方图。例如日志平台可以先过滤最近一小时的错误日志,再按服务名统计数量,并计算接口延迟的百分位分布。一次请求就能同时返回文档列表和统计结果。
向量检索与混合搜索
向量检索先把文本、图片或其他内容转换成高维向量,再使用 kNN 查找距离最近的文档。它更擅长处理“意思相近但用词不同”的查询,例如用户搜索“适合通勤的降噪设备”,仍能找到标题中没有这些完整词语的耳机产品。
关键词检索对专有名词、编号和精确短语更可靠,向量检索对自然语言和语义相似度更敏感。实际系统常使用混合搜索:先分别获得关键词得分与向量相似度,再按权重融合或重新排序,以兼顾精确性和召回率。
能力边界与使用原则
Elasticsearch 的核心优势是面向搜索和分析的分布式索引,但它不是强事务关系数据库。索引映射、分词器和字段类型会直接影响后续查询,错误设计可能导致重建索引。
使用时应先明确字段是用于全文搜索、精确过滤、聚合还是向量计算,再选择合适的类型和查询。业务数据库继续保存权威数据,Elasticsearch 保存可重建的查询副本,这样才能兼顾一致性、搜索性能和运维成本。
本课总结
- Elasticsearch 统一支持全文搜索、结构化过滤、聚合分析和向量检索
- 全文查询负责相关性,过滤负责精确范围,聚合负责统计,向量检索负责语义相似度
- 真实项目常组合多种能力,并让业务数据库保存权威数据、Elasticsearch 承担查询职责
下一课预告
下一课将进入 Elasticsearch 的基础架构,理解节点、集群、索引、分片和副本之间的关系,以及这些概念如何影响扩展性与可用性。