
NoSQL 与搜索 / 系统课时
商品索引结构设计
商品索引结构设计
商品索引既要支持标题相关性搜索,也要承担分类筛选、品牌聚合、价格排序、属性组合过滤和库存判断。本课从查询需求反推字段类型,完成一份可直接创建、写入并验证的商品映射。
学习目标
- 根据搜索、过滤、排序和聚合用途选择字段类型
- 正确建模商品属性中的成对关系
- 创建商品索引并验证核心查询结果
从查询需求反推字段
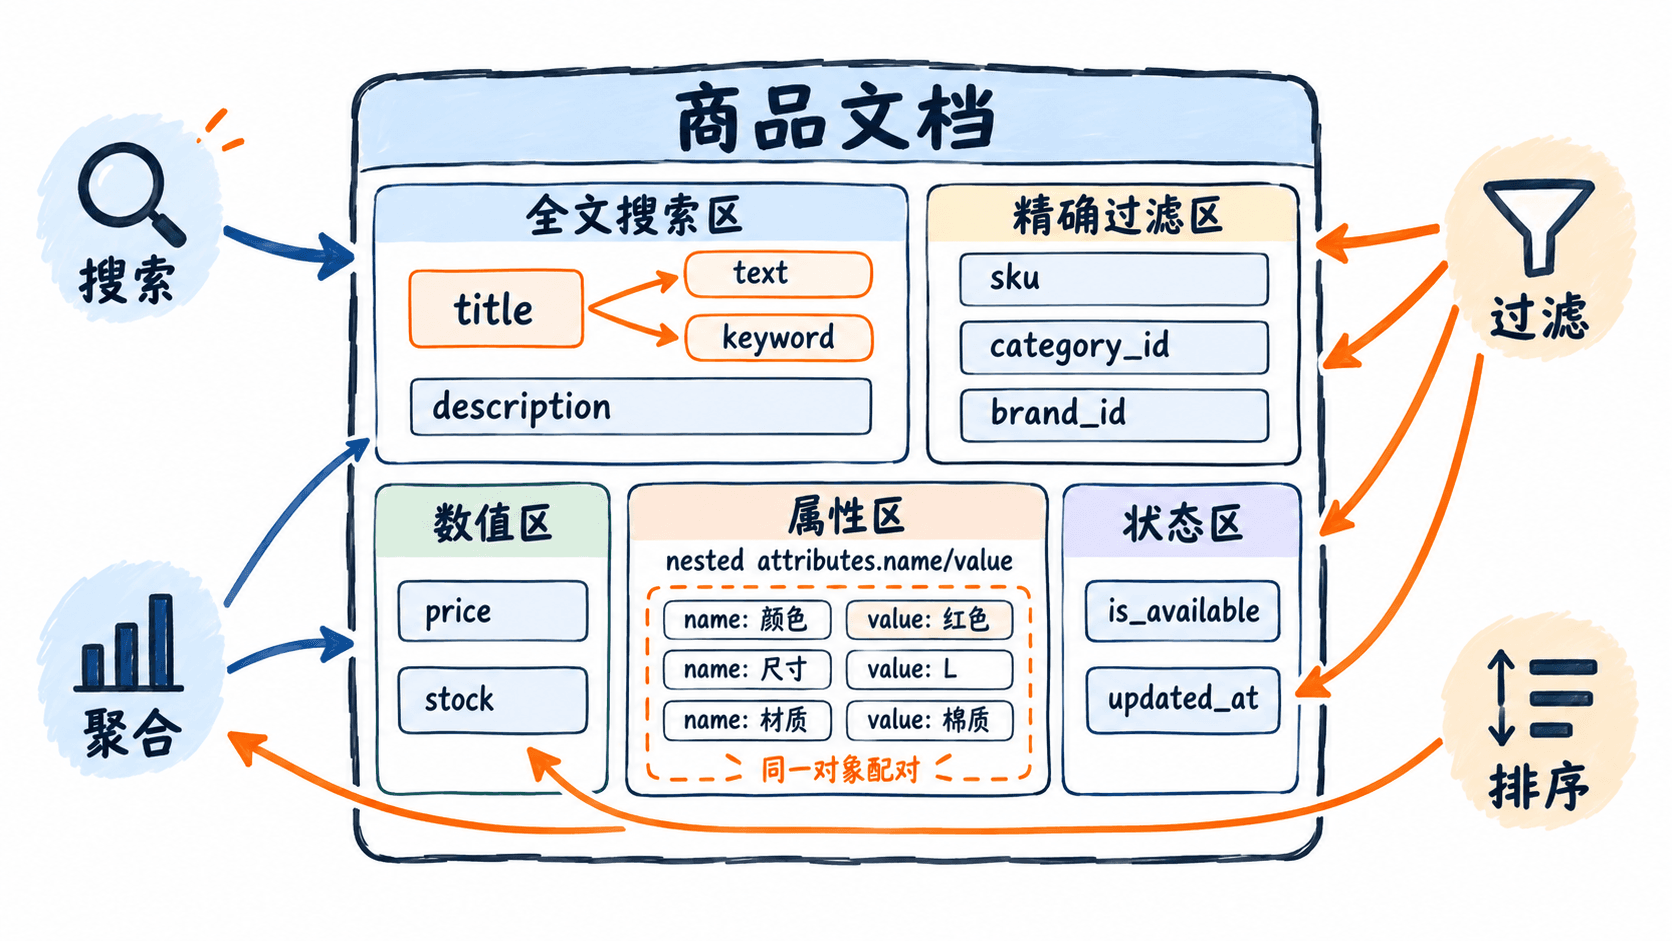
商品字段不能只按原始数据类型映射,还要考虑查询方式。标题需要分词检索,应使用 text;商品编号、分类和品牌用于精确过滤或聚合,应使用 keyword。同一个字符串需要兼顾全文搜索与精确操作时,可以使用多字段,将主字段设为 text,再增加 keyword 子字段。:contentReference[oaicite:4]{index=4}
价格需要范围过滤、排序和统计。若业务金额固定保留两位小数,可以使用 scaled_float 并设置 scaling_factor: 100,底层按缩放后的整数保存。库存数量使用 integer,是否可售使用 boolean,更新时间使用 date。:contentReference[oaicite:5]{index=5}
设计属性与库存边界
商品属性通常是多个名称和值的组合,例如“颜色=黑色”和“容量=20L”。如果使用普通 object 数组,内部字段会被扁平化,名称和值之间的对象边界可能丢失;需要保证同一组属性配对查询时,应使用 nested。
库存字段要明确语义。本例把 stock 定义为商品当前可售总量,把 is_available 定义为可售状态。若未来需要按仓库筛选库存,应新增独立的 nested 仓库库存结构,而不是不断创建 stock_warehouse_001 一类动态字段。
创建商品索引
下面的映射将根级设为 strict,避免拼写错误静默进入索引。示例使用 Elasticsearch 内置分析能力,能够直接运行;中文生产环境若需要更细粒度分词,应先确定集群已安装且兼容的分析器,再通过新索引迁移映射。
PUT /products-v1
{
  "mappings": {
    "dynamic": "strict",
    "properties": {
      "product_id": {
        "type": "keyword"
      },
      "sku": {
        "type": "keyword"
      },
      "title": {
        "type": "text",
        "fields": {
          "raw": {
            "type": "keyword",
            "ignore_above": 256
          }
        }
      },
      "description": {
        "type": "text"
      },
      "category_id": {
        "type": "keyword"
      },
      "category_path": {
        "type": "keyword"
      },
      "brand_id": {
        "type": "keyword"
      },
      "price": {
        "type": "scaled_float",
        "scaling_factor": 100
      },
      "attributes": {
        "type": "nested",
        "properties": {
          "name": {
            "type": "keyword"
          },
          "value": {
            "type": "keyword"
          }
        }
      },
      "stock": {
        "type": "integer"
      },
      "is_available": {
        "type": "boolean"
      },
      "updated_at": {
        "type": "date"
      }
    }
  }
}
预期结果:
{
  "acknowledged": true,
  "shards_acknowledged": true,
  "index": "products-v1"
}
写入一条商品文档
category_path 直接保存分类路径上的多个 ID,便于按任一级分类过滤。attributes 中每个对象只表达一组名称和值,后续查询必须使用 nested 查询保持配对关系。
POST /products-v1/_doc/p-1001?refresh=true
{
  "product_id": "p-1001",
  "sku": "BAG-20L-BLK",
  "title": "轻量旅行背包 20L 黑色",
  "description": "适合城市通勤与短途旅行的轻量背包",
  "category_id": "bags",
  "category_path": ["outdoor", "bags"],
  "brand_id": "northwind",
  "price": 399.00,
  "attributes": [
    {
      "name": "color",
      "value": "black"
    },
    {
      "name": "capacity",
      "value": "20L"
    }
  ],
  "stock": 25,
  "is_available": true,
  "updated_at": "2026-08-03T05:00:00+08:00"
}
预期结果:
HTTP 201
result 为 created,文档 ID 为 p-1001。
refresh=true 只用于本课立即验证搜索结果;高并发写入场景不应在每次请求上强制刷新,否则会增加刷新开销。
验证搜索、过滤与聚合
下面的查询同时完成标题匹配、品牌过滤、价格范围过滤、属性配对过滤,并按品牌聚合。attributes 是 nested 类型,因此必须在独立的 nested 查询中指定路径。
POST /products-v1/_search
{
  "size": 10,
  "query": {
    "bool": {
      "must": [
        {
          "match": {
            "title": "旅行背包"
          }
        }
      ],
      "filter": [
        {
          "term": {
            "brand_id": "northwind"
          }
        },
        {
          "range": {
            "price": {
              "gte": 300,
              "lte": 500
            }
          }
        },
        {
          "nested": {
            "path": "attributes",
            "query": {
              "bool": {
                "filter": [
                  {
                    "term": {
                      "attributes.name": "color"
                    }
                  },
                  {
                    "term": {
                      "attributes.value": "black"
                    }
                  }
                ]
              }
            }
          }
        }
      ]
    }
  },
  "aggs": {
    "brands": {
      "terms": {
        "field": "brand_id"
      }
    }
  }
}
预期结果:
HTTP 200
hits.total.value 为 1。
brands 聚合包含 key=northwind、doc_count=1。
若要按属性名称和值分别聚合,需要使用 nested 聚合进入 attributes 路径;普通根级聚合无法直接按嵌套文档的语义统计。:contentReference[oaicite:6]{index=6}
设计时的关键边界
不要把标题只映射为 keyword,否则无法获得常规全文检索的分词与相关性能力;也不要直接在 text 字段上做排序和聚合,应使用 title.raw 或独立的 keyword 字段。
不要为每个属性名创建一个顶级字段。商品类目不断增加时,这种方式会造成字段数量膨胀。固定且高频的属性可以显式建模,通用属性采用 nested 键值对;只做精确检索且键集合极不稳定时,再评估 flattened。
本课总结
- 字段类型应由查询用途决定:
text负责全文搜索,keyword负责精确过滤与聚合,数值类型负责范围和排序 - 需要保持名称和值配对的属性数组应使用
nested - 根级严格映射、稳定字段命名和明确库存语义,是商品索引可长期演进的基础
下一课预告
下一课将基于商品映射设计搜索请求,组合关键词、过滤条件、排序和聚合,形成可供前端调用的商品检索接口。