
NoSQL 与搜索 / 系统课时
近邻向量查询
近邻向量查询
本课将用一个可执行的 Elasticsearch 示例完成 kNN 向量检索,并说明 k、num_candidates 与 filter 分别控制什么。完成后,你能从“召回多少候选、最终返回多少结果、在哪个阶段过滤”三个角度调试检索质量。
学习目标
- 使用
dense_vector字段和knn参数发起近邻查询 - 区分
k、num_candidates与size的职责 - 正确使用预过滤条件限制向量检索范围
kNN 查询怎样得到结果
kNN 查询接收一个查询向量,在已建立向量索引的 dense_vector 字段中寻找最相近的文档。Elasticsearch 使用近似近邻结构减少全量计算,因此通常能以较低延迟处理大量向量,但结果质量会受到候选规模影响。
查询会在每个分片中探索最多 num_candidates 个候选,再保留局部最优结果并在协调节点合并。k 表示希望保留的最近邻数量,size 控制响应实际返回的命中条数;简单检索中通常让 size 与 k 相同。knn.filter 是预过滤,会在近邻搜索过程中限制可参与匹配的文档,而不是先取一批结果再事后删除。:contentReference[oaicite:0]{index=0}
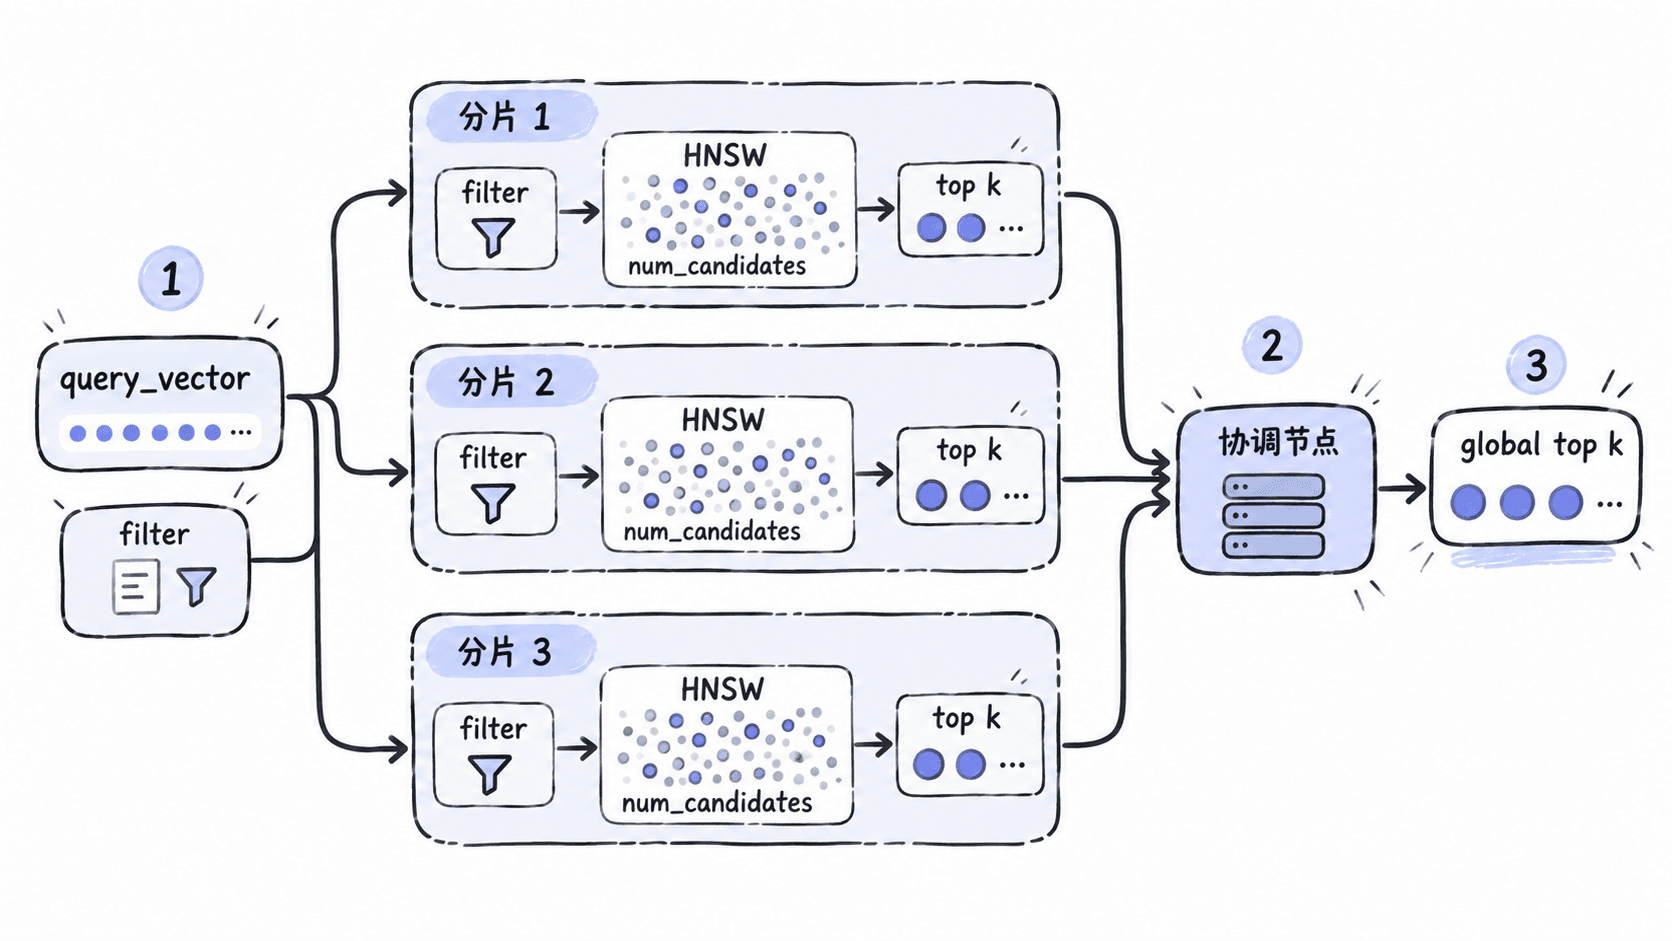
完成一次带过滤的近邻查询
下面的命令创建一个二维向量索引,写入三篇示例文章,再查询与 [1.0, 0.0] 最接近且分类为 tech 的两篇文档。示例假设本地 Elasticsearch 无鉴权;实际环境需要补充 HTTPS、用户名和密码。
ES_URL="${ES_URL:-http://localhost:9200}"

curl -sS -X DELETE "$ES_URL/vector-articles" >/dev/null 2>&1 || true

curl -sS -f -o /dev/null -X PUT "$ES_URL/vector-articles" \
  -H 'Content-Type: application/json' \
  -d '{
    "mappings": {
      "properties": {
        "title": {"type": "keyword"},
        "category": {"type": "keyword"},
        "embedding": {
          "type": "dense_vector",
          "dims": 2,
          "index": true,
          "similarity": "cosine"
        }
      }
    }
  }'

curl -sS -f -o /dev/null -X POST "$ES_URL/vector-articles/_bulk?refresh=true" \
  -H 'Content-Type: application/x-ndjson' \
  --data-binary $'{"index":{"_id":"a"}}\n{"title":"向量检索入门","category":"tech","embedding":[1.0,0.0]}\n{"index":{"_id":"b"}}\n{"title":"语义搜索实践","category":"tech","embedding":[0.8,0.2]}\n{"index":{"_id":"c"}}\n{"title":"城市旅行指南","category":"life","embedding":[0.0,1.0]}\n'

curl -sS -X POST \
  "$ES_URL/vector-articles/_search?filter_path=hits.hits._score,hits.hits._source" \
  -H 'Content-Type: application/json' \
  -w '\nHTTP_STATUS:%{http_code}\n' \
  -d '{
    "size": 2,
    "_source": ["title", "category"],
    "knn": {
      "field": "embedding",
      "query_vector": [1.0, 0.0],
      "k": 2,
      "num_candidates": 3,
      "filter": {
        "term": {"category": "tech"}
      }
    }
  }'
预期结果
{"hits":{"hits":[
  {"_score":<POSITIVE_SCORE_1>,"_source":{"title":"向量检索入门","category":"tech"}},
  {"_score":<POSITIVE_SCORE_2>,"_source":{"title":"语义搜索实践","category":"tech"}}
]}}
HTTP_STATUS:200

城市旅行指南不会进入响应体,因为它不满足 knn.filter。
两个 _score 都是正浮点数,具体值可能因 Elasticsearch 版本和向量索引实现而略有差异。这里的查询向量必须与字段维度一致,否则请求会失败。embedding 已启用索引,因此可以执行近似 kNN;若字段设置为 index: false,只能改用脚本评分等精确扫描方式。
调整候选数量与过滤条件
num_candidates 必须不小于 k,并且是按分片计算的候选数量。提高它通常能增加找到真实最近邻的概率,但会读取更多向量并增加延迟;降低它可以换取速度,却可能漏掉更优结果。Elastic 当前文档还规定该值不能超过 10000。:contentReference[oaicite:1]{index=1}
过滤条件越严格,可参与搜索的文档越少。应优先把租户、权限、状态、地区等硬约束放入 knn.filter,避免返回无权访问或业务上无效的文档。不要用 post_filter 替代它:后过滤可能删掉已经选出的邻居,导致最终结果少于预期。
调参时先固定测试集和查询向量,记录召回率与延迟,再逐步增大 num_candidates。不要只看单次响应时间,也要观察不同分片数量、并发量和过滤选择性下的稳定表现。
本课总结
k决定目标邻居数量,num_candidates决定每个分片探索的候选规模knn.filter在近邻搜索阶段执行,适合放置权限和业务硬约束- 增大候选数量通常提高召回质量,但会消耗更多计算时间
下一课预告
下一课将比较余弦相似度、点积和欧氏距离,解释同一组向量为何会因评分方式不同而产生不同排序。