
NoSQL 与搜索 / 系统课时
商品索引与分析器设计
商品索引与分析器设计
本课把搜索需求落成一个可创建、可验证的商品索引。你将完成字段类型、多字段、中文索引与查询分析器、筛选字段和业务排序字段的设计,并通过 Elasticsearch 接口验证索引是否按预期生效。
学习目标
- 为全文检索、精确筛选和业务排序选择正确字段类型
- 区分索引分析器与查询分析器的职责
- 创建并验证一份可用于商品搜索的索引映射
按查询方式设计字段
字段类型应由“怎样查询”决定,而不是由原始数据库类型直接决定。商品标题需要分词检索,应使用 text;品牌、状态和类目用于精确过滤,应使用 keyword;价格、销量、评分和库存用于范围过滤或排序,应使用数值类型。
标题通常同时需要全文检索和精确聚合,因此可通过多字段结构保留 title 与 title.keyword。金额建议使用整数最小货币单位或 scaled_float,避免浮点比较误差。业务排序字段必须在写入时规范空值,否则排序结果会随缺失值处理规则发生变化。
设计中文分析链路
商品标题在写入时需要较细粒度的分词,以提高召回率;用户查询通常需要较保守的分词,以减少无关匹配。因此可使用不同的 analyzer 和 search_analyzer。本例采用 IK 分词器,前提是所有 Elasticsearch 节点都已安装与集群版本完全匹配的 IK 插件。
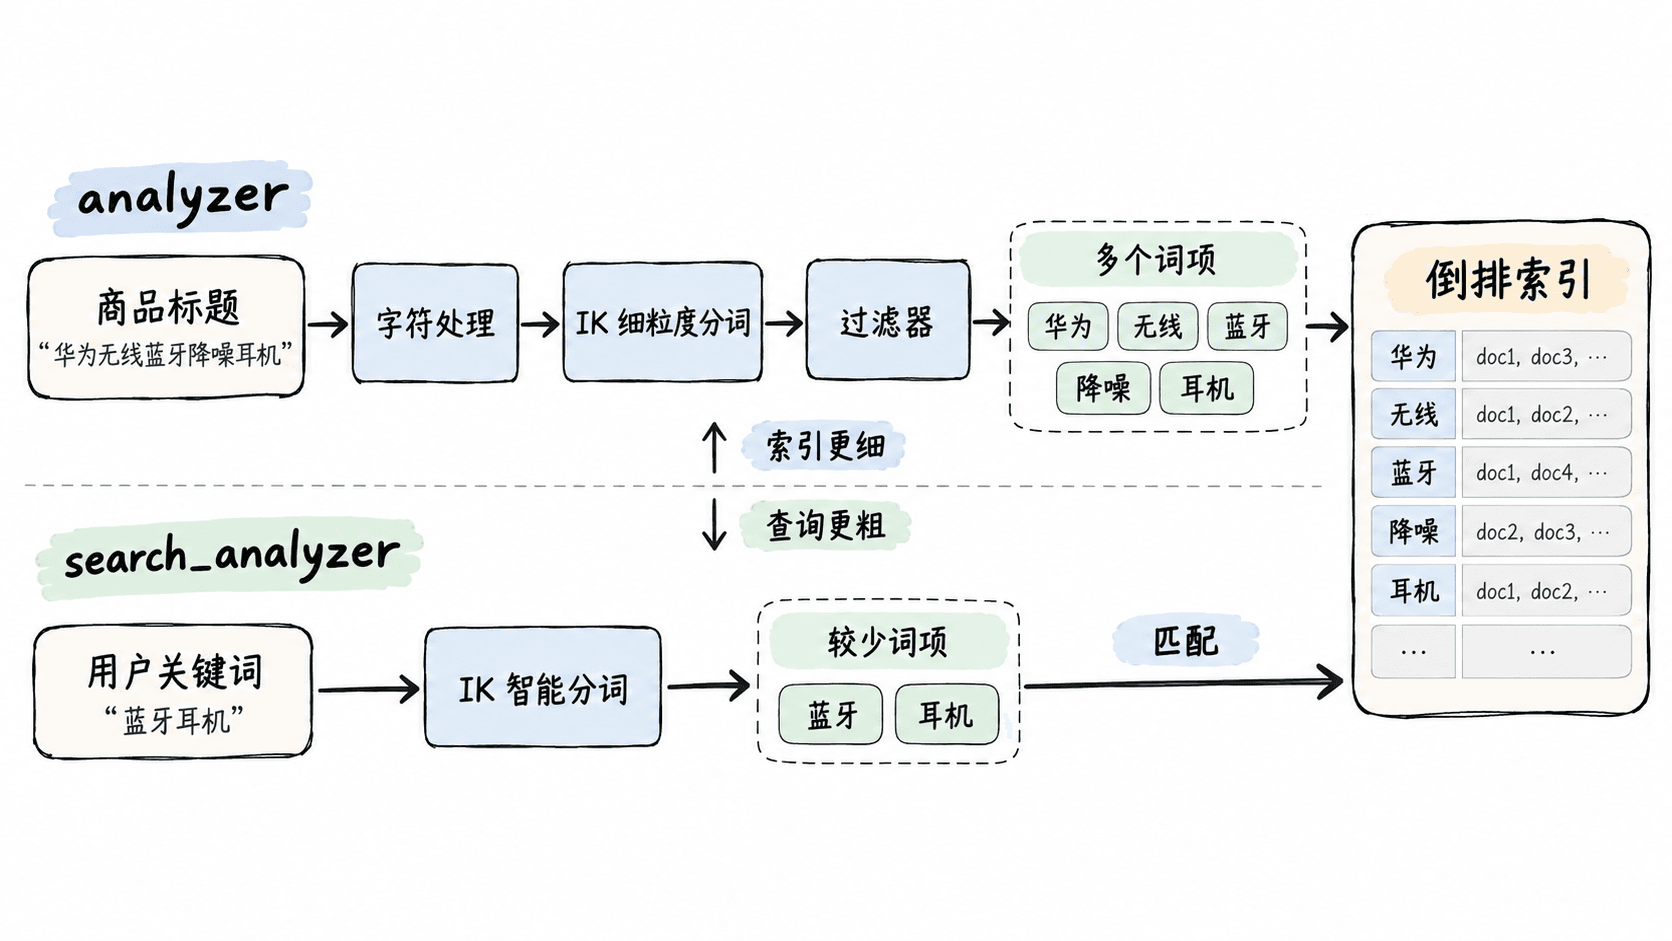
分析器一旦用于已有字段,其分词结果已经写入倒排索引,后续不能靠修改映射直接重算。需要改变分词规则时,应新建版本化索引、重新写入数据,再通过别名切换流量。
创建商品索引
下面的请求可直接在 Kibana Dev Tools 中执行。示例使用 dynamic: strict 阻止未知字段静默进入索引,并为搜索、过滤、排序和补全保留最小必要字段。
PUT /products_v1
{
  "settings": {
    "number_of_shards": 1,
    "number_of_replicas": 1,
    "analysis": {
      "analyzer": {
        "product_index_analyzer": {
          "type": "custom",
          "tokenizer": "ik_max_word",
          "filter": ["lowercase"]
        },
        "product_search_analyzer": {
          "type": "custom",
          "tokenizer": "ik_smart",
          "filter": ["lowercase"]
        }
      }
    }
  },
  "mappings": {
    "dynamic": "strict",
    "properties": {
      "productId": {
        "type": "keyword"
      },
      "title": {
        "type": "text",
        "analyzer": "product_index_analyzer",
        "search_analyzer": "product_search_analyzer",
        "fields": {
          "keyword": {
            "type": "keyword",
            "ignore_above": 128
          }
        }
      },
      "brandId": {
        "type": "keyword"
      },
      "categoryIds": {
        "type": "keyword"
      },
      "tags": {
        "type": "keyword"
      },
      "price": {
        "type": "long"
      },
      "sales": {
        "type": "long"
      },
      "rating": {
        "type": "scaled_float",
        "scaling_factor": 100
      },
      "stock": {
        "type": "integer"
      },
      "status": {
        "type": "keyword"
      },
      "suggest": {
        "type": "completion",
        "analyzer": "simple",
        "preserve_separators": true
      },
      "createdAt": {
        "type": "date"
      }
    }
  }
}
预期结果
{
  "acknowledged": true,
  "shards_acknowledged": true,
  "index": "products_v1"
}
若单节点开发环境没有可分配副本,索引仍可能创建成功,但集群健康状态会是黄色;这不影响映射验证,生产环境则应确保副本可以分配。
验证分析器结果
创建索引后,使用索引级 _analyze 接口验证查询分析器。下面请求可直接执行,返回的具体词项会受 IK 版本和自定义词典影响,因此验收重点是请求成功、tokens 非空且词项符合业务词典预期。
POST /products_v1/_analyze
{
  "analyzer": "product_search_analyzer",
  "text": "无线蓝牙耳机"
}
预期结果
{
  "tokens": [
    {
      "token": "<TOKEN>",
      "start_offset": "<START_OFFSET>",
      "end_offset": "<END_OFFSET>",
      "type": "<TYPE>",
      "position": "<POSITION>"
    }
  ]
}
实际响应中的占位符会被真实值替换。若请求返回“failed to find tokenizer”,说明节点未安装 IK 插件或插件版本不匹配;若分词过细或无法识别品牌词,应调整搜索分析器或维护业务词典,而不是在查询语句中反复拼接同义词。
处理映射边界
text 字段不适合直接排序和聚合,应使用其 keyword 子字段;keyword 字段不会自动分词,不适合承载商品标题全文检索。completion 字段适合前缀补全,但更新成本高于普通 keyword,只应写入确实需要补全的短文本。
索引字段应控制数量并保持稳定。可选属性很多时,不要无条件把所有商品规格展开成顶层字段;需要按规格组合独立查询时,可使用 nested,只做展示时则保留在 _source 或使用受控对象结构。
本课总结
- 字段类型必须按全文检索、精确过滤、范围查询和排序方式选择
- 索引分析器负责召回,查询分析器负责控制查询词粒度
- 分析器变化需要重建索引,并通过版本化索引与别名完成切换
下一课预告
下一课将基于该索引实现关键词检索、条件筛选、业务排序和聚合统计,并对查询结果进行验收。