
NoSQL 与搜索 / 系统课时
语义搜索效果评估
语义搜索效果评估
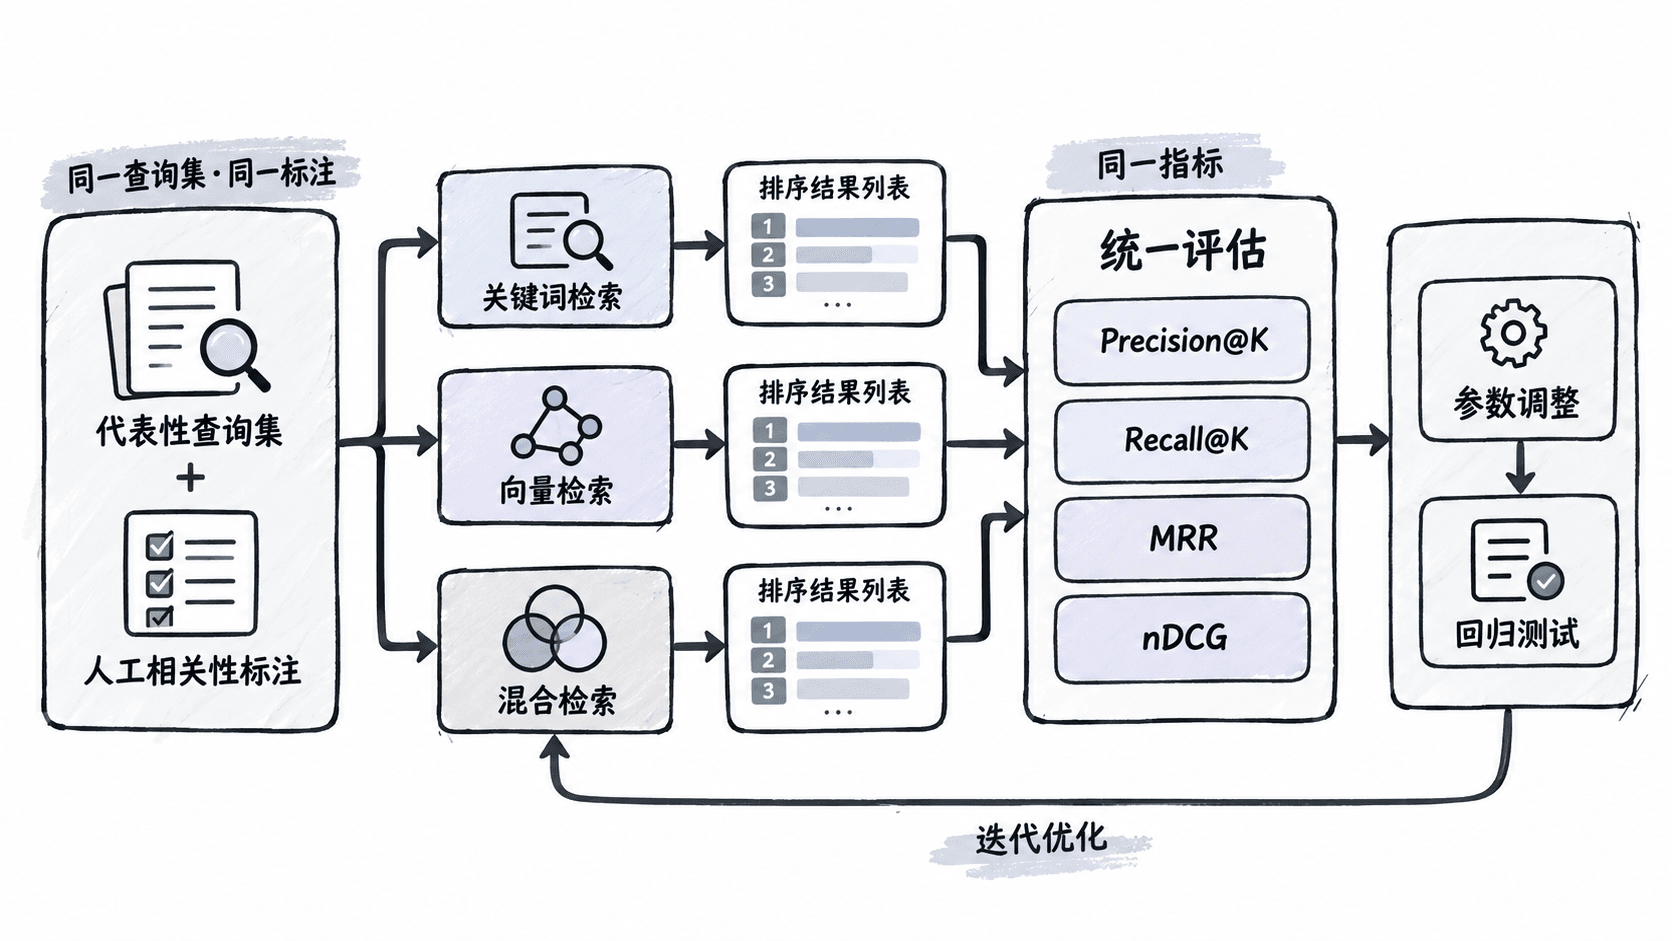
搜索方案不能只凭几条演示查询判断优劣。本课将建立可重复的离线评测集,计算 Precision、Recall、MRR 与 nDCG,并用同一批查询对比关键词、向量和混合检索,避免优化一个场景却损害其他场景。
学习目标
- 设计包含查询、文档和相关性等级的评测集
- 理解常用排序指标分别衡量什么
- 用可运行脚本比较三种检索方案的离线结果
建立可重复的评测集
评测集至少包含三部分:真实或具有代表性的用户查询、每条查询对应的候选文档、人工给出的相关性等级。查询应覆盖精确名称、自然语言问题、同义表达、拼写变化和带过滤条件的业务场景。
相关性可以采用 0~3 四级标注:0 表示无关,1 表示部分相关,2 表示较相关,3 表示高度相关。标注规则必须先写清楚,再由同一标准评审不同方案,不能根据某个方案已经返回的结果临时改变判断。
选择合适的评价指标
Precision@K 表示前 K 条结果中相关文档的比例,适合衡量首页结果是否干净。Recall@K 表示已知相关文档中有多少进入前 K 条,适合关注召回完整性的场景。
MRR 只关注第一条相关结果出现得有多早,适合问答、导航和“找到一个正确答案即可”的查询。nDCG@K 同时考虑相关性等级与排序位置,高相关文档越靠前,得分越高,适合评价带有多级相关性标注的搜索列表。
Elasticsearch 的 _rank_eval API 可以基于典型查询和人工文档评分计算 Precision、Recall、MRR、DCG 等指标;每条测试查询都需要独立的相关性判断。:contentReference[oaicite:1]{index=1}
用脚本对比三种方案
下面的完整 Python 示例模拟两条查询的人工标注,以及关键词、向量和混合检索各自返回的前三名。脚本使用相关性等级计算四项平均指标,可直接保存为 evaluate_search.py 后运行。
import math
from statistics import mean

JUDGMENTS = {
    "q1": {"d1": 3, "d2": 2, "d3": 1, "d4": 0},
    "q2": {"d5": 3, "d6": 2, "d7": 1, "d8": 0},
}

RUNS = {
    "keyword": {
        "q1": ["d1", "d4", "d3"],
        "q2": ["d8", "d5", "d6"],
    },
    "vector": {
        "q1": ["d2", "d3", "d4"],
        "q2": ["d6", "d7", "d8"],
    },
    "hybrid": {
        "q1": ["d1", "d2", "d3"],
        "q2": ["d5", "d6", "d7"],
    },
}

def dcg(doc_ids, grades, k):
    return sum(
        (2 ** grades.get(doc_id, 0) - 1) / math.log2(rank + 2)
        for rank, doc_id in enumerate(doc_ids[:k])
    )

def evaluate(doc_ids, grades, k=3):
    relevant = {doc_id for doc_id, grade in grades.items() if grade >= 1}
    top_k = doc_ids[:k]

    precision = sum(doc_id in relevant for doc_id in top_k) / k
    recall = sum(doc_id in relevant for doc_id in top_k) / len(relevant)
    reciprocal_rank = next(
        (1 / rank for rank, doc_id in enumerate(top_k, start=1)
         if doc_id in relevant),
        0,
    )

    ideal = [
        doc_id
        for doc_id, _ in sorted(
            grades.items(), key=lambda item: item[1], reverse=True
        )
    ]
    ndcg = dcg(top_k, grades, k) / dcg(ideal, grades, k)
    return precision, recall, reciprocal_rank, ndcg

for strategy, query_results in RUNS.items():
    scores = [
        evaluate(query_results[query_id], JUDGMENTS[query_id])
        for query_id in JUDGMENTS
    ]
    averages = [mean(values) for values in zip(*scores)]
    print(
        f"{strategy:8s} "
        f"P@3={averages[0]:.3f} "
        f"R@3={averages[1]:.3f} "
        f"MRR={averages[2]:.3f} "
        f"nDCG@3={averages[3]:.3f}"
    )
预期输出
keyword  P@3=0.667 R@3=0.667 MRR=0.750 nDCG@3=0.714
vector   P@3=0.667 R@3=0.667 MRR=1.000 nDCG@3=0.387
hybrid   P@3=1.000 R@3=1.000 MRR=1.000 nDCG@3=1.000
这个结果只说明当前样例中混合检索最好,不能直接推广到生产环境。真实评测应包含足够多的查询,并记录每类查询的单独指标,防止总体平均分掩盖型号查询、长问句或低频词上的退化。
形成稳定的评估流程
先固定索引快照、嵌入模型版本、查询集和标注集,再分别运行三种方案。每次只修改一个主要变量,例如 num_candidates、字段权重或融合窗口,并保存指标、延迟和参数版本。
离线指标提升后,还要进行线上验证。可观察点击率、首条点击位置、无结果率、查询改写率和搜索后转化,但线上行为会受展示样式、流量来源和位置偏差影响,因此不能完全替代人工相关性评估。
常见错误:只标注某个方案返回的文档,会把其他方案新召回但尚未标注的文档误判为无关。更稳妥的做法是合并多个方案的候选结果,去重后统一盲审。
本课总结
- 公平对比必须使用同一查询集、同一相关性标注和同一指标
- Precision、Recall、MRR 与 nDCG 分别反映结果纯度、召回范围和排序位置
- 离线评测用于快速迭代,最终还应结合线上行为与性能数据验证
下一课预告
下一课将进入搜索系统的综合优化,把检索质量、响应延迟和资源成本放在同一套调优流程中衡量。