
NoSQL 与搜索 / 系统课时
管道聚合
管道聚合
管道聚合不直接扫描原始文档,而是读取其他聚合已经产生的桶或指标,再计算变化量、比例和窗口统计。本课用连续五天的销售数据组合 derivative、bucket_script 与 moving_fn。
学习目标
- 理解普通聚合与管道聚合的执行顺序
- 使用
buckets_path引用同级指标 - 计算日增量、利润率和三日移动平均
管道聚合读取什么数据
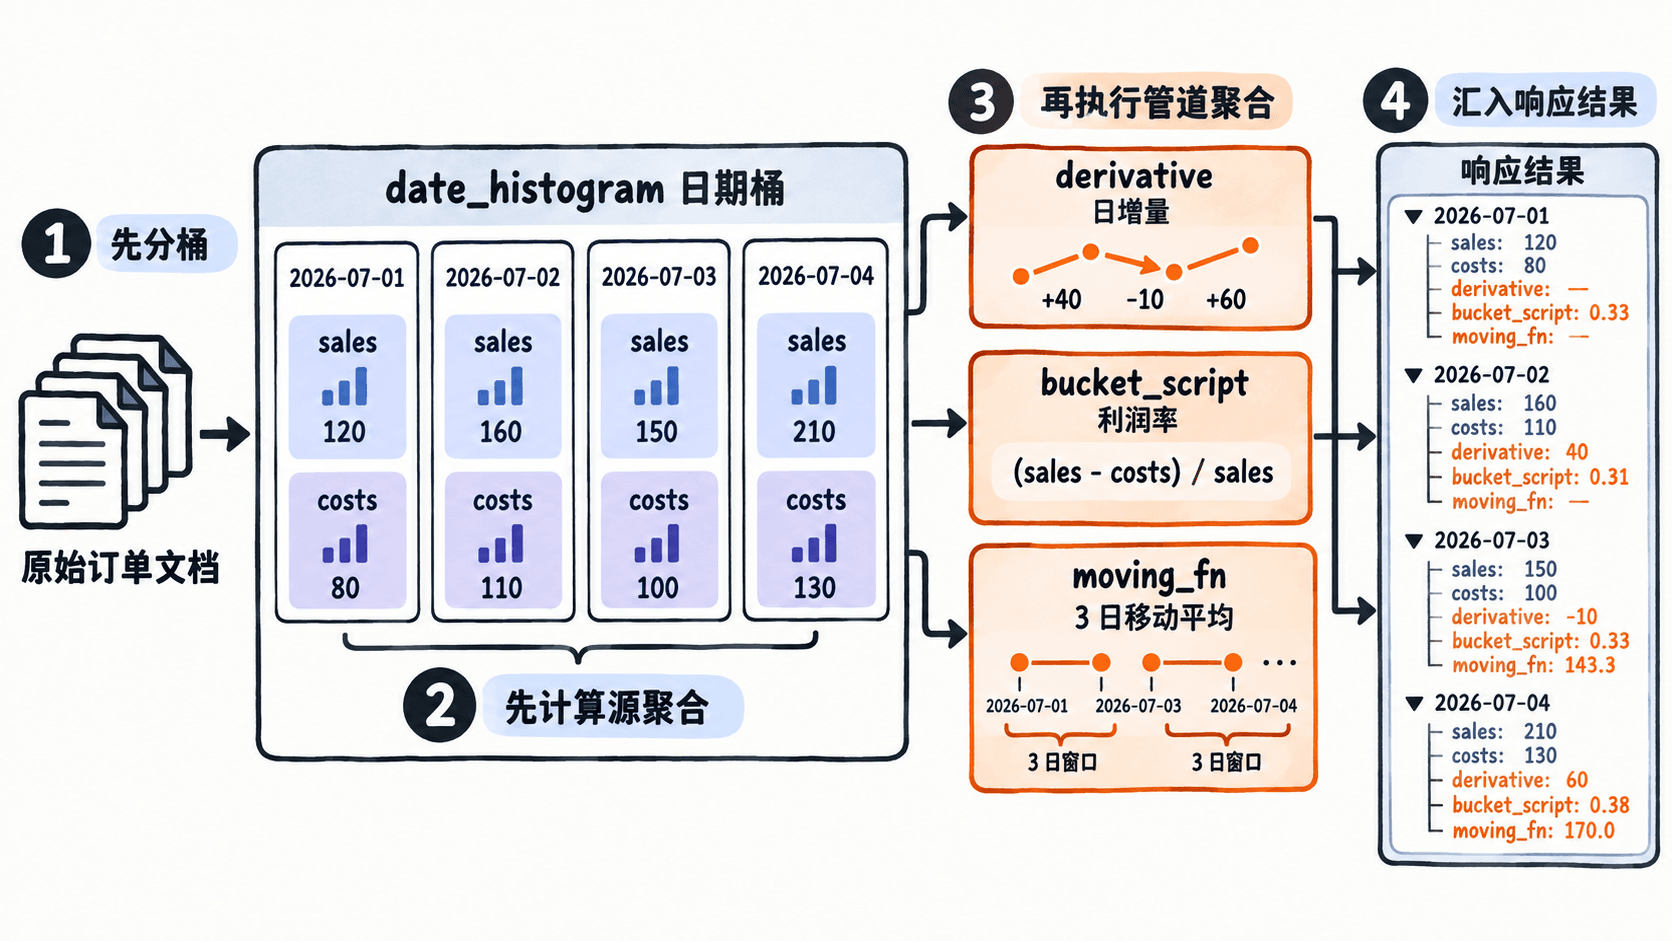
普通指标聚合先从文档中得到销售额、成本等数值,管道聚合随后读取这些结果。它不能替代 sum、avg 等源指标,也不会改变已有桶,只会在响应中追加派生指标。
derivative 需要有顺序的桶,常与 date_histogram 配合;bucket_script 可同时引用多个指标;moving_fn 会在相邻桶组成的窗口上执行脚本。三者都通过 buckets_path 指定输入。
准备连续日期数据
下面创建 daily_orders 索引,并通过 Bulk API 写入五天汇总数据。请把 <PORT> 替换为实际端口。
# 建立日期、销售额和成本字段
curl -s -X PUT "http://localhost:<PORT>/daily_orders" \
  -H 'Content-Type: application/json' \
  -d '{
    "mappings": {
      "properties": {
        "day": { "type": "date", "format": "yyyy-MM-dd" },
        "sales": { "type": "double" },
        "cost": { "type": "double" }
      }
    }
  }'

# Bulk 请求体必须保留最后一个换行
curl -s -X POST "http://localhost:<PORT>/daily_orders/_bulk?refresh=true" \
  -H 'Content-Type: application/x-ndjson' \
  --data-binary @- <<'NDJSON'
{"index":{"_id":"1"}}
{"day":"2026-07-01","sales":1000,"cost":600}
{"index":{"_id":"2"}}
{"day":"2026-07-02","sales":1200,"cost":700}
{"index":{"_id":"3"}}
{"day":"2026-07-03","sales":900,"cost":500}
{"index":{"_id":"4"}}
{"day":"2026-07-04","sales":1500,"cost":900}
{"index":{"_id":"5"}}
{"day":"2026-07-05","sales":1800,"cost":1000}
NDJSON
预期结果
索引 daily_orders 创建成功。
Bulk 响应中的 errors 为 false,五个 index 操作均成功。
在日期桶中定义派生指标
by_day 先创建有序日期桶,sales 与 costs 再计算每个桶的源指标。三个管道聚合必须与被引用指标处于同一个日期桶层级,才能通过相对路径读取结果。
moving_avg_3d 设置 window 为 3,并用 shift: 1 让窗口包含当前桶及前两个桶。利润率脚本先处理销售额为零的边界,再把结果四舍五入到两位小数。
curl -s -X POST "http://localhost:<PORT>/daily_orders/_search" \
  -H 'Content-Type: application/json' \
  -d '{
    "size": 0,
    "aggs": {
      "by_day": {
        "date_histogram": {
          "field": "day",
          "calendar_interval": "day",
          "format": "yyyy-MM-dd",
          "min_doc_count": 0
        },
        "aggs": {
          "sales": {
            "sum": { "field": "sales" }
          },
          "costs": {
            "sum": { "field": "cost" }
          },
          "sales_change": {
            "derivative": {
              "buckets_path": "sales"
            }
          },
          "margin_rate": {
            "bucket_script": {
              "buckets_path": {
                "revenue": "sales",
                "expense": "costs"
              },
              "script": "params.revenue == 0 ? 0 : Math.round(((params.revenue - params.expense) / params.revenue * 100) * 100) / 100.0"
            }
          },
          "moving_avg_3d": {
            "moving_fn": {
              "buckets_path": "sales",
              "window": 3,
              "shift": 1,
              "script": "MovingFunctions.unweightedAvg(values)"
            }
          }
        }
      }
    }
  }'
预期输出中,最后一天的关键桶如下。查询已把日期格式固定为 yyyy-MM-dd,响应中的耗时和分片等动态元数据可能不同。
{
  "key_as_string": "2026-07-05",
  "doc_count": 1,
  "sales": { "value": 1800.0 },
  "costs": { "value": 1000.0 },
  "sales_change": { "value": 300.0 },
  "margin_rate": { "value": 44.44 },
  "moving_avg_3d": { "value": 1400.0 }
}
其中日增量为 ,利润率为 ,三日移动平均为 。
处理空桶与路径错误
derivative 的第一个日期桶没有前一桶,因此不会产生可比较的导数值。若日期中间可能缺失,应让 date_histogram 生成连续空桶,并根据业务决定把缺口跳过还是按零处理,否则变化率可能失真。
buckets_path 引用的是聚合名称,不是字段名称。把路径写成 sales.value 或直接写原字段 sales 都可能导致路径解析错误;本例中的 sales 恰好是指标聚合名称,因此能被管道聚合读取。
管道聚合发生在分桶和源指标计算之后,不能减少前置聚合的扫描成本。若请求创建了大量日期桶,应先限制时间范围,再设置合理的时间间隔和移动窗口。
本课总结
- 管道聚合读取已有聚合结果,不直接处理原始文档
derivative、bucket_script和moving_fn分别适合增量、公式与窗口计算- 正确的桶顺序、作用域和
buckets_path是结果可靠的前提
下一课预告
下一课将继续关注聚合结果的验证与性能控制,学习如何在保证统计含义的同时减少无效桶和计算开销。