
NoSQL 与搜索 / 系统课时
文档与索引模型
文档与索引模型
本课建立 Elasticsearch 的数据模型:从一条 JSON 文档出发,理解字段、索引与映射的职责,并用关系型数据库作对照,避免把“索引”简单等同于“表”。
学习目标
- 说清文档、字段、索引和映射之间的关系
- 读懂一个最小的文档与映射定义
- 区分 Elasticsearch 模型与关系型数据库模型的关键差异
文档、字段与索引
Elasticsearch 以文档作为主要数据单元。一个文档通常表示一个可独立检索的业务对象,例如一本书、一件商品或一篇文章;文档使用 JSON 表示,其中每个键是字段,值可以是字符串、数字、布尔值、日期、对象或数组。
索引是一组结构相近文档的逻辑集合。例如 books 索引可以保存多本文档。写入时,Elasticsearch 不只保存原始 JSON,还会根据字段类型建立倒排索引、列式存储等内部结构,为全文检索、过滤、排序和聚合提供支持。
下面是一条文档数据结构示例,它本身不是完整请求,只用于展示字段组织方式。
{
  "title": "Elasticsearch 入门",
  "author": {
    "name": "李明"
  },
  "price": 59.9,
  "tags": ["搜索", "后端"],
  "publishedAt": "2026-08-03"
}
对象字段可以继续包含子字段,数组也不需要额外声明“数组类型”。不过,同一字段中的多个值应保持兼容的数据类型,否则后续写入可能因映射冲突而失败。
Mapping 如何描述字段
Mapping 是索引的字段结构定义,作用类似于数据模式。它决定字段采用什么类型,以及字符串是否分词、是否可排序、是否参与全文检索。字段首次出现时可以由动态映射推断,但生产系统通常会显式定义关键字段,防止日期、编号或金额被识别成不合适的类型。
{
  "mappings": {
    "properties": {
      "title": {
        "type": "text"
      },
      "author": {
        "properties": {
          "name": {
            "type": "keyword"
          }
        }
      },
      "price": {
        "type": "scaled_float",
        "scaling_factor": 100
      },
      "tags": {
        "type": "keyword"
      },
      "publishedAt": {
        "type": "date"
      }
    }
  }
}这段配置中,title 用于全文检索,author.name 和 tags 适合精确过滤,price 按两位小数缩放存储,publishedAt 按日期解析。配置创建后,可通过查询索引 Mapping 验证字段类型是否符合预期。
与关系型数据库对照
| Elasticsearch | 关系型数据库 | 主要差异 |
|---|---|---|
| 索引 | 表或一组相关表 | 对应关系只是帮助理解,并非完全等价 |
| 文档 | 行 | 文档可以直接包含对象和数组 |
| 字段 | 列 | 字段可被分词,并建立多种检索结构 |
| Mapping | 表结构 | 类型变更通常需要新索引和数据迁移 |
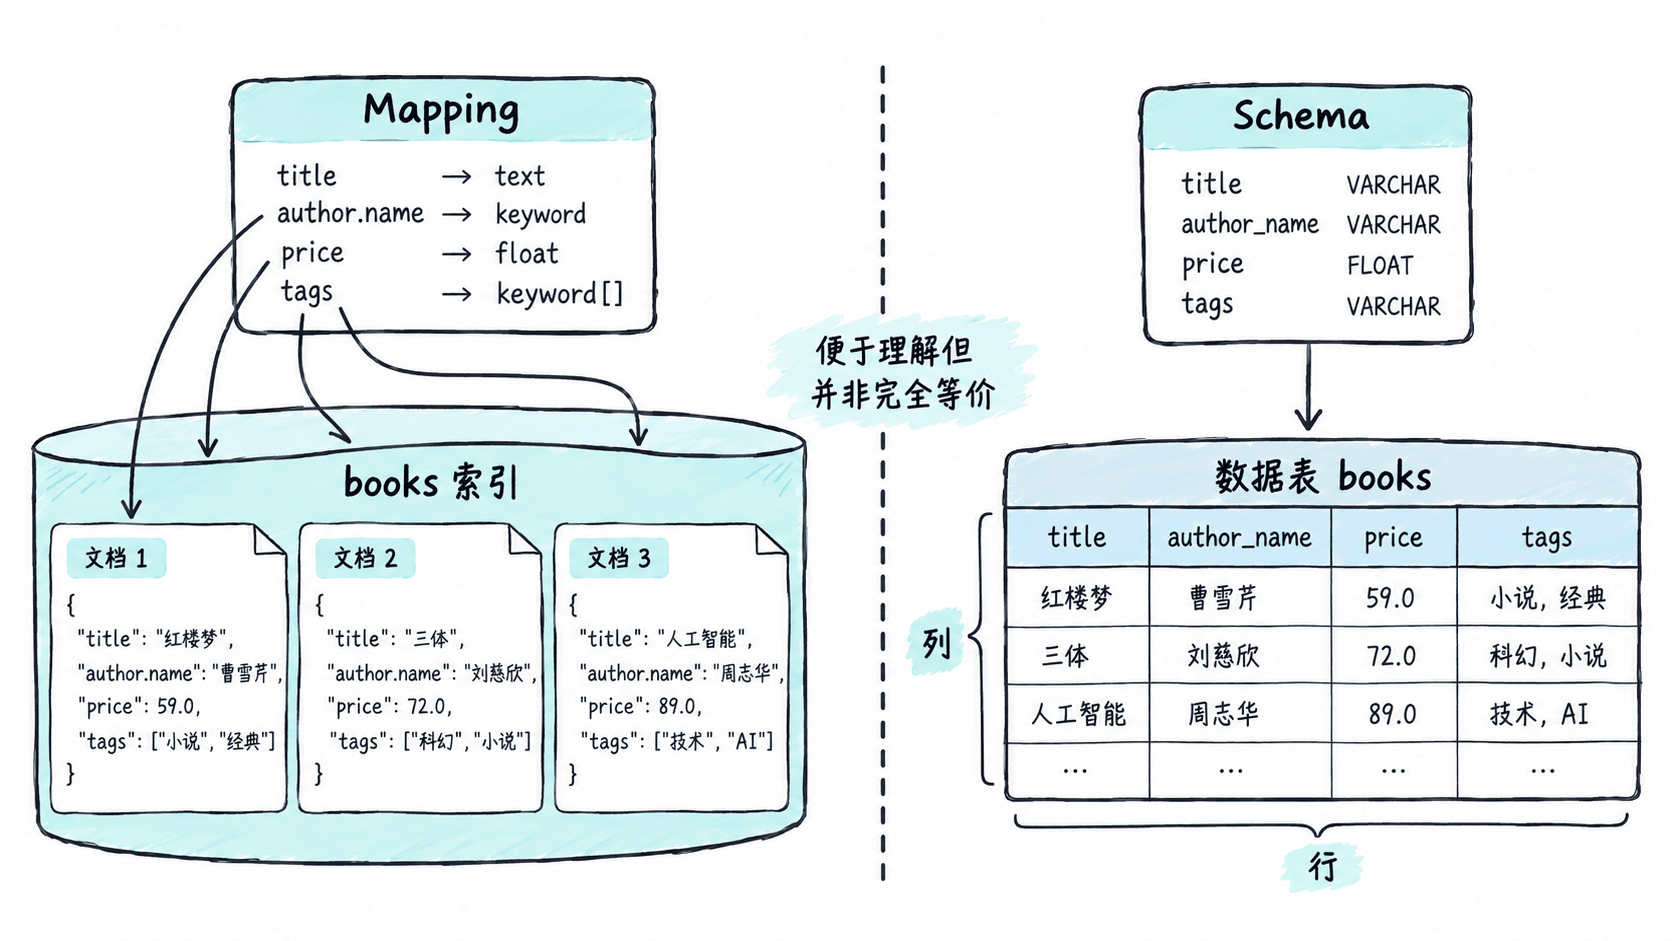
关系型模型倾向通过多张表和关联保持规范化;搜索模型更常把检索所需数据聚合到一条文档中,减少查询阶段的跨表连接。因此,设计文档时应从“用户如何搜索和展示数据”出发,而不是机械复制原有表结构。
易混淆的边界
索引不是传统数据库实例,文档也不是可以任意关联的关系记录。Elasticsearch 支持对象、嵌套对象等结构,但不擅长高频跨实体连接;需要一起搜索和返回的数据,通常应在写入阶段适度冗余。
字段类型一旦产生真实数据,就不能随意原地修改。例如把 keyword 改成 date,通常需要创建新索引、使用正确 Mapping 重新写入数据,再切换别名。模型设计越早明确,后续迁移成本越低。
本课总结
- 索引组织文档,文档由字段组成,Mapping 负责定义字段的索引方式
- Elasticsearch 的索引、文档和字段只能近似对应表、行和列
- 搜索模型应围绕查询需求设计,并谨慎处理字段类型和数据冗余
下一课预告
下一课将沿着一次写入请求,分析缓冲区、刷新、段和提交点如何协作,并解释为什么 Elasticsearch 被称为近实时搜索系统。