
NoSQL 与搜索 / 系统课时
Ingest Pipeline
Ingest Pipeline
Ingest Pipeline 可以在文档写入索引前执行一组处理器,把清洗、转换和补充逻辑集中在 Elasticsearch 写入链路中。本课将创建一条可运行的流水线,并通过模拟接口验证每个字段的最终结果。
学习目标
- 说明 Ingest Pipeline 在文档写入链路中的位置
- 使用常见处理器完成字段清洗、转换与补充
- 通过
_simulate和失败处理验证流水线行为
Pipeline 位于写入链路哪里
客户端提交文档后,Elasticsearch 先执行指定 Pipeline 中的处理器,再把处理后的 _source 写入目标索引。处理器按声明顺序运行,前一步产生的字段可以被后一步继续使用。
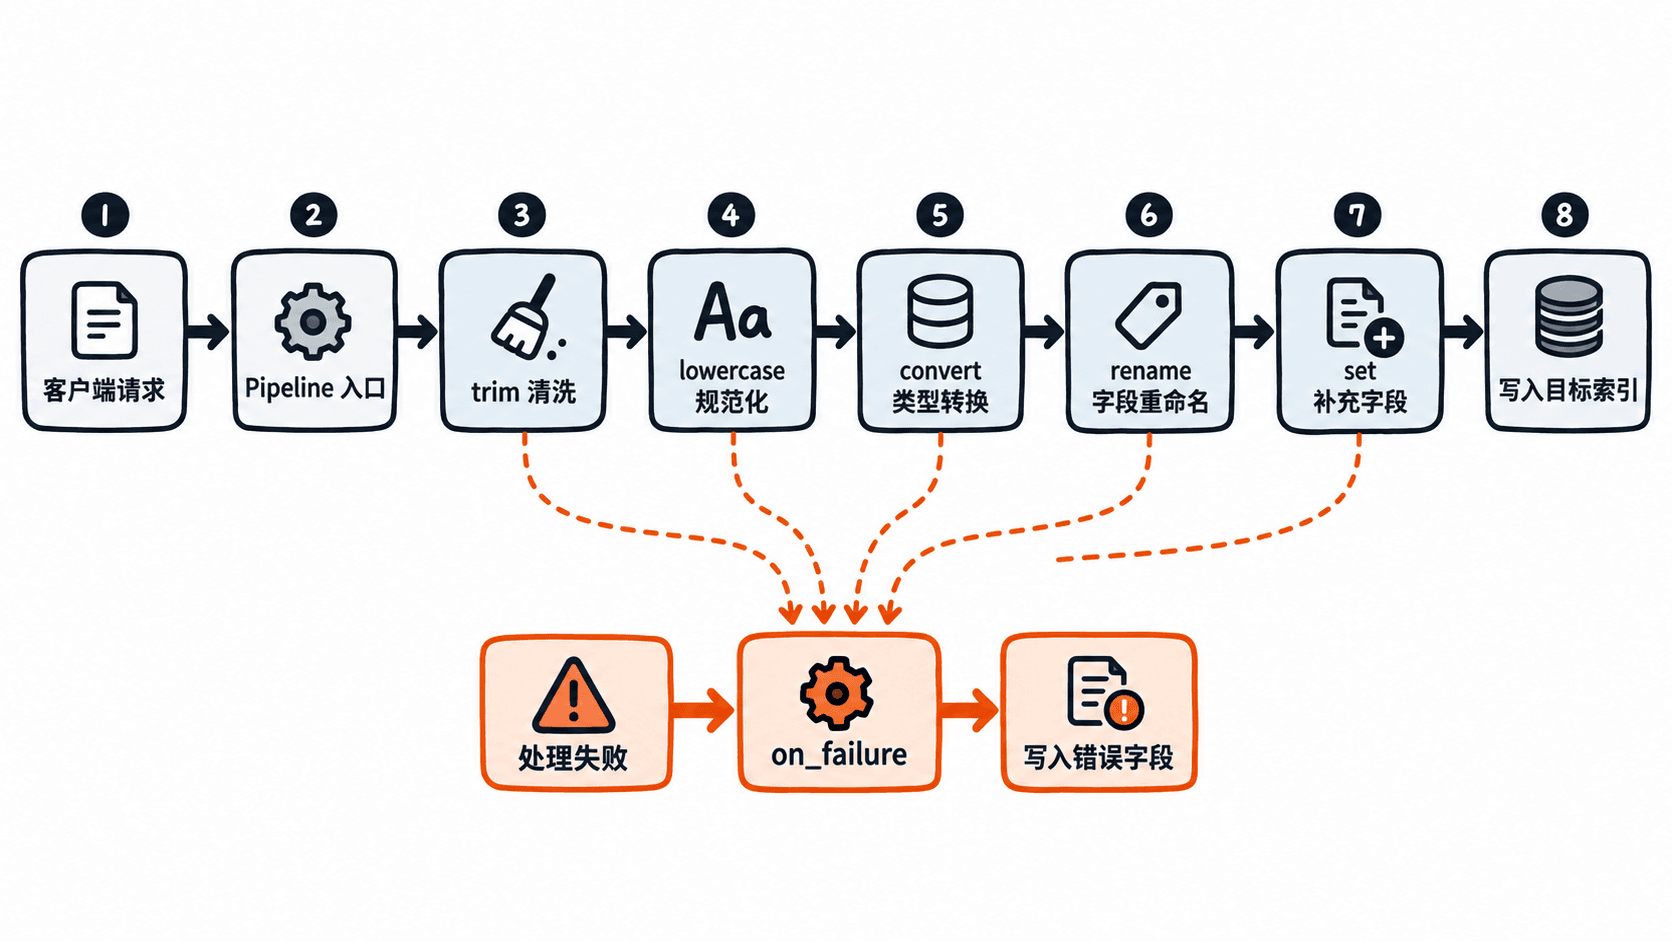
Pipeline 适合处理与单条文档直接相关、执行成本较低的转换,例如去除首尾空格、统一大小写、修改字段名、转换数字类型和补充固定来源。复杂关联查询或长耗时计算应放在应用、流处理或 ETL 系统中。
创建字段清洗流水线
下面的请求可在 Kibana Dev Tools 中执行。流水线依次清理标题、统一分类大小写、把价格转换为浮点数、重命名时间字段,并补充处理来源。
PUT _ingest/pipeline/product-normalize
{
  "description": "Normalize product documents before indexing",
  "processors": [
    {
      "trim": {
        "field": "title"
      }
    },
    {
      "lowercase": {
        "field": "category"
      }
    },
    {
      "convert": {
        "field": "price",
        "type": "double"
      }
    },
    {
      "rename": {
        "field": "created_at",
        "target_field": "createdAt",
        "ignore_missing": true
      }
    },
    {
      "set": {
        "field": "ingestedBy",
        "value": "product-normalize"
      }
    }
  ],
  "on_failure": [
    {
      "set": {
        "field": "ingestError",
        "value": "{{ _ingest.on_failure_message }}"
      }
    }
  ]
}
预期结果
{
  "acknowledged": true
}
processors 中的顺序就是执行顺序。ignore_missing 允许缺少 created_at 的文档继续处理,而顶层 on_failure 会在任一处理器失败后记录错误信息,便于后续检索和补偿。
使用模拟接口验证结果
创建后不要立即接入真实写入流量,先调用 _simulate。模拟接口不会把文档写入索引,适合检查字段名称、数据类型和处理顺序。
POST _ingest/pipeline/product-normalize/_simulate
{
  "docs": [
    {
      "_source": {
        "title": "  Wireless Mouse  ",
        "category": "ACCESSORIES",
        "price": "99.50",
        "created_at": "2026-08-03T05:00:00+08:00"
      }
    }
  ]
}
预期结果(仅列出响应中稳定的 _source 内容)
{
  "title": "Wireless Mouse",
  "category": "accessories",
  "price": 99.5,
  "createdAt": "2026-08-03T05:00:00+08:00",
  "ingestedBy": "product-normalize"
}
结果表明,原始字符串价格已经变为数值,分类被转为小写,字段名完成迁移,标题两端空格被删除。模拟响应中的索引元数据和处理时间可能因环境而不同,因此验证时应重点检查 _source。
在写入请求中指定 Pipeline
流水线不会自动作用于所有索引。写入时可以通过 pipeline 参数显式指定,也可以在索引设置中配置默认流水线。下面的请求使用固定文档 ID,重复执行时会更新同一条文档。
PUT products/_doc/1?pipeline=product-normalize
{
  "title": "  Wireless Mouse  ",
  "category": "ACCESSORIES",
  "price": "99.50",
  "created_at": "2026-08-03T05:00:00+08:00"
}
预期结果(动态序列号字段省略)
{
  "_index": "products",
  "_id": "1",
  "result": "created"
}
首次写入通常返回 created;若文档 ID 已存在,再次执行可能返回 updated。可以通过 GET products/_doc/1 检查保存后的 _source 是否与模拟结果一致。
处理失败与控制边界
convert 遇到无法转换的字符串时会失败。例如价格为 "unknown",顶层 on_failure 会停止后续正常处理器,并把错误信息写入 ingestError。这能保留问题文档,但是否允许它进入正式索引,需要结合业务要求决定。
关键字段不合法时,通常应使用 fail 处理器拒绝写入;非关键字段缺失时,可使用 ignore_missing、ignore_failure 或条件表达式降低影响。不要无条件吞掉所有错误,否则脏数据会在索引中持续积累。
Pipeline 更新后只影响后续写入,不会自动重处理历史文档。历史数据需要通过重新索引或更新任务再次经过新 Pipeline,变更前应先用代表性样本执行 _simulate 回归验证。
本课总结
- Ingest Pipeline 在写入索引前按顺序处理单条文档的
_source trim、lowercase、convert、rename和set可覆盖常见清洗需求- 上线前应使用
_simulate验证,并通过on_failure明确失败后的处理策略
下一课预告
下一课将继续完善数据采集链路,关注批量写入、失败重试与同步任务的可观测性。